تحلیل داده با هوش مصنوعی برای بسیاری از دانشجویان تحصیلات تکمیلی یعنی پرسیدن تفسیر یک جدول SPSS از ChatGPT. اما این تنها گوشهٔ کوچکی از ماجراست. پیش از هر آزمون آماری، پژوهشگر باید دادهها را از منابع مختلف جمع کند، خطاها و ناهماهنگیها را پیدا کند، متغیرها را یکسان کند و با تحلیل اکتشافی، تصویری اولیه از الگوها به دست آورد. این مراحل وقتگیر، خستهکننده و پرخطا هستند؛ و دقیقاً همینجاست که ابزارهای هوشمند بیشترین کمک را میکنند.
این مقاله بر پایهٔ ایدههای فصل ۵ کتاب Using AI in Academic Writing and Research (Springer, 2025) با عنوان «هوش مصنوعی در مدیریت و تحلیل داده» نوشته شده است. این فصل نشان میدهد که یادگیری ماشین و پردازش زبان طبیعی چگونه پاکسازی، یکپارچهسازی و تحلیل اکتشافی دادهها را دگرگون کردهاند. ما ایدههای فصل را با زبان خودمان شرح دادهایم و آنها را با نمونههایی از دادههای رایج در پژوهشهای ایرانی، پرامپتها و چکلیستهای عملی تکمیل کردهایم.
این مقاله قسمت پنجم مجموعهٔ دهقسمتی ریسرچ اینتل بر پایهٔ این کتاب است. اگر هنوز دادهای جمع نکردهاید، بخش گردآوری داده در طراحی پژوهش با هوش مصنوعی را ببینید.
نویسندگان کتاب با صراحتی جالب میگویند که آمادهسازی و پاکسازی داده یکی از پرهزینهترین مراحل پژوهش است و ضمناً یکی از کسلکنندهترین آنها! هر پژوهشگری که با پرسشنامههای کاغذی، فایلهای اکسل چند همکار یا دادههای سامانههای اداری کار کرده باشد، این جمله را با تمام وجود تأیید میکند. خبر خوب این است که امروز بخش بزرگی از این کار را میتوان به ابزارها سپرد؛ خبر مهمتر این است که نظارت انسانی همچنان شرط اصلی کیفیت است.
در ادامه، مسیر را در سه بخش دنبال میکنیم: پاکسازی دادهها، یکپارچهسازی منابع ناهمگون، و تحلیل اکتشافی و مهندسی ویژگی. در هر بخش، هم ابزارها را معرفی میکنیم و هم خطاهایی را که باید مراقبشان باشید.
چرا تحلیل داده با هوش مصنوعی؟ از دادهٔ خام تا دادهٔ قابلاعتماد
کتاب یادآوری میکند که پژوهش معاصر با حجم و پیچیدگی بیسابقهای از داده روبهروست. دادهها دیگر فقط اعداد یک پرسشنامه نیستند؛ متن مصاحبه، پست شبکههای اجتماعی، سوابق اداری، دادههای حسگر و اسناد بایگانی هم بخشی از مادهٔ خام پژوهشاند. پیش از اینکه هر تحلیلی معنا داشته باشد، این دادهها باید آماده شوند.
هزینهٔ پنهان آمادهسازی داده
بسیاری از دانشجویان در برنامهریزی پایاننامه، زمان آمادهسازی داده را دستکم میگیرند. فرض میکنند پس از جمعآوری پرسشنامهها، مستقیماً سراغ تحلیل میروند. اما در عمل با مشکلاتی مانند اینها روبهرو میشوند:
- قالبهای ناهمگون فایل (اکسل، CSV، خروجی فرمهای آنلاین، فایلهای SPSS)؛
- پاسخهای تکراری از یک شرکتکننده؛
- دادههای گمشده در برخی گویهها؛
- مقادیر خارج از دامنه (مثلاً سن ۲۵۰ سال یا نمرهٔ ۸ در طیف لیکرت ۵ درجهای)؛
- نوشتار متفاوت یک مقوله (مثلاً «تهران»، «Tehran»، «تهران » با فاصلهٔ اضافی)؛
- تاریخهای شمسی و میلادی مخلوط.
هر کدام از این مشکلات اگر دیده نشود، نتایج تحلیل را منحرف میکند. یک پاسخ تکراری میتواند ضریب همبستگی را تغییر دهد؛ یک مقدار پرت میتواند میانگین را جابهجا کند؛ و نوشتار متفاوت یک شهر میتواند یک گروه را به سه گروه تبدیل کند.
کتاب توضیح میدهد که فناوریهای هوش مصنوعی، بهویژه یادگیری ماشین و پردازش زبان طبیعی، در ساختاردهی مجموعهدادهها، شناسایی خطاها و پیشنهاد اصلاحات به ابزارهای اصلی مدیریت داده تبدیل شدهاند. مزیت آنها فقط سرعت نیست؛ این سیستمها در طبقهبندی اطلاعات بدون ساختار و آشکار کردن الگوهای پنهان هم توانمندند.
اما کتاب یک شرط مهم هم میگذارد: بهکارگیری این فناوریها نیازمند برنامهریزی است. پژوهشگر باید میان ویژگیهای داده، رویکرد روششناختی و ابزار انتخابی همخوانی برقرار کند. ابزاری که برای دادههای فروش یک شرکت ساخته شده، لزوماً برای دادههای یک پژوهش روانشناختی مناسب نیست.
پیش از شروع پاکسازی، همیشه یک نسخهٔ دستنخورده از دادهٔ خام را جداگانه ذخیره کنید و نام آن را «raw_do_not_edit» بگذارید. همهٔ تغییرات را روی نسخهٔ کپی انجام دهید تا هر لحظه بتوانید به نقطهٔ شروع برگردید.
یک مثال واقعینما: دانشجوی کارشناسی ارشد مدیریت، ۴۰۰ پرسشنامه را در دو ماه جمع کرده است؛ نیمی کاغذی که دستی وارد اکسل شده و نیمی از طریق فرم آنلاین. وقتی فایلها را کنار هم میگذارد، متوجه میشود که در فایل کاغذی، سن به سال ثبت شده و در فرم آنلاین به صورت بازههای سنی؛ گویههای معکوس در یک فایل معکوسسازی شدهاند و در دیگری نه؛ و حدود سی پاسخدهنده هر دو فرم را پر کردهاند. هیچکدام از این مشکلات در نگاه اول دیده نمیشود و اگر مستقیماً سراغ تحلیل برود، ضریب آلفای کرونباخ و نتایج رگرسیون همه نادرست خواهند بود. یک بررسی نظاممند با کمک ابزار، این مشکلات را در یک ساعت آشکار میکند؛ کاری که به صورت دستی ممکن بود روزها طول بکشد یا اصلاً انجام نشود.
پاکسازی دادهٔ ساختاریافته: تکراریها، دادههای گمشده و ناهنجاریها
کتاب به ابزارهای متنباز و تجاری متعددی اشاره میکند که کارهایی مانند حذف تکراریها، جایگذاری دادههای گمشده و تشخیص ناهنجاری را خودکار یا نیمهخودکار انجام میدهند. از جمله:
- OpenRefine: ابزار رایگان و متنباز برای پاکسازی و یکسانسازی دادههای جدولی؛ بهویژه قابلیت «خوشهبندی» آن برای یکسان کردن نوشتارهای متفاوت یک مقوله بسیار کاربردی است.
- Google Cloud DataPrep: ابزار ابری برای پاکسازی دادههای حجیم که تغییرات را قبل و بعد نشان میدهد و «دستورالعمل» قابلتکرار میسازد.
- Google Sheets و اکسل: با ابزارهای داخلی پاکسازی و افزونههای هوشمند برای دادههای کوچکتر.
- دستیارهای مولد مانند ChatGPT یا Claude: برای نوشتن کد پاکسازی در پایتون یا R و توضیح گامبهگام آن.
یکی از مزیتهایی که کتاب برجسته میکند، توانایی این ابزارها در یادگیری از بازخورد کاربر است. وقتی پیشنهادی را تأیید یا رد میکنید، ابزار پیشنهادهای بعدی را دقیقتر میکند.
مثال کتاب بسیار گویاست: فرض کنید دادههای نرخ فارغالتحصیلی چند دانشگاه را ادغام میکنید. یک دانشگاه پروندههای ناتمام را «WD» نامیده، دیگری «Withdrawn» و سومی «Drop». ابزار هوشمند تشخیص میدهد که این سه برچسب احتمالاً یک معنا دارند و پیشنهاد میکند همه را به یک مقوله تبدیل کنید. نسخهٔ ایرانی این مثال را همه دیدهایم: «انصرافی»، «انصراف»، «منصرف» و «ترک تحصیل» در فایلهای چند دانشکده.
یک گردش کار نمونه برای پاکسازی پرسشنامه:
- نمایهسازی ستونها: توزیع، کمینه، بیشینه و تعداد مقادیر یکتای هر ستون را ببینید تا خطاهای آشکار پیدا شوند.
- یکسانسازی متن: فاصلههای اضافی، حروف عربی و فارسی و نوشتارهای مختلف را یکسان کنید.
- گروهبندی هوشمند مقولهها: برچسبهای مشابه را با پیشنهاد ابزار و تأیید خودتان ادغام کنید.
- بررسی کیفیت خودکار: مقادیر خارج از دامنه، فرمتهای نادرست تاریخ و پاسخهای الگودار (مثلاً همهٔ گویهها «۳») را علامت بزنید.
- تصمیم دربارهٔ دادههای گمشده: الگوی گمشدگی را بررسی کنید و روش مناسب (حذف، جایگذاری یا مدلهای ویژه) را با منطق آماری انتخاب کنید.
- ذخیرهٔ دستورالعمل: همهٔ مراحل را به صورت اسکریپت یا «recipe» ذخیره کنید تا قابلتکرار باشد.
پرامپت نمونه برای نوشتن کد پاکسازی:
«من یک فایل CSV از پرسشنامه دارم با ستونهای: کد_شرکتکننده، سن، جنسیت، شهر، و گویههای Q1 تا Q20 (طیف لیکرت ۱ تا ۵). یک اسکریپت پایتون با pandas بنویس که: ۱) ردیفهای تکراری بر اساس کد شرکتکننده را پیدا و گزارش کند؛ ۲) مقادیر خارج از ۱ تا ۵ در گویهها را علامت بزند؛ ۳) پاسخدهندگانی را که به همهٔ گویهها یک عدد دادهاند فهرست کند؛ ۴) تعداد و درصد دادههای گمشده هر ستون را گزارش کند. چیزی را حذف نکن، فقط گزارش بده. کد را خطبهخط توضیح بده.»
عبارت «چیزی را حذف نکن، فقط گزارش بده» اهمیت زیادی دارد. تصمیم دربارهٔ حذف یا اصلاح داده، تصمیمی روششناختی است که باید آگاهانه و مستند گرفته شود، نه به صورت خودکار.
هرگز دادههای گمشده را با عددی که ابزار «حدس زده» پر نکنید، مگر با یک روش جایگذاری آماری شناختهشده که در گزارش پژوهش توضیح داده شود. پر کردن دادهها بدون مبنای روششناختی، مصداق ساختن داده است.
پاکسازی دادهٔ متنی: مصاحبهها و پاسخهای باز
کتاب تأکید میکند که ابزارهای هوشمند فقط برای دادههای عددی نیستند؛ در پاکسازی دادههای بدون ساختار مانند متن مصاحبهها یا پاسخهای باز پرسشنامه هم کمک میکنند. پردازشگرهای متنی مبتنی بر NLP در پایتون میتوانند متن را یکسانسازی کنند، واژههای بیاهمیت را حذف کنند و متن را برای تحلیل آماده کنند.
برای پژوهشگران فارسیزبان، پاکسازی متن چند چالش خاص دارد:
- یکسانسازی نویسهها: تبدیل «ي» و «ك» عربی به «ی» و «ک» فارسی، و یکسان کردن ارقام فارسی، عربی و انگلیسی.
- نیمفاصله: «میشود»، «می شود» و «میشود» باید یکسان شوند تا شمارش واژهها درست باشد.
- محاوره و نوشتار: متن مصاحبهها اغلب محاورهای است («میخوام»، «نمیدونم») و ابزارهای استاندارد آن را خوب پردازش نمیکنند.
- ناشناسسازی: حذف نام افراد، سازمانها و جزئیات قابلشناسایی پیش از هر نوع پردازش با ابزار عمومی.
کتابخانههایی مانند Hazm و Parsivar برای پیشپردازش متن فارسی ساخته شدهاند. میتوانید از دستیار مولد بخواهید کد پیشپردازش را با این کتابخانهها بنویسد.
یک کاربرد بسیار مفید دیگر، تبدیل فایل صوتی مصاحبه به متن است. ابزارهای تبدیل گفتار به نوشتار امروز برای فارسی هم کیفیت قابلقبولی دارند، اما خروجی همیشه باید با فایل صوتی مقایسه و اصلاح شود. یک اشتباه کوچک در پیادهسازی، مثلاً تبدیل «نه» به «نهخیر» یا جا انداختن یک «نمی»، میتواند معنای یک نقلقول را برعکس کند.
اگر مصاحبهها شامل اطلاعات حساس هستند (سلامت روان، تجربهٔ خشونت، مسائل سیاسی یا مالی)، از ابزارهایی استفاده کنید که روی رایانهٔ خودتان اجرا میشوند یا سیاست حریم خصوصی روشنی دارند. رضایت آگاهانهٔ شرکتکنندگان معمولاً اجازهٔ بارگذاری صدای آنها در سرویسهای خارجی را شامل نمیشود.
یکپارچهسازی و هماهنگسازی دادهها از منابع مختلف
کتاب یادآوری میکند که دادههای پژوهش امروز به ندرت از یک منبع واحد میآیند. پایگاههای داده، API ها، گزارشهای بایگانی و جریانهای دادهای لحظهای، هرکدام قالب، ساختار و برچسبهای خود را دارند. ادغام این منابع، بدون از دست دادن معنا و دقت، یکی از چالشبرانگیزترین مراحل کار با داده است.
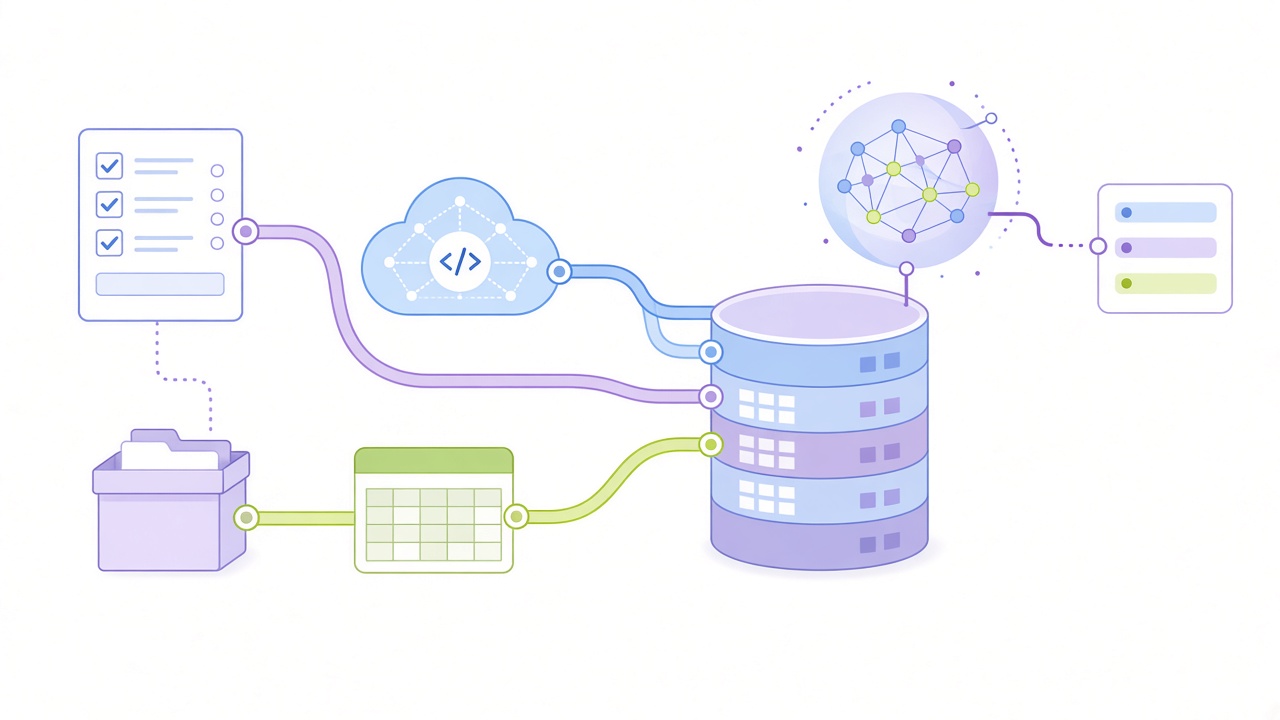
ادغام منابع ناهمگون و هماهنگسازی متغیرها
فرض کنید در یک پژوهش چندمرکزی، سه همکار در سه شهر داده جمع کردهاند. هرکدام متغیر «رضایت» را با نامی متفاوت ثبت کردهاند: یکی «SatisfactionScore»، دیگری «User_Sat» و سومی «رضایت_کل». کتاب نشان میدهد که ابزارهای هوشمند مانند Airtable یا OpenRefine میتوانند این ناهماهنگیها را تشخیص دهند و یک نامگذاری یکسان پیشنهاد کنند.
اما هماهنگسازی فقط به نام متغیرها محدود نیست. چالشهای رایج دیگر:
- مقیاسهای متفاوت: یک مرکز رضایت را با طیف ۵ درجهای و دیگری با ۷ درجهای سنجیده است.
- کدگذاری متفاوت: در یک فایل «۱» یعنی زن و در دیگری «۱» یعنی مرد.
- واحدهای متفاوت: درآمد به تومان در یک فایل و به ریال در فایل دیگر.
- تاریخهای متفاوت: تاریخ شمسی در یک فایل و میلادی در دیگری؛ یا قالبهای مختلف روز و ماه.
- سطح تجمیع متفاوت: دادههای فردی در یک منبع و دادههای استانی در منبع دیگر.
کتاب به نکتهای دربارهٔ تاریخها اشاره میکند که برای ما اهمیت مضاعف دارد: ابزارهایی مانند DataPrep میتوانند قالبهای مختلف تاریخ را تشخیص دهند و به یک الگوی واحد تبدیل کنند؛ همچنین باید مطمئن شوید ستونهای زمانی مختلف از یک منطقهٔ زمانی استفاده میکنند. در پژوهشهای ایرانی، تبدیل تاریخ شمسی به میلادی (یا برعکس) یک گام اضافه است که باید با کتابخانههای معتبر (مثلاً jdatetime در پایتون) انجام شود، نه با محاسبهٔ دستی.
پرامپت نمونه برای هماهنگسازی:
«سه فایل داده دارم که ساختار ستونهایشان به این شکل است: [فهرست ستونهای هر فایل]. یک جدول نگاشت پیشنهاد بده که نشان دهد کدام ستونها احتمالاً یک متغیر را میسنجند، چه تفاوتی در مقیاس یا کدگذاری دارند و چگونه باید یکسان شوند. برای مواردی که مطمئن نیستی، صراحتاً بگو نیاز به بررسی انسانی دارد.»
جدول نگاشتی که ابزار پیشنهاد میدهد، نقطهٔ شروع است. هر ردیف آن را با دفترچهٔ کدگذاری (Codebook) هر مرکز تطبیق دهید. اگر دفترچهٔ کدگذاری وجود ندارد، این اولین چیزی است که باید از همکارانتان بخواهید.
یک نکتهٔ مهم دیگر در یکپارچهسازی، حفظ کلید پیوند است. وقتی دادههای دو منبع را ادغام میکنید (مثلاً پاسخهای پرسشنامه و نمرات آموزشی دانشجویان)، به یک شناسهٔ مشترک نیاز دارید. اگر این شناسه کد ملی یا شمارهٔ دانشجویی است، ابتدا آن را با یک کد تصادفی جایگزین کنید و جدول تطبیق را جداگانه و امن نگه دارید. این کار هم ادغام را ممکن میکند و هم از هویت شرکتکنندگان محافظت میکند. پس از ادغام، همیشه تعداد رکوردهای پیوندخورده و پیوندنخورده را گزارش کنید؛ رکوردهایی که پیوند نخوردهاند ممکن است الگوی خاصی داشته باشند و نتایج را دچار سوگیری کنند.
ابزارهای کمکد و بدون کد برای خودکارسازی جریان داده
کتاب توضیح میدهد که مهارت برنامهنویسی، بهطور سنتی، مانعی بزرگ برای یکپارچهسازی پیچیدهٔ دادهها بوده است. اما ابزارهای کمکد و بدون کد این تواناییها را در دسترس پژوهشگران بیشتری قرار دادهاند. نتیجه این است که پژوهشگر میتواند وقت بیشتری را صرف تفسیر نتایج و طراحی تحلیلهای بعدی کند، به جای اینکه در کارهای دستی گرفتار شود.
نمونههایی که کتاب ذکر میکند:
- Zapier: دریافت خودکار پاسخهای یک فرم آنلاین و افزودن آنها به یک جدول مرکزی، همراه با اطلاعات جمعیتشناختی از منبع دیگر.
- Make: نظارت بر یک پوشهٔ مشترک در Google Drive و افزودن خودکار ردیفهای هر فایل اکسل جدید به مجموعهدادهٔ اصلی.
- Power Automate: هماهنگ کردن جریان دادهای که در آن متن مصاحبهها با یک مرحلهٔ تحلیل متن هوشمند پردازش و با دادههای عددی پیمایش ترکیب میشود.
- Airtable: پایگاه دادهٔ جدولی با قابلیت پیشنهاد هوشمند برای یکسانسازی فیلدها.
برای پژوهشگران ایرانی، دسترسی به برخی از این سرویسها ممکن است محدود باشد یا هزینهٔ ارزی داشته باشد. جایگزینهای عملی:
- Google Sheets با Apps Script: با کمک دستیار مولد میتوانید اسکریپتهای ساده برای ادغام و پاکسازی بنویسید.
- پایتون در Google Colab یا Jupyter: با pandas، ادغام فایلها با چند خط کد ممکن است و دستیار مولد کد را برایتان مینویسد.
- Power Query در اکسل: ابزار داخلی اکسل برای ادغام و تبدیل دادهها که بدون اینترنت هم کار میکند.
- R با پکیجهای tidyverse: برای پژوهشگرانی که با R آشنا هستند.
نکتهٔ مهم: هر ابزاری که انتخاب میکنید، باید بتوانید دقیقاً توضیح دهید دادهها از کجا آمدهاند و چه تغییراتی روی آنها اعمال شده است.
برای پروژههای بزرگ، یک «جدول ردیابی داده» بسازید که برای هر منبع، تاریخ دریافت، تعداد رکورد، مسئول و تغییرات اعمالشده را ثبت کند. این جدول در نوشتن بخش روش و پاسخ به داوران بسیار ارزشمند است.
مستندسازی، تکرارپذیری و اصول FAIR
یکی از مزیتهایی که کتاب برای ابزارهایی مانند DataPrep برمیشمارد، امکان ساختن دستورالعمل قابلاستفادهٔ مجدد است: مجموعهای از مراحل پاکسازی که میتوان آن را روی دادههای جدید هم اجرا کرد. این ویژگی فقط صرفهجویی در وقت نیست؛ پایهٔ تکرارپذیری پژوهش است.
تکرارپذیری یعنی پژوهشگر دیگری (یا خود شما شش ماه بعد) بتواند با همان دادهٔ خام و همان مراحل، به همان نتایج برسد. وقتی پاکسازی به صورت دستی و بدون ثبت انجام شود، این کار تقریباً ناممکن است. اما وقتی همهچیز در یک اسکریپت یا دستورالعمل ثبت شده باشد، فرایند شفاف و قابلبررسی است.
اصول FAIR چارچوبی بینالمللی برای مدیریت دادههای پژوهشی است که میگوید دادهها باید:
- قابلیافتن (Findable) باشند: با شناسهٔ پایدار و فرادادههای روشن؛
- قابلدسترسی (Accessible) باشند: با شرایط دسترسی مشخص؛
- قابلهمکنش (Interoperable) باشند: با قالبها و واژگان استاندارد؛
- قابلاستفادهٔ مجدد (Reusable) باشند: با مستندات کافی و مجوز روشن.
ابزارهای هوش مصنوعی میتوانند در تهیهٔ مستندات کمک کنند؛ مثلاً از روی ساختار فایل داده، پیشنویس دفترچهٔ کدگذاری تولید کنند یا فرادادههای استاندارد پیشنهاد دهند. اما محتوای مستندات باید با دقت توسط پژوهشگر بررسی شود.
یک چکلیست مستندسازی برای پایان مرحلهٔ آمادهسازی:
- نسخهٔ دستنخوردهٔ دادهٔ خام ذخیره شده است.
- همهٔ مراحل پاکسازی در اسکریپت یا دستورالعمل ثبت شدهاند.
- تعداد رکوردهای حذفشده و دلیل حذف هر گروه گزارش شده است.
- روش برخورد با دادههای گمشده مشخص و توجیه شده است.
- دفترچهٔ کدگذاری نهایی با تعریف همهٔ متغیرها تهیه شده است.
- نقش ابزارهای هوش مصنوعی در فرایند ثبت شده است.
تحلیل اکتشافی و مهندسی ویژگی با هوش مصنوعی
پس از آماده شدن دادهها، نوبت به تحلیل اکتشافی میرسد: مرحلهای که هدفش کشف الگوها، ناهنجاریها و روابط پیش از مدلسازی رسمی است. کتاب نشان میدهد که ابزارهای هوشمند این مرحله را از جستوجوی دستی در نمودارها و آمار خلاصه، به فرایندی سریعتر و گستردهتر تبدیل کردهاند؛ هرچند خطرهای تازهای هم به همراه آوردهاند.
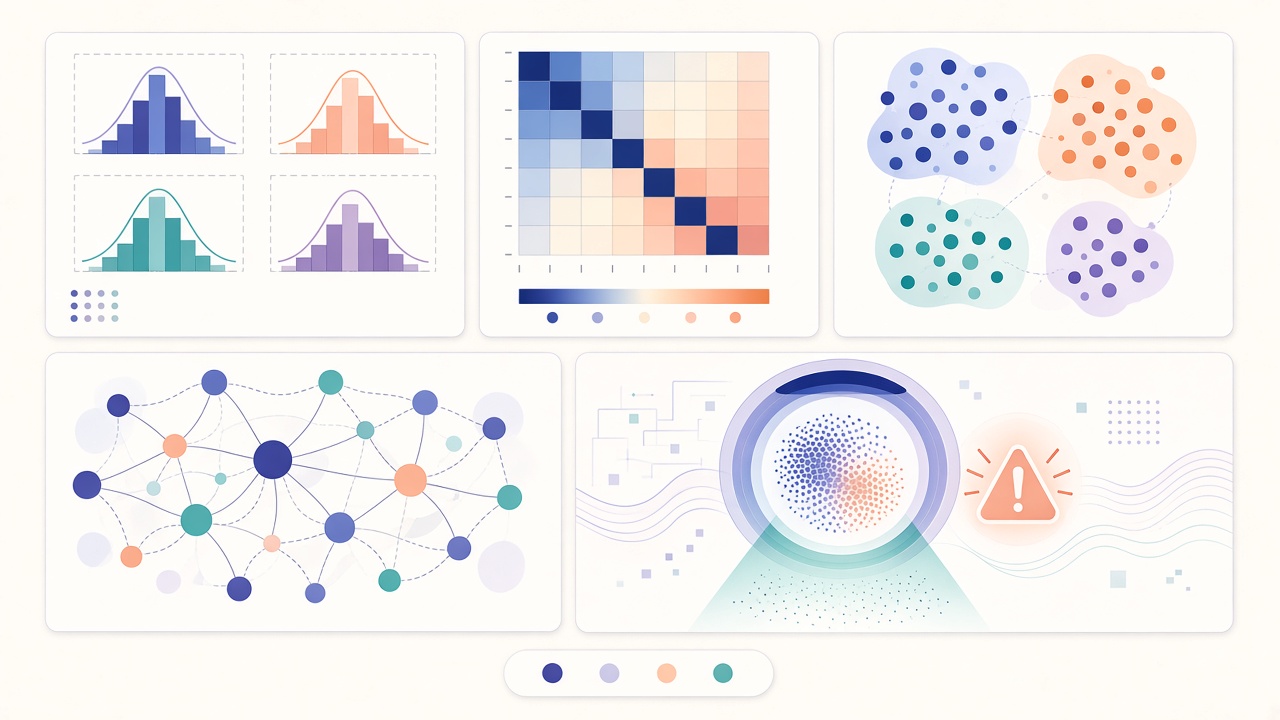
تحلیل اکتشافی داده با کمک ابزارهای هوشمند
تحلیل اکتشافی داده (EDA) مفهومی است که جان توکی، آماردان مشهور، در دههٔ ۱۹۷۰ رواج داد. ایدهٔ آن ساده است: پیش از آزمودن فرضیهها، دادهها را «ببینید». توزیعها، مقادیر پرت، روابط میان متغیرها و الگوهای غیرمنتظره را کشف کنید.
کتاب توضیح میدهد که پلتفرمهای هوشمند امروزی میتوانند تحلیل همبستگی، خوشهبندی و کاهش ابعاد را با کمترین کدنویسی یا حتی بدون آن انجام دهند. برای مثال، پژوهشگری که دادههای اقلیمی را بررسی میکند، میتواند با این ابزارها بهسرعت مناطق با الگوهای مشابه را شناسایی کند.
دستیارهای مولد که قابلیت اجرای کد دارند (مانند بخش تحلیل دادهٔ ChatGPT) هم میتوانند فایل داده را دریافت کنند، کد پایتون بنویسند و اجرا کنند و نمودار تولید کنند. یک گردش کار پیشنهادی:
- خلاصهٔ کلی: «یک خلاصهٔ آماری از همهٔ متغیرها تهیه کن: میانگین، میانه، انحراف معیار، کمینه، بیشینه و تعداد دادههای گمشده.»
- توزیعها: «برای هر متغیر کمی، هیستوگرام و نمودار جعبهای رسم کن و متغیرهایی را که چولگی شدید یا مقادیر پرت دارند، مشخص کن.»
- روابط: «ماتریس همبستگی متغیرهای اصلی را با نقشهٔ حرارتی نشان بده و پنج رابطهٔ قویتر را فهرست کن.»
- گروهها: «میانگین متغیرهای اصلی را به تفکیک جنسیت و گروه سنی مقایسه کن.»
- کد: «کد کامل همهٔ این مراحل را به من بده تا بتوانم آن را در محیط خودم دوباره اجرا کنم.»
مرحلهٔ پنجم بسیار مهم است. نتایج تحلیلی که فقط در محیط چتبات وجود دارد و نمیتوانید آن را تکرار کنید، برای پژوهش قابلاستناد نیست. کد را بگیرید، در محیط خودتان (Colab، Jupyter یا RStudio) اجرا کنید و مطمئن شوید همان نتایج به دست میآید.
برای تحلیلهای استنباطی رسمی که در فصل چهارم پایاننامه گزارش میشوند، راهنمای تحلیل SPSS با ChatGPT و صفحهٔ تحلیل آماری ریسرچ اینتل را ببینید. نکتهٔ کلیدی این است که EDA برای «کشف» است و آزمون فرضیه برای «تأیید»؛ این دو نباید با هم مخلوط شوند.
یک کاربرد کمتر شناختهشده اما مفید دیگر، استفاده از ابزار برای «تفسیر نمودار» است. پس از رسم نمودارها، میتوانید تصویر آنها را به دستیار مولد بدهید و بپرسید چه الگوهایی میبیند. این کار بهویژه برای دانشجویانی که تجربهٔ کمی در خواندن نمودارهای آماری دارند، آموزنده است. اما همیشه تفسیر ابزار را با اعداد واقعی جدولها تطبیق دهید؛ ابزارها گاهی در خواندن مقادیر دقیق از روی نمودار اشتباه میکنند یا الگویی را میبینند که وجود ندارد. یادتان باشد که هدف این مرحله، ساختن فهم شما از دادههاست، نه جمعآوری جملههای آماده برای فصل چهارم.
مهندسی ویژگی و خطر الگوهای کاذب
«مهندسی ویژگی» یعنی ساختن متغیرهای تازه از متغیرهای موجود؛ مثلاً ترکیب چند گویه در یک نمرهٔ کل، محاسبهٔ نسبت دو متغیر، یا استخراج سال از یک تاریخ. کتاب توضیح میدهد که پژوهشگران این کار را برای بهبود عملکرد مدلها و تفسیرپذیری بیشتر انجام میدهند و ابزارهای خودکار میتوانند تبدیلها، دستهبندی مقادیر عددی یا متغیرهای تعاملی را پیشنهاد دهند.
مثال کتاب از یک مجموعهدادهٔ سلامت عمومی است: ابزار ممکن است پیشنهاد دهد که ترکیب سن و شاخص تودهٔ بدنی، یا تقسیم درآمد بر تعداد اعضای خانوار، متغیرهای معنادارتری بسازد. یک کاربرد ترکیبی دیگر: وقتی پاسخهای باز دربارهٔ رضایت و امتیازهای ستارهای را با هم دارید، ابزار تحلیل متن میتواند امتیاز احساس هر پاسخ را استخراج کند و آن را بهعنوان متغیری تازه کنار امتیاز عددی قرار دهد.
اما کتاب در اینجا هشداری جدی میدهد: گردشهای کار خودکار ممکن است تعداد زیادی متغیر تازه پیشنهاد دهند که برخی از آنها الگوهای گذرا یا کاذب را بازتاب میدهند، نه سیگنالهای واقعی. وقتی صدها متغیر میسازید و همبستگی همه را میسنجید، تصادفاً تعدادی «رابطهٔ معنادار» پیدا خواهید کرد که هیچ معنای واقعی ندارند.
راهکارهای مقابله با الگوهای کاذب:
- پشتوانهٔ نظری: هر متغیر تازه باید منطق نظری داشته باشد؛ نه فقط اینکه «همبستگی بالایی نشان داد».
- اعتبارسنجی روی دادهٔ جداگانه: الگویی که در بخشی از داده کشف شد، باید در بخش دیگر هم دیده شود.
- تصحیح مقایسههای چندگانه: اگر آزمونهای زیادی انجام میدهید، از روشهایی مانند بونفرونی یا FDR استفاده کنید.
- گزارش صادقانه: مشخص کنید کدام تحلیلها از پیش برنامهریزی شده بودند و کدام اکتشافیاند.
از ابزار نخواهید «یک رابطهٔ معنادار در دادهها پیدا کن». این درخواست، دستورالعمل مستقیم برای «ماهیگیری داده» (p-hacking) است. به جای آن، فرضیههایتان را از پیش مشخص کنید و از ابزار برای آزمودن همانها کمک بگیرید.
یک تمرین ساده برای درک خطر الگوهای کاذب: از ابزار بخواهید یک مجموعهدادهٔ کاملاً تصادفی با ۵۰ متغیر و ۱۰۰ ردیف بسازد و سپس همبستگی همهٔ جفت متغیرها را بسنجد. خواهید دید که چندین همبستگی «معنادار» در سطح ۰٫۰۵ ظاهر میشود؛ در حالی که دادهها هیچ ساختار واقعی ندارند. این تجربه بهتر از هر توضیحی نشان میدهد که چرا تحلیل اکتشافی بدون نظریه و اعتبارسنجی، میتواند گمراهکننده باشد.
دادههای باز و گرافهای دانش: Wikidata و فراتر
یکی از بخشهای جالب فصل پنجم کتاب، معرفی دادههای باز ویکیمدیا برای تحلیل اکتشافی است. Wikidata یک گراف دانش آزاد و بزرگ است که به صورت مشارکتی نگهداری میشود و اطلاعات ساختاریافتهای دربارهٔ میلیونها موجودیت (افراد، مکانها، سازمانها، آثار علمی و…) دارد. کتاب آن را ابزاری برای پژوهشهای «سریع و نه چندان کثیف» میداند؛ یعنی مطالعاتی که بهسرعت تصویری اولیه از یک پدیده ارائه میدهند.
برای دسترسی به این دادهها، سرویس پرسوجوی Wikidata با زبان SPARQL کار میکند. یادگیری SPARQL برای بسیاری از پژوهشگران دشوار است، اما دستیارهای مولد در نوشتن این پرسوجوها بسیار خوب عمل میکنند:
«یک پرسوجوی SPARQL برای Wikidata بنویس که همهٔ دانشگاههای ایران را همراه با سال تأسیس، شهر و مختصات جغرافیایی برگرداند. پرسوجو را خطبهخط توضیح بده.»
نمونههایی از پژوهشهایی که با Wikidata ممکن میشود:
- بررسی توزیع جنسیتی دانشمندان یک رشته در طول تاریخ؛
- نقشهٔ جغرافیایی مؤسسات پژوهشی یک کشور؛
- تحلیل شبکهٔ همکاریهای علمی یا روابط میان آثار؛
- مقایسهٔ پوشش زبانهای مختلف (مثلاً فارسی و انگلیسی) برای یک موضوع.
اما دادههای باز مشارکتی محدودیتهای خود را هم دارند. پوشش آنها ناهمگون است (برخی کشورها، زبانها و موضوعات کمحضورترند)، ممکن است خطا داشته باشند و در طول زمان تغییر کنند. اگر از این دادهها در پژوهش استفاده میکنید، تاریخ دریافت و پرسوجوی دقیق را ثبت کنید و محدودیتهای پوشش را در گزارش ذکر کنید.
برای مرور بیشتر ملاحظات اخلاقی کار با دادهها، مقالهٔ اخلاق هوش مصنوعی در پژوهش و برای آشنایی با روندهای آیندهٔ کلانداده در دانشگاه، آینده هوش مصنوعی در پژوهش را بخوانید.
در پایان این بخش، یک یادآوری کلی: ابزارهای هوشمند تحلیل داده، هر قدر هم پیشرفته باشند، فقط به همان اندازهای خوباند که دادههای ورودی و پرسشهای پژوهشگر خوب باشند. اصل قدیمی «ورودی بیکیفیت، خروجی بیکیفیت» در عصر هوش مصنوعی نهتنها منسوخ نشده، بلکه اهمیت بیشتری یافته است؛ زیرا خروجیهای ابزارهای هوشمند ظاهری حرفهای و قانعکننده دارند و خطاهایشان دیرتر آشکار میشود.
سؤالات متداول
آیا میتوانم فایل دادههای پایاننامهام را در ChatGPT بارگذاری کنم؟
اگر دادهها کاملاً ناشناسسازی شدهاند و رضایتنامهٔ شرکتکنندگان و سیاست دانشگاه این اجازه را میدهد، ممکن است. اما دادههای شامل اطلاعات هویتی یا حساس را هرگز در ابزارهای عمومی بارگذاری نکنید. یک راهکار امن، ساختن نمونهٔ ساختگی با همان ساختار برای دریافت کد و سپس اجرای کد روی دادهٔ واقعی در رایانهٔ خودتان است.
آیا نتایج تحلیلی که ChatGPT انجام داده قابلاستناد است؟
فقط اگر بتوانید آن را تکرار کنید. کد تحلیل را بگیرید، در محیط خودتان اجرا کنید و نتایج را بررسی کنید. اعدادی که فقط در پاسخ متنی چتبات آمدهاند و پشتوانهٔ کد قابلبررسی ندارند، نباید در پایاننامه یا مقاله گزارش شوند.
تفاوت تحلیل اکتشافی با آزمون فرضیه چیست؟
تحلیل اکتشافی برای کشف الگوها و آشنایی با دادههاست و نتایجش «فرضیهساز» است. آزمون فرضیه برای تأیید یا رد فرضیههایی است که از پیش و بر پایهٔ نظریه مشخص شدهاند. گزارش یافتههای اکتشافی بهعنوان نتایج تأییدی، خطای روششناختی جدی است.
برای پاکسازی داده بدون برنامهنویسی چه ابزاری پیشنهاد میکنید؟
OpenRefine رایگان و قدرتمند است و برای یکسانسازی مقولهها عالی عمل میکند. Power Query در اکسل هم گزینهٔ خوبی است. اگر کمی با پایتون آشنا شوید، دستیارهای مولد میتوانند کدهای پاکسازی را برایتان بنویسند و توضیح دهند.
آیا باید استفاده از هوش مصنوعی در تحلیل داده را گزارش کنم؟
بله. اگر ابزار در پاکسازی، کدگذاری، تولید کد تحلیل یا تفسیر نقش داشته، در بخش روش توضیح دهید که از چه ابزاری، برای چه کاری و با چه سازوکار بررسی انسانی استفاده کردهاید. این شفافیت اعتبار پژوهش را افزایش میدهد.
جمعبندی
تحلیل داده با هوش مصنوعی فقط تفسیر خروجی نرمافزار آماری نیست؛ کل چرخهٔ کار با داده، از پاکسازی و یکسانسازی تا ادغام منابع و تحلیل اکتشافی را در بر میگیرد. فصل پنجم کتاب Using AI in Academic Writing and Research نشان میدهد که خودکارسازی کارهای تکراری و پرخطا، وقت پژوهشگر را برای تفسیر و تفکر آزاد میکند؛ اما همزمان هشدار میدهد که اتکای بیش از حد به پیشنهادهای خودکار، خطرناک است و اعتبارسنجی، تکرارپذیری و حاکمیت اخلاقی دادهها همچنان ضروریاند.
برای ادامه، پس از تحلیل دادهها باید آنها را به شکلی روشن ارائه دهید؛ مقالهٔ ساخت پاورپوینت با هوش مصنوعی در این زمینه کمک میکند. برای مبانی کلی، هوش مصنوعی در پژوهش دانشگاهی و برای مهارتهای پایهٔ کار با ابزارها، آموزش هوش مصنوعی برای دانشجویان را ببینید. اگر در حال نوشتن فصل چهارم پایاننامه هستید، نوشتن پایاننامه با هوش مصنوعی و صفحهٔ نگارش پایاننامه را از دست ندهید. برای مقایسهٔ ابزارها، بهترین هوش مصنوعی برای پژوهش را بخوانید؛ پرامپتهای آماده را در بانک پرامپتهای پژوهشی بیابید؛ با رویکردهای کلی در صفحهٔ هوش مصنوعی در پژوهش آشنا شوید و برای همراهی در تحلیل دادههای پیچیده، از مشاوره پژوهشی ریسرچ اینتل کمک بگیرید.
برای آموزشها و مشاورههای بیشتر پژوهشی به هوش پژوهشی سر بزنید.
منابع
- Haber, E., Jemielniak, D., Kurasiński, A., & Przegalińska, A. (2025). *Using AI in Academic Writing and Research: A Complete Guide to Effective and Ethical Academic AI*. Springer Nature. فصل ۵: AI in Data Management and Analysis. https://doi.org/10.1007/978-3-031-91705-9
- OpenRefine
- GO FAIR. FAIR Principles
- Wikidata و Wikidata Query Service
دیدگاهتان را بنویسید