☎ ۰۹۱۲۰۴۳۸۸۷۴

برچسب: ابزارهای هوش مصنوعی

  • تحلیل SPSS با ChatGPT؛ تفسیر خروجی فصل چهارم

    تحلیل SPSS با ChatGPT؛ تفسیر خروجی فصل چهارم

    تحلیل SPSS با ChatGPT یکی از پرجست‌وجوترین موضوعات میان دانشجویان کارشناسی ارشد و دکتری است، به‌ویژه وقتی به فصل چهارم پایان‌نامه می‌رسند. داده‌ها جمع شده، در SPSS وارد شده و آزمون‌ها اجرا شده‌اند؛ اما حالا با صفحه‌ای پر از جدول، عدد و اصطلاحاتی مثل Sig.، Beta، Levene و Durbin-Watson روبه‌رو هستید و نمی‌دانید کدام عدد را گزارش کنید، چگونه تفسیر کنید و چطور آن را به متنی علمی و منسجم تبدیل کنید.

    ChatGPT و ابزارهای مشابه می‌توانند در این مرحله کمک بزرگی باشند. آن‌ها می‌توانند معنای هر جدول را توضیح دهند، بگویند کدام مقادیر مهم‌اند، پیش‌فرض‌های آزمون را یادآوری کنند و به شما کمک کنند گزارش را مطابق سبک APA بنویسید. اما همین ابزارها، اگر نادرست استفاده شوند، می‌توانند اعداد را اشتباه بازنویسی کنند، آزمون نامناسب پیشنهاد دهند یا تفسیری فراتر از داده‌ها ارائه کنند. و از همه مهم‌تر: هرگز نباید برای ساختن یا تغییر نتایج به کار روند.

    در این راهنما، ابتدا می‌گوییم ChatGPT در تحلیل آماری چه کاری می‌تواند و چه کاری نمی‌تواند انجام دهد، چگونه خروجی را آماده و بی‌نام‌سازی کنید و ساختار استاندارد فصل چهارم چیست. سپس تفسیر رایج‌ترین خروجی‌های SPSS را با مثال مرور می‌کنیم: آمار توصیفی، نرمال بودن، پایایی، همبستگی، آزمون t، تحلیل واریانس و رگرسیون. در نهایت، نحوه‌ی نگارش متن فصل چهارم به سبک APA، پرامپت‌های آماده و خطاهای رایج و اخلاقی را بررسی می‌کنیم.

    ChatGPT جایگزین نرم‌افزار آماری، استاد راهنما یا مشاور آمار نیست. انتخاب آزمون، اجرای تحلیل و تصمیم‌گیری درباره‌ی نتایج باید بر اساس طرح پژوهش و با نظارت متخصص انجام شود. نقش ابزار، کمک به «فهم» و «نگارش» است.

    چرا فصل چهارم برای بسیاری از دانشجویان این‌قدر دشوار است؟ دلیل اصلی این است که آموزش آمار در بسیاری از دوره‌ها بیشتر بر «اجرای آزمون» تمرکز دارد تا «تفسیر و گزارش». دانشجو یاد می‌گیرد در کدام منو کلیک کند، اما وقتی خروجی را می‌بیند، نمی‌داند کدام عدد اهمیت دارد و چگونه آن را به زبان علمی بیان کند. ChatGPT می‌تواند دقیقاً همین فاصله را پر کند: نقش یک معلم صبور را بازی کند که هر جدول را بارها و به زبان ساده توضیح می‌دهد تا خودتان به فهم برسید. اگر با این نگاه از ابزار استفاده کنید، نه‌تنها فصل چهارم را بهتر می‌نویسید، بلکه در جلسه‌ی دفاع هم با اطمینان بیشتری به سؤالات آماری پاسخ می‌دهید.

    پیش از شروع: نقش ChatGPT، آماده‌سازی خروجی و ساختار فصل چهارم

    پیش از اینکه اولین جدول خروجی را به ChatGPT بدهید، سه موضوع را روشن کنید: انتظارات واقع‌بینانه از ابزار، نحوه‌ی آماده‌سازی و بی‌نام‌سازی خروجی‌ها و ساختار کلی فصلی که قرار است بنویسید. این آمادگی، کیفیت کمک ابزار را چند برابر می‌کند و از خطاهای پرهزینه جلوگیری می‌کند.

    آماده‌سازی خروجی برای تحلیل SPSS با ChatGPT
    آماده‌سازی خروجی برای تحلیل SPSS با ChatGPT

    ChatGPT در تحلیل آماری چه می‌کند و چه نمی‌کند؟

    برای استفاده‌ی درست، باید بدانیم ابزار در کجا قوی و در کجا ضعیف است.

    کارهایی که ChatGPT به‌خوبی انجام می‌دهد:

    • توضیح معنای هر ستون و ردیف جدول‌های خروجی SPSS به زبان ساده
    • یادآوری پیش‌فرض‌های هر آزمون و نحوه‌ی بررسی آن‌ها
    • پیشنهاد اینکه کدام مقادیر باید در متن گزارش شوند
    • کمک در نوشتن جمله‌های گزارش آماری مطابق سبک APA
    • توضیح تفاوت مفاهیمی مثل معناداری آماری و اندازه‌ی اثر
    • کمک در نوشتن Syntax یا راهنمایی در منوهای SPSS
    • بررسی سازگاری میان فرضیه، آزمون و نتیجه‌گیری

    کارهایی که ChatGPT نباید انجام دهد یا در آن‌ها ضعیف است:

    • محاسبه‌ی دستی آماره‌ها: مدل‌های زبانی در محاسبات عددی خطا می‌کنند؛ محاسبه را به SPSS بسپارید.
    • انتخاب قطعی آزمون بدون شناخت طرح پژوهش: ممکن است آزمونی پیشنهاد دهد که با نوع داده یا طرح شما سازگار نیست.
    • تفسیر علّی از داده‌های همبستگی: گاهی زبان علّی به کار می‌برد که با طرح شما سازگار نیست.
    • ساختن یا «بهتر کردن» نتایج: این کار جعل داده است و تخلف جدی پژوهشی محسوب می‌شود.

    قاعده‌ی کلیدی: اعداد از SPSS می‌آیند، تفسیر از دانش شما و استاد، و ChatGPT فقط به فهم و نگارش کمک می‌کند.

    اگر از نسخه‌هایی از ChatGPT استفاده می‌کنید که قابلیت اجرای کد و تحلیل داده دارند، ممکن است وسوسه شوید تحلیل را مستقیماً در خود ابزار انجام دهید. این کار برای بررسی‌های اکتشافی یا تطبیق نتایج می‌تواند مفید باشد، اما برای پایان‌نامه معمولاً باید تحلیل اصلی را در نرم‌افزار مورد تأیید گروه (مانند SPSS) انجام دهید و خروجی آن را مستند کنید.

    یک توصیه‌ی مهم دیگر: پیش از کمک گرفتن از ChatGPT، راهنمای رسمی نرم‌افزار را هم در نظر داشته باشید. مستندات رسمی IBM SPSS Statistics توضیح دقیق هر رویه، گزینه‌ها و جدول‌های خروجی را ارائه می‌دهد. اگر توضیح ChatGPT درباره‌ی یک ستون یا گزینه با مستندات رسمی تفاوت داشت، مستندات رسمی معتبر است. همچنین نسخه‌ی SPSS را که استفاده می‌کنید در پرامپت ذکر کنید، چون برخی جدول‌ها و گزینه‌ها در نسخه‌های مختلف تفاوت دارند.

    آماده‌سازی خروجی و بی‌نام‌سازی داده‌ها

    برای اینکه ChatGPT خروجی را درست تفسیر کند، باید آن را در قالب مناسب به ابزار بدهید. سه روش رایج:

    1. کپی متنی جدول: در Output Viewer روی جدول کلیک راست کنید، آن را کپی کنید و در پنجره‌ی گفت‌وگو بچسبانید. معمولاً ساختار جدول تا حد زیادی حفظ می‌شود.
    2. خروجی گرفتن: از منوی Export، خروجی را به Word، Excel یا PDF تبدیل کنید و جدول‌های موردنظر را جدا کنید.
    3. تصویر جدول: در ابزارهایی که تصویر را می‌پذیرند، می‌توانید تصویر جدول را بارگذاری کنید. اما دقت کنید که خواندن اعداد از تصویر ممکن است خطا داشته باشد؛ اعداد کلیدی را دوباره بررسی کنید.

    بی‌نام‌سازی: هرگز فایل داده‌ی خام (.sav) شامل اطلاعات هویتی شرکت‌کنندگان را در ابزارهای عمومی بارگذاری نکنید. جدول‌های خروجی آماری معمولاً اطلاعات هویتی ندارند و برای تفسیر کافی‌اند. اگر لازم است داده‌ی خام را بارگذاری کنید، ابتدا همه‌ی متغیرهای هویتی (نام، شماره‌ی تماس، کد ملی، شماره‌ی پرونده) را حذف کنید و مطمئن شوید رضایت‌نامه‌ی شرکت‌کنندگان و ضوابط کمیته‌ی اخلاق چنین پردازشی را منع نکرده است.

    زمینه دادن: پیش از ارسال جدول، زمینه‌ی پژوهش را به ابزار بدهید. یک پرامپت زمینه‌ای نمونه:

    «من دانشجوی کارشناسی ارشد روان‌شناسی هستم. پژوهش من رابطه‌ی حمایت اجتماعی ادراک‌شده و تاب‌آوری با سلامت روان در دانشجویان را بررسی می‌کند. طرح پژوهش مقطعی-همبستگی است، حجم نمونه ۲۸۰ نفر و ابزارها پرسشنامه‌های استاندارد با طیف لیکرت است. فرضیه‌ها این‌ها هستند: […]. در ادامه جدول‌های خروجی SPSS را می‌فرستم. لطفاً هر جدول را توضیح بده، مقادیری را که باید گزارش کنم مشخص کن و هیچ عددی را تغییر نده.»

    یک فایل «جدول‌های منتخب» بسازید که فقط جدول‌های لازم برای فصل چهارم را داشته باشد. خروجی‌های SPSS معمولاً جدول‌های زیادی دارند که همه‌ی آن‌ها گزارش نمی‌شوند. از ChatGPT بپرسید کدام جدول‌ها برای هر آزمون معمولاً گزارش می‌شوند.

    نکته‌ی مربوط به حریم خصوصی حساب کاربری: اگر از حساب مشترک با دیگران استفاده می‌کنید، تاریخچه‌ی گفت‌وگوها و جدول‌های شما برای آن‌ها قابل‌مشاهده است. برای کار روی پایان‌نامه، حساب شخصی با رمز قوی و در صورت امکان تأیید دومرحله‌ای را ترجیح دهید. صفحه‌ی خرید اکانت هوش مصنوعی گزینه‌های مختلف دسترسی را معرفی کرده است. همچنین در تنظیمات ابزار، اگر گزینه‌ای برای جلوگیری از استفاده‌ی گفت‌وگوها در آموزش مدل وجود دارد، آن را فعال کنید.

    ساختار استاندارد فصل چهارم

    فصل چهارم پایان‌نامه‌های کمی معمولاً این ساختار را دارد:

    1. مقدمه‌ی کوتاه: یادآوری هدف فصل و ترتیب ارائه‌ی یافته‌ها.
    2. ویژگی‌های جمعیت‌شناختی: جنسیت، سن، تحصیلات و سایر ویژگی‌های نمونه، معمولاً با فراوانی و درصد.
    3. آمار توصیفی متغیرهای اصلی: میانگین، انحراف معیار، کمینه، بیشینه، چولگی و کشیدگی.
    4. بررسی پیش‌فرض‌ها: نرمال بودن، همگنی واریانس، نبود هم‌خطی و غیره، بسته به آزمون‌ها.
    5. پایایی ابزارها: ضرایب آلفای کرونباخ در نمونه‌ی پژوهش (گاهی در فصل سوم گزارش می‌شود).
    6. آزمون فرضیه‌ها: هر فرضیه به ترتیب، با جدول و متن تفسیری.
    7. جمع‌بندی: خلاصه‌ی نتایج آزمون فرضیه‌ها، معمولاً در یک جدول.

    ChatGPT می‌تواند به شما کمک کند این ساختار را با فرضیه‌های خودتان تطبیق دهید و ترتیب منطقی ارائه را پیشنهاد کند. برای آشنایی با ارتباط این فصل با سایر فصل‌ها، راهنمای نوشتن پایان‌نامه با هوش مصنوعی را ببینید.

    یک نکته‌ی ساختاری مهم این است که فصل چهارم باید دقیقاً به ترتیب فرضیه‌ها یا سؤالاتی باشد که در فصل اول آمده‌اند. اگر فرضیه‌ها در فصل اول یک ترتیب دارند و در فصل چهارم ترتیب دیگری، داوران سردرگم می‌شوند. همچنین عنوان هر بخش از آزمون فرضیه‌ها را با متن خود فرضیه شروع کنید تا خواننده بداند کدام فرضیه در حال بررسی است. ChatGPT می‌تواند فهرست فرضیه‌های فصل اول و عنوان‌های فصل چهارم را مقایسه کند و هر ناهماهنگی را گزارش دهد. اگر در نگارش فصل‌های دیگر هم به راهنمایی نیاز دارید، صفحه‌ی نگارش پایان‌نامه را ببینید.

    تفسیر رایج‌ترین خروجی‌های SPSS با کمک ChatGPT

    در این بخش، رایج‌ترین آزمون‌هایی را که در پایان‌نامه‌های ایرانی به کار می‌روند مرور می‌کنیم و برای هر کدام توضیح می‌دهیم کدام مقادیر مهم‌اند، چگونه تفسیر می‌شوند و چه پرامپتی برای کمک گرفتن از ChatGPT مناسب است. این بخش جایگزین منابع آماری نیست، اما راهنمای عملی خوبی برای خواندن خروجی‌هاست.

    تفسیر خروجی آزمون‌ها در تحلیل SPSS با ChatGPT
    تفسیر خروجی آزمون‌ها در تحلیل SPSS با ChatGPT

    آمار توصیفی، نرمال بودن و پایایی

    آمار توصیفی (Descriptives): جدول Descriptive Statistics مقادیر N، کمینه، بیشینه، میانگین و انحراف معیار را نشان می‌دهد. اگر چولگی (Skewness) و کشیدگی (Kurtosis) را هم درخواست کرده باشید، این مقادیر هم نمایش داده می‌شوند. در گزارش، معمولاً میانگین و انحراف معیار هر متغیر را با دو رقم اعشار می‌آورید.

    نرمال بودن: برای بررسی نرمال بودن، دانشجویان معمولاً از آزمون‌های کولموگروف-اسمیرنوف (K-S) و شاپیرو-ویلک (Shapiro-Wilk) استفاده می‌کنند. در جدول Tests of Normality، اگر مقدار Sig. بیشتر از ۰٫۰۵ باشد، فرض نرمال بودن رد نمی‌شود. اما چند نکته‌ی مهم:

    • در نمونه‌های بزرگ (مثلاً بیش از ۲۰۰ نفر)، این آزمون‌ها حتی به انحراف‌های جزئی از نرمال بودن حساس‌اند و ممکن است معنادار شوند.
    • به همین دلیل، بسیاری از پژوهشگران در کنار آزمون‌ها، به مقادیر چولگی و کشیدگی و نمودارهای Q-Q و هیستوگرام هم توجه می‌کنند. برخی منابع، دامنه‌ای مثل ±۲ برای چولگی و کشیدگی را قابل‌قبول می‌دانند، هرچند معیارها در منابع مختلف متفاوت است.

    پایایی (Reliability): در جدول Reliability Statistics، ضریب آلفای کرونباخ نمایش داده می‌شود. مقدار ۰٫۷۰ یا بیشتر معمولاً قابل‌قبول تلقی می‌شود، هرچند این معیار هم مطلق نیست و به تعداد گویه‌ها و ماهیت سازه بستگی دارد. جدول Item-Total Statistics نشان می‌دهد اگر هر گویه حذف شود، آلفا چه تغییری می‌کند.

    پرامپت پیشنهادی: «این جدول Tests of Normality و Descriptives متغیرهای من است و حجم نمونه ۲۸۰ است. توضیح بده آیا با توجه به حجم نمونه، آزمون‌ها، چولگی و کشیدگی، می‌توانم فرض نرمال بودن را پذیرفتنی بدانم و چگونه این را در متن گزارش کنم. منابع آماری که این معیارها را پیشنهاد کرده‌اند را نام نبر؛ خودم پیدا می‌کنم.»

    حذف گویه‌ها برای افزایش آلفای کرونباخ یا حذف شرکت‌کنندگان برای «نرمال کردن» داده‌ها، بدون توجیه روش‌شناختی و گزارش شفاف، می‌تواند دست‌کاری داده محسوب شود. هر تغییری در داده‌ها باید با استاد راهنما هماهنگ و در متن گزارش شود.

    ویژگی‌های جمعیت‌شناختی: برای متغیرهای جمعیت‌شناختی مثل جنسیت، تحصیلات یا وضعیت تأهل، جدول Frequencies شامل فراوانی، درصد، درصد معتبر و درصد تجمعی است. در گزارش، معمولاً فقط فراوانی و درصد معتبر کافی است. برای سن، اگر به‌صورت پیوسته سنجیده شده، میانگین و انحراف معیار گزارش می‌شود. ChatGPT می‌تواند چند جدول فراوانی را در یک جدول ترکیبی جمعیت‌شناختی خلاصه کند و یک پاراگراف توصیفی کوتاه برای آن پیشنهاد دهد؛ اما درصدها را دوباره با خروجی تطبیق دهید، چون گرد کردن ممکن است مجموع را از ۱۰۰ دور کند.

    همبستگی، آزمون t و تحلیل واریانس

    همبستگی پیرسون (Correlations): در جدول Correlations، برای هر جفت متغیر، ضریب همبستگی (r)، مقدار Sig. و N نمایش داده می‌شود. ضریب بین ۱- و ۱+ است؛ علامت جهت رابطه و قدر مطلق شدت آن را نشان می‌دهد. اگر داده‌ها نرمال نباشند یا متغیرها رتبه‌ای باشند، همبستگی اسپیرمن جایگزین رایج است.

    نکته‌ی مهم در تفسیر: همبستگی به معنای علیت نیست. ChatGPT گاهی در بازنویسی، جمله‌ای مثل «حمایت اجتماعی باعث افزایش سلامت روان می‌شود» می‌نویسد که برای یک طرح همبستگی نادرست است. زبان درست: «بین حمایت اجتماعی و سلامت روان رابطه‌ی مثبت و معنادار مشاهده شد.»

    آزمون t مستقل (Independent Samples t-test): برای مقایسه‌ی میانگین دو گروه مستقل، مثلاً زنان و مردان. خروجی دو جدول دارد: Group Statistics (میانگین و انحراف معیار هر گروه) و Independent Samples Test. در جدول دوم، ابتدا به آزمون لوین (Levene’s Test) نگاه کنید:

    • اگر Sig. لوین بیشتر از ۰٫۰۵ باشد، فرض برابری واریانس‌ها برقرار است و از ردیف اول (Equal variances assumed) استفاده کنید.
    • اگر کمتر از ۰٫۰۵ باشد، از ردیف دوم (Equal variances not assumed) استفاده کنید.

    سپس مقدار t، درجه‌ی آزادی (df) و Sig. (2-tailed) را گزارش کنید. نسخه‌های جدیدتر SPSS اندازه‌ی اثر (مانند d کوهن) را هم ارائه می‌دهند که گزارش آن توصیه می‌شود.

    تحلیل واریانس یک‌طرفه (One-Way ANOVA): برای مقایسه‌ی میانگین سه گروه یا بیشتر. جدول ANOVA مقادیر F، df بین‌گروهی و درون‌گروهی و Sig. را نشان می‌دهد. اگر F معنادار بود، برای فهمیدن اینکه کدام گروه‌ها با هم تفاوت دارند، به آزمون‌های تعقیبی (Post Hoc) مانند توکی (Tukey) یا شفه (Scheffe) نیاز دارید. پیش‌فرض همگنی واریانس‌ها را هم با آزمون لوین بررسی کنید؛ اگر برقرار نبود، آزمون‌هایی مثل Welch و تعقیبی Games-Howell جایگزین‌های رایج هستند.

    پرامپت پیشنهادی: «این خروجی آزمون t مستقل برای مقایسه‌ی سلامت روان در دانشجویان دختر و پسر است. توضیح بده از کدام ردیف باید استفاده کنم، نتیجه چیست و یک جمله‌ی گزارش به سبک APA با همین اعداد بنویس. هیچ عددی را گرد یا تغییر نده.»

    آزمون t وابسته (Paired Samples t-test): اگر یک گروه را در دو زمان (مثلاً پیش‌آزمون و پس‌آزمون) مقایسه می‌کنید، از این آزمون استفاده می‌شود. خروجی شامل Paired Samples Statistics، Paired Samples Correlations و Paired Samples Test است. در جدول آخر، میانگین تفاوت‌ها، t، df و Sig. گزارش می‌شوند.

    آزمون خی‌دو (Chi-Square): برای بررسی رابطه‌ی دو متغیر اسمی، مثلاً جنسیت و انتخاب رشته. در جدول Chi-Square Tests، مقدار Pearson Chi-Square، df و Sig. را گزارش کنید. به یادداشت زیر جدول هم توجه کنید که نشان می‌دهد چند خانه فراوانی مورد انتظار کمتر از ۵ دارند؛ اگر این نسبت زیاد باشد، آزمون دقیق فیشر یا ادغام طبقات ممکن است لازم باشد. برای اندازه‌ی اثر، ضریب فی یا V کرامر رایج است.

    آزمون‌های ناپارامتریک: اگر پیش‌فرض‌های آزمون‌های پارامتریک برقرار نباشد، جایگزین‌های رایج عبارت‌اند از: من-ویتنی U به‌جای t مستقل، ویلکاکسون به‌جای t وابسته و کروسکال-والیس به‌جای ANOVA یک‌طرفه. ChatGPT می‌تواند توضیح دهد چه زمانی این جایگزین‌ها مناسب‌اند، اما تصمیم نهایی را با استاد راهنما بگیرید.

    رگرسیون، میانجی و تعدیل‌گر

    رگرسیون خطی چندگانه (Linear Regression): یکی از پرکاربردترین تحلیل‌ها در پایان‌نامه‌هاست. خروجی شامل چند جدول کلیدی است:

    • Model Summary: ضریب همبستگی چندگانه (R)، ضریب تعیین (R²) که نشان می‌دهد چه درصدی از واریانس متغیر وابسته توسط پیش‌بین‌ها تبیین می‌شود، R² تعدیل‌شده و آماره‌ی دوربین-واتسون (Durbin-Watson) برای بررسی استقلال خطاها (مقادیر نزدیک به ۲ معمولاً مطلوب تلقی می‌شوند).
    • ANOVA: معناداری کل مدل رگرسیون با آماره‌ی F.
    • Coefficients: برای هر پیش‌بین، ضریب غیراستاندارد (B)، خطای استاندارد، ضریب استاندارد (Beta)، مقدار t و Sig. اگر آماره‌های هم‌خطی را درخواست کرده باشید، Tolerance و VIF هم نمایش داده می‌شوند؛ VIF بالا (معیارهایی مثل بیش از ۵ یا ۱۰ در منابع مختلف) نشانه‌ی هم‌خطی است.

    در تفسیر، Beta برای مقایسه‌ی سهم نسبی پیش‌بین‌ها مفید است، چون استاندارد شده است. B برای تفسیر در واحد اصلی متغیرها به کار می‌رود.

    میانجی و تعدیل‌گر: بسیاری از پایان‌نامه‌ها نقش متغیر میانجی (Mediator) یا تعدیل‌گر (Moderator) را بررسی می‌کنند. در SPSS، این تحلیل‌ها معمولاً با افزونه‌ی PROCESS انجام می‌شوند. خروجی PROCESS شامل اثر مستقیم، اثر غیرمستقیم و فاصله‌ی اطمینان بوت‌استرپ است. قاعده‌ی کلی: اگر فاصله‌ی اطمینان اثر غیرمستقیم (BootLLCI تا BootULCI) شامل صفر نباشد، اثر میانجی معنادار تلقی می‌شود.

    ChatGPT می‌تواند در فهم این خروجی‌های پیچیده بسیار کمک کند، اما برای تحلیل‌های پیشرفته‌تر مثل مدل‌یابی معادلات ساختاری (SEM) با AMOS یا SmartPLS، همراهی متخصص آمار ضروری است. صفحه‌ی تحلیل آماری ریسرچ اینتل در این زمینه خدمات و راهنمایی ارائه می‌دهد.

    برای هر جدول رگرسیون، از ChatGPT بخواهید یک «چک‌لیست پیش‌فرض‌ها» بدهد: خطی بودن، استقلال خطاها، همسانی واریانس خطاها، نرمال بودن باقی‌مانده‌ها و نبود هم‌خطی. سپس بررسی کنید کدام را در خروجی خود دارید و کدام را باید اجرا کنید.

    تحلیل‌های مبتنی بر طرح‌های آزمایشی: اگر پژوهش شما نیمه‌آزمایشی با پیش‌آزمون و پس‌آزمون و گروه کنترل است، تحلیل کوواریانس (ANCOVA) یکی از روش‌های رایج است. در این تحلیل، پیش‌فرض‌های اضافی مثل همگنی شیب‌های رگرسیون باید بررسی شوند. ChatGPT می‌تواند این پیش‌فرض‌ها و نحوه‌ی بررسی آن‌ها در SPSS را توضیح دهد و جدول Tests of Between-Subjects Effects را تفسیر کند، شامل مجذور اتای جزئی (Partial Eta Squared) به‌عنوان اندازه‌ی اثر. برای طرح‌های پیچیده‌تر مثل اندازه‌گیری مکرر، مشورت با متخصص آمار را جدی بگیرید.

    مطالعهٔ تکمیلی: اگر می‌خواهید این موضوع را عمیق‌تر و بر پایهٔ یک منبع معتبر دانشگاهی دنبال کنید، راهنماهای تحلیل داده با هوش مصنوعی، طراحی پژوهش با هوش مصنوعی و آموزش هوش مصنوعی برای دانشجویان را هم در ریسرچ اینتل بخوانید.

    نگارش فصل چهارم و کنترل کیفیت

    پس از فهم خروجی‌ها، نوبت به تبدیل آن‌ها به متن علمی فصل چهارم می‌رسد. در این بخش، نحوه‌ی نگارش گزارش آماری به سبک APA را با نمونه مرور می‌کنیم، پرامپت‌های آماده‌ی هر مرحله را ارائه می‌دهیم و خطاهای رایج و ملاحظات اخلاقی را بررسی می‌کنیم.

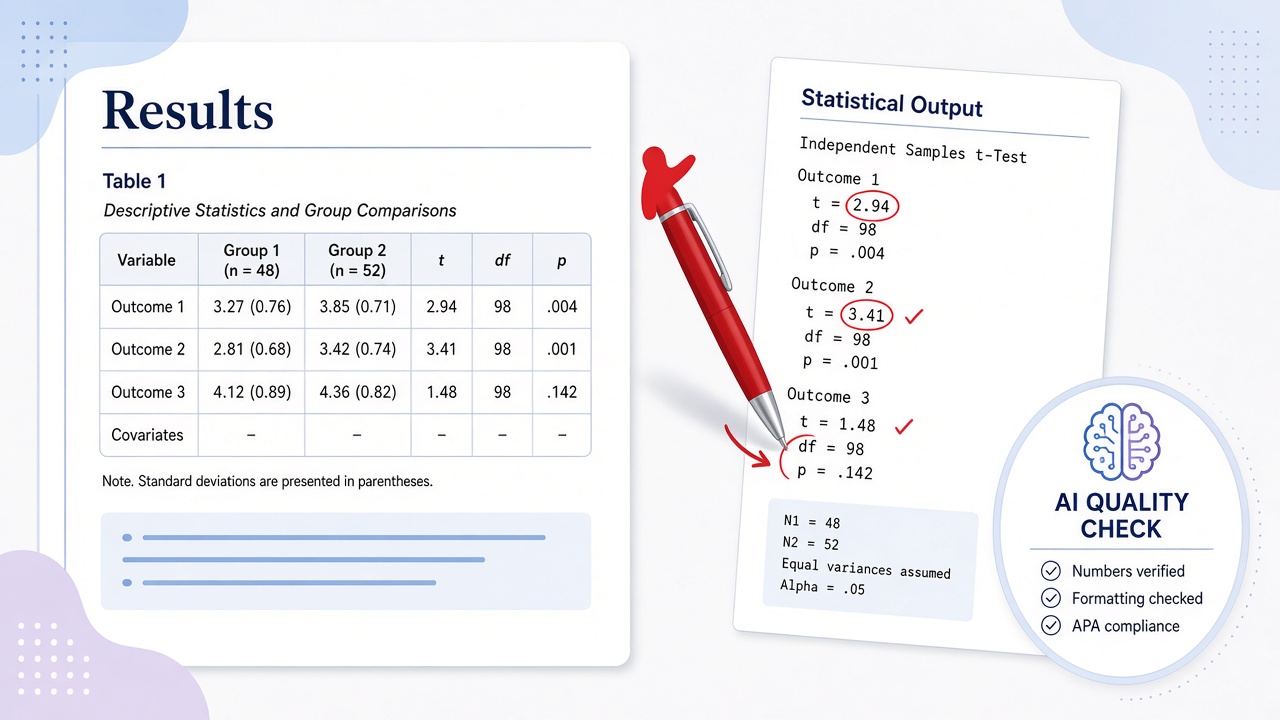
    نگارش و کنترل کیفیت فصل چهارم در تحلیل SPSS با ChatGPT
    نگارش و کنترل کیفیت فصل چهارم در تحلیل SPSS با ChatGPT

    پیش از نوشتن، یک قاعده‌ی کلی را در نظر بگیرید: متن فصل چهارم نباید تکرار کامل جدول‌ها باشد. جدول همه‌ی اعداد را نشان می‌دهد و متن باید مهم‌ترین یافته‌ها را برجسته کند و خواننده را به جدول ارجاع دهد. در تحلیل SPSS با ChatGPT، می‌توانید از ابزار بخواهید از هر جدول، فقط یک یا دو جمله‌ی کلیدی برای متن پیشنهاد دهد؛ سپس شما تصمیم بگیرید کدام جزئیات باید در متن بیاید و کدام فقط در جدول بماند. این تعادل، فصل چهارم را خواناتر و حرفه‌ای‌تر می‌کند و همان چیزی است که داوران مجلات هم هنگام انتشار مقاله انتظار دارند.

    نوشتن متن گزارش به سبک APA

    سبک APA پرکاربردترین سبک گزارش آماری در علوم انسانی، اجتماعی و رفتاری است. اصول کلیدی:

    • نماد آماره‌ها (مانند t، F، r، p، M، SD) به‌صورت ایتالیک نوشته می‌شوند.
    • مقدار p معمولاً به‌صورت دقیق (مثلاً p = .032) گزارش می‌شود و برای مقادیر بسیار کوچک، p < .001.
    • اعداد معمولاً با دو رقم اعشار گزارش می‌شوند، به‌جز مقدار p که ممکن است سه رقم داشته باشد.
    • در نسخه‌ی انگلیسی، برای مقادیری که نمی‌توانند بیشتر از ۱ باشند (مانند r و p)، صفر پیش از ممیز نوشته نمی‌شود.
    • گزارش اندازه‌ی اثر در کنار معناداری توصیه می‌شود.

    نمونه‌ی گزارش همبستگی:

    «نتایج ضریب همبستگی پیرسون نشان داد که بین حمایت اجتماعی ادراک‌شده و سلامت روان، رابطه‌ی مثبت و معناداری وجود دارد (r = .42, p < .001). بنابراین فرضیه‌ی اول پژوهش تأیید شد.»

    نمونه‌ی گزارش آزمون t:

    «نتایج آزمون t مستقل نشان داد که میانگین تاب‌آوری دانشجویان پسر (M = 68.45, SD = 9.12) به‌طور معناداری بیشتر از دانشجویان دختر (M = 64.20, SD = 10.35) است، t(278) = 3.62, p < .001, d = 0.44.»

    نمونه‌ی گزارش رگرسیون:

    «نتایج تحلیل رگرسیون چندگانه نشان داد که مدل در کل معنادار است، F(2, 277) = 45.80, p < .001، و حمایت اجتماعی و تاب‌آوری در مجموع ۲۵ درصد از واریانس سلامت روان را تبیین می‌کنند (R² = .25). تاب‌آوری (β = .38, p < .001) نسبت به حمایت اجتماعی (β = .21, p = .002) سهم بیشتری در پیش‌بینی سلامت روان داشت.»

    اعداد نمونه‌های بالا فرضی و فقط برای نشان دادن قالب هستند. در پایان‌نامه‌ی خود، فقط اعداد واقعی خروجی SPSS را گزارش کنید و هر عدد را دو بار با خروجی تطبیق دهید.

    برای جدول‌ها هم APA قالب مشخصی دارد: شماره و عنوان جدول بالای آن، خطوط افقی محدود و بدون خطوط عمودی، و یادداشت‌های توضیحی زیر جدول. ChatGPT می‌تواند جدول خروجی را به قالب APA تبدیل کند، اما پس از تبدیل، همه‌ی اعداد را دوباره با خروجی اصلی مقایسه کنید.

    نوشتن به فارسی و رعایت قالب: در پایان‌نامه‌های فارسی، معمولاً متن گزارش به فارسی است اما نمادها و اعداد آماری به‌صورت لاتین داخل پرانتز می‌آیند. یکدستی این قالب در کل فصل اهمیت دارد. همچنین شیوه‌نامه‌ی دانشگاه شما ممکن است درباره‌ی تعداد ارقام اعشار، استفاده از اعداد فارسی یا لاتین در جدول‌ها و نحوه‌ی شماره‌گذاری جدول‌ها قواعد خاصی داشته باشد. پیش از نگارش، شیوه‌نامه را به ChatGPT بدهید و بخواهید چک‌لیستی از قواعد قالب‌بندی فصل چهارم استخراج کند. این کار در مرحله‌ی ویرایش نهایی، زمان زیادی را صرفه‌جویی می‌کند.

    پرامپت‌های آماده برای فصل چهارم

    این پرامپت‌ها را بر اساس پژوهش خود تنظیم و استفاده کنید:

    • انتخاب آزمون: «طرح پژوهش من […] است، متغیر مستقل […] با سطح سنجش […] و متغیر وابسته […] با سطح سنجش […]. چه آزمون‌هایی ممکن است مناسب باشند و پیش‌فرض‌های هر کدام چیست؟ تصمیم نهایی را با استاد راهنما می‌گیرم.»
    • تفسیر جدول: «این جدول خروجی SPSS است. هر ستون را توضیح بده، مقادیر کلیدی برای گزارش را مشخص کن و بگو نتیجه با فرضیه‌ی من چه نسبتی دارد. هیچ عددی را تغییر نده.»
    • نوشتن گزارش: «با همین اعداد و بدون هیچ تغییری، یک پاراگراف گزارش به فارسی و با قالب APA برای فرضیه‌ی دوم بنویس.»
    • جدول APA: «این جدول را به قالب جدول APA تبدیل کن؛ عنوان پیشنهادی و یادداشت زیر جدول را هم بنویس.»
    • بررسی سازگاری: «این متن فصل چهارم من است و این جدول‌های خروجی. بررسی کن آیا همه‌ی اعداد متن با جدول‌ها یکسان است و اگر مغایرتی هست، فهرست کن.»
    • زبان مناسب: «این پاراگراف را بررسی کن و هر جا زبان علّی برای یافته‌های همبستگی به کار رفته، جایگزین مناسب پیشنهاد بده.»
    • جمع‌بندی: «بر اساس نتایج آزمون فرضیه‌ها، یک جدول خلاصه با ستون‌های فرضیه، آزمون، آماره، p و نتیجه (تأیید/رد) بساز.»

    پرامپت «بررسی سازگاری» یکی از ارزشمندترین‌هاست؛ چون خطاهای انتقال عدد از خروجی به متن بسیار رایج است و داوران به آن‌ها حساس‌اند. پرامپت‌های بیشتر را در بانک پرامپت‌های پژوهشی ریسرچ اینتل ببینید.

    از فصل چهارم به فصل پنجم: یکی از کاربردهای ارزشمند دیگر ChatGPT، کمک به گذار از گزارش یافته‌ها به بحث است. پس از اتمام فصل چهارم، جدول خلاصه‌ی نتایج را به ابزار بدهید و بپرسید: «برای هر یافته، چه سؤالاتی باید در فصل پنجم به آن‌ها پاسخ دهم؟» پاسخ معمولاً شامل مقایسه با مطالعات قبلی، تبیین نظری و پیامدهاست. یادتان باشد که فصل چهارم فقط گزارش است و تفسیر در فصل پنجم انجام می‌شود؛ ChatGPT گاهی در متن فصل چهارم جملات تفسیری اضافه می‌کند که باید آن‌ها را به فصل پنجم منتقل کنید.

    خطاهای رایج و ملاحظات اخلاقی

    خطاهای رایج فنی:

    1. گزارش ردیف اشتباه در آزمون t: بی‌توجهی به نتیجه‌ی آزمون لوین.
    2. نادیده گرفتن آزمون تعقیبی: گزارش ANOVA معنادار بدون مشخص کردن تفاوت گروه‌ها.
    3. خلط B و Beta: استفاده از ضریب غیراستاندارد برای مقایسه‌ی سهم پیش‌بین‌ها.
    4. تفسیر علّی از داده‌های همبستگی.
    5. نادیده گرفتن پیش‌فرض‌ها: اجرای آزمون پارامتریک بدون بررسی نرمال بودن یا همگنی واریانس.
    6. گزارش ناقص: ذکر فقط «معنادار بود» بدون آماره، درجه‌ی آزادی و مقدار p.
    7. گرد کردن یا جابه‌جایی اعداد در بازنویسی توسط ابزار.

    ملاحظات اخلاقی: فراتر از خطاهای فنی، برخی رفتارها در تحلیل داده، تخلف پژوهشی محسوب می‌شوند:

    • جعل داده (Fabrication): ساختن داده یا نتایجی که وجود ندارند.
    • تحریف داده (Falsification): تغییر اعداد، حذف داده‌های نامطلوب بدون توجیه یا گزارش انتخابی.
    • p-hacking: اجرای آزمون‌های متعدد، تغییر متغیرها یا حذف شرکت‌کنندگان تا زمانی که نتیجه «معنادار» شود، بدون گزارش شفاف این فرایند.
    • HARKing: نوشتن فرضیه پس از دیدن نتایج و ارائه‌ی آن به‌عنوان فرضیه‌ی از پیش تعیین‌شده.

    این رفتارها در رهنمودهای اخلاق نشر مانند COPE و ICMJE به‌عنوان تخلف جدی شناخته می‌شوند و می‌توانند به ابطال مدرک یا پس‌گرفتن مقاله منجر شوند. اگر ChatGPT یا هر کس دیگری پیشنهادی در این جهت داد، آن را رد کنید. اصول کلی را در صفحه‌ی صداقت علمی ببینید.

    اعلام استفاده: اگر از ChatGPT برای فهم خروجی یا ویرایش متن فصل چهارم استفاده کرده‌اید، با استاد راهنما هماهنگ کنید و در صورت لزوم اعلام کنید. اگر قصد دارید از این فصل مقاله استخراج کنید، قواعد مجلات را در استفاده از ChatGPT در مقاله و نحوه‌ی تبدیل فصل به بخش نتایج مقاله را در استخراج مقاله از پایان‌نامه ببینید.

    آمادگی برای دفاع: در جلسه‌ی دفاع، داوران معمولاً درباره‌ی دلیل انتخاب آزمون، بررسی پیش‌فرض‌ها، معنای اندازه‌ی اثر و محدودیت‌های تحلیل سؤال می‌پرسند. از ChatGPT بخواهید بر اساس فصل چهارم شما، ده سؤال آماری محتمل داوران را طرح کند. سپس بدون کمک ابزار به آن‌ها پاسخ دهید و پاسخ‌ها را با استاد یا مشاور آمار مرور کنید. این تمرین، مهم‌ترین تضمین برای این است که شما واقعاً تحلیل خود را فهمیده‌اید. اگر هنوز در مرحله‌ی طراحی روش هستید و می‌خواهید از ابتدا تحلیل مناسبی پیش‌بینی کنید، راهنمای نوشتن پروپوزال با هوش مصنوعی و صفحه‌ی نگارش پروپوزال را ببینید. برای آشنایی گسترده‌تر با کاربردهای هوش مصنوعی در پژوهش هم صفحه‌ی هوش مصنوعی در پژوهش و رویدادهای هفته پژوهش را دنبال کنید.

    جمع‌بندی: تحلیل SPSS با ChatGPT وقتی ارزشمند است که ابزار نقش «مفسر و ویراستار» داشته باشد، نه «تحلیلگر» یا «سازنده‌ی عدد». خروجی را با زمینه‌ی کامل و بدون اطلاعات هویتی به ابزار بدهید، معنای هر جدول و مقادیر کلیدی را بفهمید، گزارش را خودتان و مطابق APA بنویسید و هر عدد را با خروجی اصلی تطبیق دهید. انتخاب آزمون و تصمیم‌گیری درباره‌ی نتایج را با استاد راهنما و در صورت نیاز مشاور آمار انجام دهید. برای یادگیری عملی‌تر، دوره مقاله‌نویسی با هوش مصنوعی و مشاوره پژوهشی ریسرچ اینتل در کنار شماست و برای انتخاب ابزار مناسب، بهترین هوش مصنوعی برای پژوهش را بخوانید.

    برای آموزش‌ها و مشاوره‌های بیشتر پژوهشی به هوش پژوهشی سر بزنید.
  • مقایسه Elicit و Consensus و SciSpace برای مقاله‌نویسی

    مقایسه Elicit و Consensus و SciSpace برای مقاله‌نویسی

    ابزارهای هوش مصنوعی پژوهش در چند سال اخیر شیوه‌ی جست‌وجو، خواندن و سنتز مقالات علمی را به‌طور جدی تغییر داده‌اند. در میان ده‌ها ابزاری که ادعای کمک به پژوهشگران را دارند، سه نام بیش از بقیه در میان دانشجویان و پژوهشگران ایرانی شنیده می‌شود: Elicit، Consensus و SciSpace. هر سه وعده می‌دهند که مرور ادبیات را سریع‌تر و دقیق‌تر کنند، هر سه بر پایه‌ی پایگاه‌های بزرگ مقالات علمی کار می‌کنند و هر سه نسخه‌ی رایگان و پولی دارند. اما آیا واقعاً یکسان‌اند؟ و کدام یک برای مقاله‌نویسی شما مناسب‌تر است؟

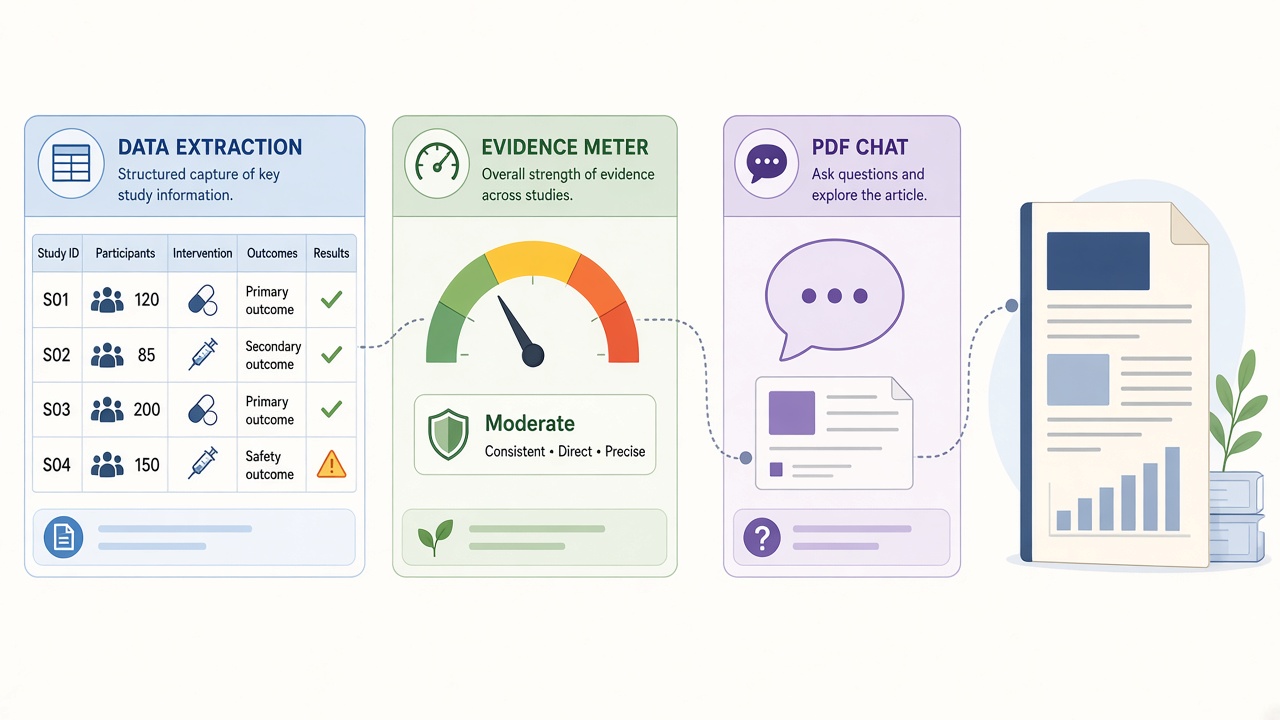
    پاسخ کوتاه این است که این سه ابزار برای کارهای متفاوتی طراحی شده‌اند. Elicit در استخراج ساختاریافته‌ی داده از مقالات و ساختن ماتریس پیشینه قوی است. Consensus در پاسخ سریع و مبتنی بر شواهد به سؤالات پژوهشی و نشان دادن جهت کلی ادبیات برتری دارد. و SciSpace در خواندن عمیق یک مقاله و گفت‌وگو با PDF، به‌ویژه برای مقالات پیچیده، کاربرد ویژه‌ای دارد. انتخاب درست، به مرحله‌ی پژوهش و نوع کاری که انجام می‌دهید بستگی دارد.

    در این مقاله، ابتدا هر سه ابزار را جداگانه معرفی می‌کنیم. سپس آن‌ها را از نظر پوشش داده، دقت، کاربرد در مراحل مختلف مقاله‌نویسی، هزینه و تجربه‌ی کاربری مقایسه می‌کنیم. در پایان، پیشنهاد می‌دهیم کدام ابزار برای چه کسی مناسب است و چگونه می‌توان آن‌ها را در یک جریان کاری ترکیبی و مسئولانه به کار گرفت.

    قابلیت‌ها، قیمت‌ها و محدودیت‌های این ابزارها به‌سرعت تغییر می‌کنند. این مقایسه بر اساس منطق کاربرد و تجربه‌ی عملی نوشته شده است. پیش از خرید اشتراک، صفحه‌ی رسمی هر ابزار را بررسی کنید و با نسخه‌ی رایگان آن‌ها را آزمایش کنید.

    چرا مقایسه‌ی این سه ابزار اهمیت دارد؟ چون بسیاری از دانشجویان یا فقط از یک ابزار برای همه‌ی کارها استفاده می‌کنند، یا هم‌زمان در هر سه ثبت‌نام می‌کنند و بدون شناخت تفاوت‌ها، از هیچ‌کدام بهره‌ی کامل نمی‌برند. در هر دو حالت، زمان و گاهی هزینه هدر می‌رود. شناخت دقیق نقاط قوت و ضعف هر ابزار، به شما کمک می‌کند جعبه‌ابزاری متناسب با نیاز خود بسازید و از ابزار درست در لحظه‌ی درست استفاده کنید. همچنین این شناخت، شما را از خطاهای رایج، مثل ارجاع به مقاله‌ای که فقط خلاصه‌ی آن را دیده‌اید، دور نگه می‌دارد.

    پیش از ادامه، یادآوری می‌کنیم که این ابزارها نه «نویسنده‌ی مقاله» هستند و نه «تضمین‌کننده‌ی انتشار». آن‌ها دستیارهایی برای جست‌وجو، خواندن و سازمان‌دهی‌اند. کیفیت مقاله‌ی نهایی همچنان به کیفیت سؤال پژوهش، طراحی روش، تحلیل داده و نگارش شما بستگی دارد.

    معرفی سه ابزار: Elicit، Consensus و SciSpace

    پیش از مقایسه، باید هر ابزار را بشناسیم: چه کسی آن را ساخته، بر چه پایگاهی کار می‌کند، قابلیت‌های اصلی‌اش چیست و فلسفه‌ی طراحی آن چه بوده است. این شناخت به شما کمک می‌کند بفهمید چرا هر ابزار در کاری خاص بهتر عمل می‌کند و در کاری دیگر ضعیف‌تر.

    معرفی Elicit و Consensus و SciSpace از ابزارهای هوش مصنوعی پژوهش
    معرفی Elicit و Consensus و SciSpace از ابزارهای هوش مصنوعی پژوهش

    پیش از معرفی، یک نکته‌ی مشترک را درباره‌ی هر سه ابزار بدانید: همه‌ی این ابزارهای هوش مصنوعی پژوهش بر پایه‌ی «بازیابی و سپس تولید» کار می‌کنند؛ یعنی ابتدا مقالات مرتبط را از پایگاه داده پیدا می‌کنند و سپس با کمک یک مدل زبانی، خلاصه یا پاسخ می‌سازند. به همین دلیل، کیفیت خروجی به دو چیز بستگی دارد: کیفیت جست‌وجو (آیا مقالات درستی پیدا شده‌اند؟) و کیفیت خلاصه‌سازی (آیا مدل مقالات را درست فهمیده است؟). هنگام ارزیابی هر پاسخ، هر دو را در نظر بگیرید.

    Elicit: دستیار استخراج داده و مرور ساختاریافته

    Elicit در اصل از دل یک سازمان پژوهشی غیرانتفاعی متمرکز بر هوش مصنوعی بیرون آمد و سپس به یک شرکت مستقل تبدیل شد. هدف اولیه‌ی آن، خودکارسازی بخش‌های وقت‌گیر مرور ادبیات بود؛ به‌ویژه استخراج اطلاعات از تعداد زیادی مقاله. Elicit عمدتاً بر پایگاه Semantic Scholar تکیه دارد که ده‌ها میلیون مقاله‌ی علمی را در رشته‌های مختلف پوشش می‌دهد.

    قابلیت‌های اصلی Elicit:

    • جست‌وجوی معنایی: به‌جای کلیدواژه، سؤال پژوهشی خود را به زبان طبیعی می‌پرسید؛ مثلاً «What is the effect of mindfulness training on nurse burnout?»
    • جدول استخراج: نتایج در قالب جدولی نمایش داده می‌شود که برای هر مقاله، ستون‌هایی مثل خلاصه، روش، حجم نمونه، جامعه و یافته‌ها دارد. می‌توانید ستون‌های سفارشی هم اضافه کنید؛ مثلاً «ابزار سنجش فرسودگی» یا «کشور».
    • کار با PDFهای خودتان: امکان بارگذاری مقالات و استخراج اطلاعات از آن‌ها در همان قالب جدولی.
    • گزارش‌های پژوهشی: تولید گزارش‌های خلاصه از مجموعه‌ای از مقالات درباره‌ی یک سؤال.
    • پشتیبانی از مرور نظام‌مند: امکاناتی برای غربالگری و استخراج داده در مرورهای نظام‌مند، که در نسخه‌های پیشرفته گسترده‌تر است.

    نقطه‌ی قوت اصلی: ساختن ماتریس پیشینه. اگر می‌خواهید برای فصل دوم پایان‌نامه یا مقدمه‌ی مقاله، اطلاعات ده‌ها مطالعه را در یک جدول مرتب کنید، Elicit یکی از بهترین گزینه‌هاست.

    نقطه‌ی ضعف: استخراج‌ها گاهی نادقیق‌اند، به‌ویژه برای اعداد و جزئیات روش. همچنین برای مقالاتی که متن کامل آن‌ها در دسترس آزاد نیست، استخراج فقط بر اساس چکیده انجام می‌شود که ممکن است ناقص باشد.

    یک مثال کاربردی از Elicit: فرض کنید درباره‌ی «اثر آموزش ذهن‌آگاهی بر فرسودگی شغلی پرستاران» پژوهش می‌کنید. در Elicit سؤال را به انگلیسی می‌پرسید و فهرستی از مقالات مرتبط با خلاصه‌ی یک‌جمله‌ای دریافت می‌کنید. سپس ستون‌هایی مانند «Intervention duration»، «Burnout measure»، «Sample size» و «Effect on emotional exhaustion» اضافه می‌کنید. در چند دقیقه، جدولی دارید که در حالت عادی ساعت‌ها وقت می‌گرفت. حالا نوبت شماست که مقالات کلیدی را باز کنید، اعداد را تطبیق دهید و جدول را برای ماتریس نهایی خود اصلاح کنید.

    Consensus: موتور پاسخ مبتنی بر شواهد

    Consensus با این ایده ساخته شد که پژوهشگران و حتی عموم مردم بتوانند سؤال بپرسند و پاسخی بر اساس شواهد علمی منتشرشده دریافت کنند، نه بر اساس محتوای عمومی وب. این ابزار نیز بر پایگاه‌های بزرگ مقالات علمی مانند Semantic Scholar و OpenAlex تکیه دارد و صدها میلیون سند را جست‌وجو می‌کند.

    قابلیت‌های اصلی Consensus:

    • پاسخ خلاصه با ارجاع: پس از پرسیدن سؤال، یک خلاصه‌ی کوتاه از آنچه ادبیات می‌گوید با ارجاع به مقالات مشخص ارائه می‌شود.
    • شاخص اجماع (Consensus Meter): برای سؤالات بله/خیر، نشان می‌دهد چه نسبتی از مطالعات بررسی‌شده پاسخ مثبت، منفی یا مشروط داده‌اند. این قابلیت برای دیدن «جهت کلی» ادبیات بسیار کاربردی است.
    • برچسب‌های کیفیت: نمایش نشانه‌هایی مثل نوع مطالعه (کارآزمایی تصادفی، متاآنالیز، مطالعه‌ی مشاهده‌ای)، تعداد ارجاعات و اعتبار مجله.
    • فیلترهای پیشرفته: محدود کردن نتایج بر اساس سال، نوع مطالعه، حجم نمونه، رشته و حتی کیفیت مجله.
    • جست‌وجوی عمیق‌تر: در نسخه‌های پیشرفته، امکان تحلیل تعداد بیشتری مقاله و تولید گزارش‌های مفصل‌تر.

    نقطه‌ی قوت اصلی: پاسخ سریع به سؤال «ادبیات درباره‌ی این موضوع چه می‌گوید؟». برای مرحله‌ی ایده‌پردازی، سنجش سریع یک فرضیه یا یافتن شواهد برای یک ادعا در مقدمه، بسیار مفید است.

    نقطه‌ی ضعف: برای سؤالات پیچیده‌ی چندمتغیره یا حوزه‌های میان‌رشته‌ای، خلاصه‌ها ممکن است بیش از حد ساده‌سازی شوند. شاخص اجماع هم فقط نسبت مطالعات را نشان می‌دهد، نه کیفیت و وزن آن‌ها را؛ ده مطالعه‌ی ضعیف ممکن است بر یک متاآنالیز قوی «غلبه» کنند.

    شاخص اجماع Consensus را با «حقیقت علمی» یکی نگیرید. این شاخص نشان می‌دهد چه نسبتی از مطالعات یافت‌شده چه گفته‌اند، نه اینکه شواهد چقدر قوی است. برای قضاوت درباره‌ی قوت شواهد، به نوع و کیفیت مطالعات توجه کنید.

    یک مثال کاربردی از Consensus: با همان موضوع، در Consensus می‌پرسید: «Does mindfulness training reduce burnout in nurses?» و پاسخی دریافت می‌کنید که نشان می‌دهد بیشتر مطالعات یافته‌شده اثر کاهشی گزارش کرده‌اند، به‌همراه چند مطالعه با نتایج مشروط. سپس با فیلتر «Meta-analysis» یا «RCT» نتایج را به مطالعات با کیفیت بالاتر محدود می‌کنید. این تصویر سریع به شما کمک می‌کند در بیان مسئله دقیق‌تر بنویسید که شکاف کجاست؛ مثلاً شاید مطالعات کمی در بافت ایرانی یا با پیگیری بلندمدت انجام شده باشد.

    SciSpace: گفت‌وگو با مقاله و دستیار خواندن

    SciSpace (که پیش‌تر با نام Typeset شناخته می‌شد) در ابتدا ابزاری برای قالب‌بندی مقالات بود، اما به‌تدریج به یک پلتفرم گسترده‌ی هوش مصنوعی پژوهشی تبدیل شد. معروف‌ترین قابلیت آن، دستیار خواندن مقاله است که به شما اجازه می‌دهد با یک PDF گفت‌وگو کنید.

    قابلیت‌های اصلی SciSpace:

    • دستیار خواندن (Copilot/Chat with PDF): مقاله‌ای را باز می‌کنید و درباره‌ی بخش‌های آن سؤال می‌پرسید. می‌توانید یک پاراگراف، جدول یا فرمول را انتخاب کنید و توضیح بخواهید.
    • جست‌وجوی ادبیات: امکان جست‌وجوی مقالات با سؤال پژوهشی و نمایش نتایج در قالب جدول با ستون‌های قابل‌تنظیم، مشابه Elicit.
    • استخراج داده از PDFها: بارگذاری چند مقاله و استخراج اطلاعات مشخص از همه‌ی آن‌ها.
    • ابزارهای نگارشی: شامل بازنویس (Paraphraser)، دستیار نگارش، تولیدکننده‌ی ارجاع و ابزار تشخیص متن هوش مصنوعی.
    • پشتیبانی چندزبانه: امکان پرسیدن سؤال و دریافت پاسخ به زبان‌های مختلف، از جمله فارسی.

    نقطه‌ی قوت اصلی: فهم عمیق یک مقاله‌ی پیچیده. وقتی با مقاله‌ای پر از فرمول، روش آماری ناآشنا یا اصطلاحات تخصصی روبه‌رو هستید، SciSpace می‌تواند بخش‌به‌بخش آن را توضیح دهد.

    نقطه‌ی ضعف: گستردگی قابلیت‌ها گاهی باعث سردرگمی می‌شود. همچنین برخی ابزارهای نگارشی آن، به‌ویژه بازنویس، اگر به‌شکل نادرست استفاده شوند، با اصول صداقت علمی در تعارض قرار می‌گیرند.

    یک قاعده‌ی کلی: Elicit برای «جدول»، Consensus برای «جواب» و SciSpace برای «فهم» مقاله.

    یک مثال کاربردی از SciSpace: فرض کنید یک متاآنالیز کلیدی در حوزه‌ی خود پیدا کرده‌اید که از مدل اثرات تصادفی و آزمون ناهمگنی استفاده کرده و شما با این مفاهیم آشنا نیستید. مقاله را در SciSpace باز می‌کنید، جدول نتایج را انتخاب می‌کنید و می‌پرسید: «I² در این جدول چه معنایی دارد و چرا نویسندگان مدل اثرات تصادفی را انتخاب کرده‌اند؟» پاسخ به شما کمک می‌کند مقاله را با فهم بهتری بخوانید و آن را درست در پیشینه نقل کنید. البته اگر قرار است از این مفاهیم در تحلیل خودتان استفاده کنید، منابع آموزشی معتبر یا مشاوره‌ی آماری را هم در نظر بگیرید؛ صفحه‌ی تحلیل آماری در این زمینه کمک می‌کند.

    مقایسه‌ی رودرروی ابزارهای هوش مصنوعی پژوهش

    حالا که هر ابزار را شناختیم، آن‌ها را در سه محور اصلی کنار هم قرار می‌دهیم: پوشش داده و دقت، کاربرد در مراحل مختلف مقاله‌نویسی، و هزینه، زبان و تجربه‌ی کاربری. این مقایسه کمک می‌کند بدانید در هر موقعیت، کدام ابزار را باز کنید.

    مقایسه رودرروی ابزارهای هوش مصنوعی پژوهش
    مقایسه رودرروی ابزارهای هوش مصنوعی پژوهش

    در ارزیابی ابزارهای هوش مصنوعی پژوهش، یک اشتباه رایج این است که فقط به «تعداد مقالات پایگاه» توجه کنیم. در عمل، آنچه اهمیت بیشتری دارد، کیفیت رتبه‌بندی نتایج، دقت استخراج و میزان شفافیت در نمایش منبع است. ابزاری که مقالات کمتری را پوشش می‌دهد اما مرتبط‌ترین آن‌ها را در صدر نتایج می‌آورد و هر ادعا را به جمله‌ی دقیق منبع پیوند می‌دهد، برای پژوهشگر ارزشمندتر از ابزاری است که فهرستی طولانی از نتایج کم‌ارتباط ارائه می‌دهد.

    پوشش داده، دقت و قابلیت استناد

    هر سه ابزار از پایگاه‌های بزرگ و باز مقالات علمی استفاده می‌کنند و بنابراین پوشش آن‌ها تا حد زیادی هم‌پوشانی دارد. چند نکته‌ی مهم درباره‌ی پوشش:

    • مقالات پولی: هیچ‌کدام دسترسی کامل به متن مقالات پشت دیوار پرداخت ندارند. برای این مقالات، معمولاً فقط چکیده تحلیل می‌شود، مگر اینکه خودتان PDF را بارگذاری کنید.
    • مقالات فارسی: پوشش مقالات فارسی‌زبان و پایگاه‌های داخلی مثل SID، Magiran و نورمگز بسیار محدود است. برای پیشینه‌ی داخلی، همچنان باید مستقیماً در این پایگاه‌ها جست‌وجو کنید.
    • مقالات بسیار جدید: ممکن است با تأخیر وارد پایگاه‌ها شوند.
    • رشته‌ها: پوشش علوم پزشکی و زیستی معمولاً قوی‌تر از برخی رشته‌های علوم انسانی و هنر است.

    درباره‌ی دقت، تجربه‌ی کاربران و ارزیابی‌های مستقل نشان می‌دهد که هر سه ابزار در یافتن مقالات مرتبط عملکرد قابل‌قبولی دارند و برخلاف چت‌بات‌های عمومی، معمولاً منبع ساختگی تولید نمی‌کنند، چون پاسخ‌ها به مقالات واقعی پیوند دارند. اما خطاهای دیگری رایج است:

    1. استخراج نادرست اعداد: حجم نمونه، اندازه‌ی اثر یا ضرایب گاهی اشتباه استخراج می‌شوند.
    2. خلط یافته و فرضیه: گاهی آنچه نویسندگان انتظار داشتند به‌عنوان یافته گزارش می‌شود.
    3. تعمیم نادرست: یافته‌ی یک زیرگروه به کل نمونه نسبت داده می‌شود.
    4. خلاصه‌ی سطحی: ظرافت‌های بحث و محدودیت‌ها در خلاصه حذف می‌شوند.

    برای هر مقاله‌ای که قرار است در متن مقاله یا پایان‌نامه‌ی خود به آن ارجاع دهید، دست‌کم چکیده و بخش مرتبط را در متن اصلی بخوانید. استخراج ابزار را «پیش‌نویس یادداشت» بدانید، نه «حقیقت نهایی».

    قابلیت استناد: هر سه ابزار لینک مقاله‌ی اصلی و اطلاعات کتاب‌شناختی را ارائه می‌دهند و امکان خروجی گرفتن برای نرم‌افزارهای مدیریت منابع مثل Zotero را دارند. با این حال، اطلاعات کتاب‌شناختی را پیش از درج در فهرست منابع، با سایت ناشر یا Google Scholar تطبیق دهید.

    یک آزمون شخصی برای سنجش دقت: برای اینکه بدانید هر ابزار در حوزه‌ی شما چقدر دقیق است، پنج مقاله‌ی کلیدی را که به‌خوبی می‌شناسید انتخاب کنید. همین مقالات را در هر سه ابزار جست‌وجو یا بارگذاری کنید و خلاصه و استخراج آن‌ها را با دانسته‌های خود مقایسه کنید. تعداد خطاها، نوع خطاها و میزان کامل بودن اطلاعات را یادداشت کنید. این آزمون نیم‌ساعته، تصویری بسیار دقیق‌تر از هر مقایسه‌ی عمومی به شما می‌دهد، چون عملکرد ابزارها در رشته‌ها و انواع مطالعات مختلف یکسان نیست.

    کاربرد در مراحل مختلف مقاله‌نویسی

    جدول زیر، کاربرد نسبی هر ابزار را در مراحل اصلی مقاله‌نویسی نشان می‌دهد:

    مرحله Elicit Consensus SciSpace
    ایده‌پردازی و سنجش اولیه‌ی موضوع مناسب بسیار مناسب مناسب
    یافتن مقالات کلیدی بسیار مناسب بسیار مناسب مناسب
    ساختن ماتریس پیشینه بسیار مناسب محدود مناسب
    فهم عمیق یک مقاله‌ی پیچیده محدود محدود بسیار مناسب
    یافتن شواهد برای یک ادعا در مقدمه مناسب بسیار مناسب مناسب
    مقایسه‌ی یافته‌ها در بخش بحث مناسب مناسب مناسب
    پشتیبانی از مرور نظام‌مند مناسب (با بررسی انسانی) محدود محدود

    مرحله‌ی ایده‌پردازی: Consensus با پاسخ‌های سریع و شاخص اجماع، به شما نشان می‌دهد آیا یک موضوع بسیار کار شده، تناقض دارد یا کمتر بررسی شده است. این اطلاعات برای انتخاب موضوع و نوشتن بیان مسئله ارزشمند است. راهنمای کامل این مرحله را در نوشتن پروپوزال با هوش مصنوعی آورده‌ایم.

    مرحله‌ی مرور ادبیات: Elicit با جدول استخراج، بهترین ابزار برای ساختن ماتریس است. SciSpace هم قابلیت مشابهی دارد و برای خواندن عمیق مقالات منتخب برتری دارد.

    مرحله‌ی نگارش مقدمه و بحث: وقتی به شواهد برای یک ادعای خاص نیاز دارید، مثلاً «مطالعات قبلی رابطه‌ی مثبتی میان X و Y یافته‌اند»، Consensus سریع‌ترین راه برای یافتن مقالات پشتیبان یا مخالف است. برای مقایسه‌ی یافته‌های خود با مطالعات قبلی در بخش بحث هم هر سه ابزار کمک می‌کنند.

    مرور نظام‌مند: اگر مرور نظام‌مند انجام می‌دهید، باید از استاندارد PRISMA پیروی کنید و جست‌وجو را در پایگاه‌های تخصصی مثل Scopus، Web of Science و PubMed انجام دهید. این ابزارها می‌توانند در غربالگری و استخراج کمک کنند، اما جایگزین فرایند نظام‌مند و داوری انسانی نیستند.

    پرامپت‌ها و سؤال‌های مؤثر: کیفیت نتایج در هر سه ابزار به نحوه‌ی طرح سؤال بستگی دارد. چند نکته: سؤال را مشخص و با متغیرهای دقیق بپرسید («effect of X on Y in Z population» به‌جای «X and Y»)؛ برای ستون‌های سفارشی Elicit، تعریف روشن و کوتاه بنویسید («Instrument used to measure burnout, with name and number of items»)؛ و در SciSpace، به‌جای «این مقاله را توضیح بده»، بخش مشخصی را انتخاب کنید و سؤال هدفمند بپرسید. پرامپت‌های بیشتر و دسته‌بندی‌شده را در بانک پرامپت‌های پژوهشی ریسرچ اینتل ببینید.

    بخش نتایج مقاله: این ابزارها در نوشتن بخش نتایج نقش مستقیمی ندارند، چون نتایج باید از داده‌های خود شما بیاید. اما پس از گزارش نتایج، می‌توانید با Consensus یا Elicit بررسی کنید که آیا اندازه‌ی اثر یا جهت رابطه‌ای که یافته‌اید، با ادبیات هم‌خوان است یا نه. این مقایسه، ماده‌ی خام نوشتن بخش بحث است. اگر نتایج شما خلاف جهت غالب ادبیات بود، نگران نشوید؛ این می‌تواند یکی از جذاب‌ترین بخش‌های بحث مقاله باشد، به شرطی که آن را صادقانه گزارش و با دقت تبیین کنید.

    هزینه، پشتیبانی از فارسی و تجربه‌ی کاربری

    هزینه: هر سه ابزار یک نسخه‌ی رایگان با محدودیت دارند. محدودیت‌های رایج نسخه‌ی رایگان: تعداد جست‌وجو یا اعتبار (Credit) محدود در ماه، دسترسی محدود به قابلیت‌های پیشرفته مثل گزارش‌های عمیق یا استخراج از تعداد زیاد مقاله، و محدودیت در بارگذاری PDF. نسخه‌های پولی معمولاً به‌صورت اشتراک ماهانه یا سالانه ارائه می‌شوند و برای دانشجویان گاهی تخفیف دارند.

    برای بیشتر دانشجویان ارشد، نسخه‌های رایگان این ابزارها، به‌ویژه اگر با هم ترکیب شوند، کافی است. دانشجویان دکتری یا کسانی که مرور گسترده انجام می‌دهند، ممکن است از اشتراک یکی از آن‌ها، معمولاً Elicit یا SciSpace، بهره‌ی بیشتری ببرند. برای اطلاع از گزینه‌های تهیه‌ی اشتراک، صفحه‌ی خرید اکانت هوش مصنوعی را ببینید.

    پشتیبانی از فارسی: هر سه ابزار عمدتاً برای مقالات انگلیسی طراحی شده‌اند. SciSpace امکان پرسیدن سؤال و دریافت پاسخ به فارسی را بهتر پشتیبانی می‌کند. در Elicit و Consensus، توصیه می‌کنیم سؤال‌ها را به انگلیسی و با اصطلاحات تخصصی دقیق بپرسید تا نتایج بهتری بگیرید.

    تجربه‌ی کاربری:

    • Consensus: ساده‌ترین رابط؛ در چند دقیقه می‌توان با آن کار کرد.
    • Elicit: رابط جدولی کارآمد، اما برای استفاده‌ی کامل از ستون‌های سفارشی و گزارش‌ها نیاز به تمرین دارد.
    • SciSpace: امکانات گسترده‌ای دارد که می‌تواند در ابتدا گیج‌کننده باشد؛ اما خواننده‌ی PDF آن بسیار کاربرپسند است.

    حریم خصوصی: اگر PDFهای خودتان، به‌ویژه پیش‌نویس‌های منتشرنشده یا داده‌های حساس را در این ابزارها بارگذاری می‌کنید، سیاست حریم خصوصی هر کدام را بخوانید. مقالات منتشرشده‌ی دیگران معمولاً مشکل محرمانگی ندارند، اما پیش‌نویس مقاله‌ی خودتان یا مقالاتی که برای داوری دریافت کرده‌اید، باید با احتیاط بیشتری مدیریت شوند. مقالات تحت داوری را هرگز در این ابزارها بارگذاری نکنید، چون نقض محرمانگی داوری محسوب می‌شود.

    جمع‌بندی مقایسه: اگر بخواهیم مقایسه را در یک پاراگراف خلاصه کنیم: Consensus سریع‌ترین راه برای فهمیدن «ادبیات چه می‌گوید» است؛ Elicit کارآمدترین راه برای «سازمان‌دهی آنچه ادبیات می‌گوید» در قالب جدول؛ و SciSpace بهترین راه برای «فهمیدن عمیق یک مقاله‌ی خاص». هیچ‌کدام همه‌ی نیازهای شما را برآورده نمی‌کنند و ترکیب هوشمندانه‌ی آن‌ها، بیشترین بازده را دارد.

    مطالعهٔ تکمیلی: اگر می‌خواهید این موضوع را عمیق‌تر و بر پایهٔ یک منبع معتبر دانشگاهی دنبال کنید، راهنماهای طراحی پژوهش با هوش مصنوعی، هوش مصنوعی در پژوهش دانشگاهی و آینده هوش مصنوعی در پژوهش را هم در ریسرچ اینتل بخوانید.

    کدام ابزار برای شما مناسب است؟ جریان کاری و اخلاق

    پس از مقایسه، سؤال عملی این است که کدام ابزار یا چه ترکیبی برای شما مناسب است. در این بخش، پیشنهادهایی بر اساس نوع کاربر ارائه می‌دهیم، یک جریان کاری ترکیبی برای مقاله‌نویسی معرفی می‌کنیم و اشتباهات رایج و اصول اخلاقی استفاده از این ابزارها را مرور می‌کنیم.

    جریان کاری ترکیبی با ابزارهای هوش مصنوعی پژوهش برای مقاله‌نویسی
    جریان کاری ترکیبی با ابزارهای هوش مصنوعی پژوهش برای مقاله‌نویسی

    یک قاعده‌ی ساده برای انتخاب: اگر هنوز نمی‌دانید از کدام ابزار شروع کنید، به سؤالی که همین حالا در ذهن دارید نگاه کنید. اگر سؤال شما «آیا…؟» یا «چه شواهدی وجود دارد؟» است، Consensus را باز کنید. اگر سؤال شما «این مطالعات چه روش‌ها و یافته‌هایی دارند؟» است، سراغ Elicit بروید. و اگر سؤال شما «این مقاله دقیقاً چه می‌گوید؟» است، SciSpace یا NotebookLM پاسخ بهتری می‌دهند. این قاعده‌ی ساده، بیشتر موقعیت‌های روزمره‌ی کار با ابزارهای هوش مصنوعی پژوهش را پوشش می‌دهد.

    کدام ابزار برای چه کسی؟

    اگر تازه پژوهش را شروع کرده‌اید (کارشناسی ارشد، اولین مقاله): با Consensus شروع کنید. سادگی آن به شما کمک می‌کند سریع با ادبیات حوزه آشنا شوید. سپس برای ساختن ماتریس پیشینه، نسخه‌ی رایگان Elicit را امتحان کنید.

    اگر دانشجوی دکتری هستید یا مرور گسترده انجام می‌دهید: Elicit با جدول‌های استخراج و ستون‌های سفارشی، بیشترین ارزش افزوده را دارد. برای خواندن عمیق مقالات کلیدی هم SciSpace یا NotebookLM را کنار آن به کار بگیرید.

    اگر با مقالات فنی و پیچیده سروکار دارید (مهندسی، آمار، علوم پایه): SciSpace با توانایی توضیح فرمول‌ها، جدول‌ها و روش‌ها، دستیار خواندن بسیار مفیدی است.

    اگر در علوم پزشکی کار می‌کنید: Consensus با برچسب‌های نوع مطالعه و فیلتر کیفیت، برای یافتن شواهد بالینی مفید است. اما همیشه آن را با جست‌وجو در PubMed تکمیل کنید.

    اگر به دنبال اپلای هستید: برای نوشتن Research Proposal کوتاه یا آماده شدن برای مصاحبه با استاد، Consensus و Elicit به شما کمک می‌کنند سریع با ادبیات حوزه‌ی استاد آشنا شوید. نکات تنظیم رزومه را هم در صفحه‌ی رزومه دکتری ببینید.

    برای مقایسه‌ی این سه ابزار با دستیارهای عمومی و ابزارهای دیگر، مقاله‌ی بهترین هوش مصنوعی برای پژوهش را بخوانید.

    اگر پایان‌نامه می‌نویسید: برای هر فصل، کاربرد متفاوتی از این ابزارها دارید. در فصل اول، Consensus برای تقویت بیان مسئله با شواهد؛ در فصل دوم، Elicit برای ماتریس پیشینه و SciSpace برای خواندن مقالات نظری کلیدی؛ و در فصل پنجم، هر سه برای یافتن مطالعات قابل‌مقایسه با یافته‌های شما. راهنمای کامل را در نوشتن پایان‌نامه با هوش مصنوعی و صفحه‌ی نگارش پایان‌نامه ببینید.

    جریان کاری ترکیبی برای مقاله‌نویسی

    قدرت واقعی این ابزارها زمانی آشکار می‌شود که آن‌ها را در یک جریان کاری ترکیبی به کار بگیرید. پیشنهاد ما:

    1. سنجش اولیه با Consensus: سؤال پژوهشی را بپرسید و تصویر کلی ادبیات را ببینید. چند مقاله‌ی کلیدی و پرارجاع را یادداشت کنید.
    2. جست‌وجوی تکمیلی: با کلیدواژه‌های دقیق در Google Scholar، Scopus و پایگاه‌های داخلی جست‌وجو کنید.
    3. استخراج با Elicit: مقالات منتخب را در Elicit جست‌وجو یا بارگذاری کنید و جدول استخراج با ستون‌های موردنیاز بسازید.
    4. مدیریت در Zotero: همه‌ی مقالات را با برچسب مناسب در Zotero ذخیره کنید.
    5. خواندن عمیق با SciSpace یا NotebookLM: مقالات کلیدی را بخوانید و برای بخش‌های پیچیده از دستیار کمک بگیرید. آموزش NotebookLM را در NotebookLM برای پژوهش ببینید.
    6. تطبیق و تکمیل ماتریس: هر خانه‌ی ماتریس را با متن اصلی تطبیق دهید.
    7. سنتز و نگارش: خودتان متن را بنویسید و برای ویرایش زبانی از یک دستیار عمومی کمک بگیرید.

    این جریان کاری، هم سرعت را بالا می‌برد و هم دقت را حفظ می‌کند، چون در هر مرحله به منابع واقعی متکی است و شما تصمیم‌گیرنده‌ی نهایی هستید. برای ادامه‌ی مسیر، یعنی تبدیل پیشینه به مقاله، راهنمای مقاله‌نویسی علمی با هوش مصنوعی را بخوانید.

    یک نکته‌ی تکمیلی درباره‌ی این جریان کاری: نتایج هر مرحله را مستند کنید. مثلاً تاریخ جست‌وجو، سؤال یا کلیدواژه‌های استفاده‌شده و تعداد نتایج را ثبت کنید. این مستندسازی، به‌ویژه اگر قصد دارید بخشی از پیشینه را به مقاله‌ی مروری تبدیل کنید، بسیار ارزشمند است و گزارش‌دهی شفاف روش جست‌وجو را ممکن می‌کند. همچنین وقتی مجله‌ای را برای ارسال انتخاب می‌کنید، دقت کنید که مقالات کلیدی پیشینه‌ی شما در چه مجلاتی منتشر شده‌اند؛ این فهرست، نقطه‌ی شروع خوبی برای انتخاب مجله‌ی معتبر و پرهیز از مجلات جعلی است.

    اشتباهات رایج، اخلاق و اعلام استفاده

    چند اشتباه رایج که در استفاده از این ابزارها دیده می‌شود:

    • ارجاع به مقاله‌ای که خوانده نشده: فقط بر اساس خلاصه‌ی ابزار، مقاله‌ای را در متن ارجاع دادن.
    • کپی خلاصه‌ها در متن: خلاصه‌های تولیدشده را مستقیماً در پیشینه قرار دادن.
    • استفاده از بازنویس برای پنهان کردن شباهت: بازنویسی متن دیگران با ابزار برای عبور از همانندجو، نوعی سرقت علمی است.
    • اعتماد به شاخص اجماع به‌عنوان حکم نهایی: نادیده گرفتن کیفیت و نوع مطالعات.
    • نادیده گرفتن ادبیات فارسی: فقط به نتایج این ابزارها تکیه کردن و از دست دادن پیشینه‌ی داخلی.

    از نظر اخلاقی، استفاده از این ابزارها برای یافتن، سازمان‌دهی و فهم مقالات کاملاً پذیرفته است. اما هر محتوایی که در متن شما قرار می‌گیرد، باید نوشته‌ی خودتان باشد و هر ادعایی باید به منبع اصلی‌ای برسد که خودتان بررسی کرده‌اید. رهنمودهای COPE و ICMJE بر مسئولیت کامل نویسندگان و شفافیت در استفاده از ابزارهای هوش مصنوعی تأکید دارند.

    اگر از این ابزارها فقط برای جست‌وجو و یافتن مقالات استفاده کرده‌اید، معمولاً نیازی به اعلام در بخش هوش مصنوعی مولد نیست. اما اگر از قابلیت‌های نگارشی آن‌ها (مانند دستیار نگارش یا بازنویس) استفاده کرده‌اید یا در مرور نظام‌مند از آن‌ها برای غربالگری بهره برده‌اید، باید در بخش روش یا اعلام، شفاف ذکر کنید. جزئیات و نمونه‌متن‌ها را در استفاده از ChatGPT در مقاله ببینید.

    درباره‌ی ابزارهای بازنویس و آشکارساز: برخی از این پلتفرم‌ها، به‌ویژه SciSpace، ابزارهای بازنویسی (Paraphraser) و تشخیص متن هوش مصنوعی را هم ارائه می‌دهند. بازنویس می‌تواند برای روان‌سازی متن خودتان مفید باشد، اما استفاده از آن برای تغییر ظاهری متن دیگران و ارائه‌ی آن به نام خود، سرقت علمی است. ابزارهای تشخیص متن هوش مصنوعی هم دقت محدودی دارند و نباید مبنای قضاوت قطعی قرار گیرند. اصول کلی را در صفحه‌ی صداقت علمی ببینید. برای آشنایی با کل مسیر از مرور ادبیات تا ارسال مقاله، صفحه‌های هوش مصنوعی در پژوهش و انتشار مقاله را هم دنبال کنید و برای تمرین عملی، رویدادهای هفته پژوهش فرصت خوبی است.

    جمع‌بندی: Elicit، Consensus و SciSpace سه ابزار هوش مصنوعی پژوهش هستند که هر کدام در کاری متمایز برتری دارند: Elicit در استخراج ساختاریافته و ساختن ماتریس، Consensus در پاسخ سریع مبتنی بر شواهد و SciSpace در فهم عمیق مقاله. هیچ‌کدام جایگزین جست‌وجوی نظام‌مند، خواندن منابع اصلی و قضاوت پژوهشی شما نیستند، اما در یک جریان کاری ترکیبی و مسئولانه، می‌توانند زمان مرور ادبیات را به‌طور چشمگیری کاهش دهند. برای یادگیری عملی این ابزارها، دوره مقاله‌نویسی با هوش مصنوعی و صفحه‌ی مرور ادبیات ریسرچ اینتل را ببینید و اگر به همراهی تخصصی نیاز دارید، مشاوره پژوهشی در کنار شماست.

    برای آموزش‌ها و مشاوره‌های بیشتر پژوهشی به هوش پژوهشی سر بزنید.
  • آموزش NotebookLM برای پژوهش و مرور ادبیات

    آموزش NotebookLM برای پژوهش و مرور ادبیات

    NotebookLM برای پژوهش یکی از کاربردی‌ترین ابزارهای هوش مصنوعی است که در سال‌های اخیر در دسترس دانشجویان و پژوهشگران قرار گرفته است. اگر تجربه‌ی کار با چت‌بات‌های عمومی را داشته باشید، احتمالاً با مشکل همیشگی آن‌ها روبه‌رو شده‌اید: پاسخ‌هایی روان و قانع‌کننده که گاهی هیچ منبع واقعی پشتشان نیست. NotebookLM، ابزار رایگان گوگل، رویکرد متفاوتی دارد. این ابزار فقط بر اساس منابعی پاسخ می‌دهد که خودتان به آن داده‌اید و برای هر ادعا، به بخش دقیق منبع ارجاع می‌دهد.

    این ویژگی، NotebookLM را به دستیاری ایده‌آل برای مرحله‌ای تبدیل می‌کند که بسیاری از دانشجویان بیشترین وقت را در آن صرف می‌کنند: خواندن، فهمیدن و سنتز ده‌ها یا صدها مقاله برای نوشتن پیشینه‌ی پژوهش. تصور کنید سی مقاله‌ی کلیدی پایان‌نامه‌ی خود را در یک نوت‌بوک بارگذاری کرده‌اید و می‌توانید بپرسید: «کدام مطالعات از روش طولی استفاده کرده‌اند و یافته‌هایشان چه تفاوتی با مطالعات مقطعی دارد؟» و پاسخی دریافت کنید که هر جمله‌اش به مقاله و پاراگراف مشخصی ارجاع دارد.

    در این آموزش جامع، ابتدا NotebookLM را معرفی می‌کنیم، قابلیت‌ها و محدودیت‌هایش را بررسی می‌کنیم و نکات حریم خصوصی را مرور می‌کنیم. سپس به‌صورت گام‌به‌گام نشان می‌دهیم چگونه نوت‌بوک بسازید، منابع اضافه کنید، سؤال بپرسید و خروجی‌های مختلف تولید کنید. در نهایت، یک جریان کاری کامل برای مرور ادبیات با NotebookLM ارائه می‌دهیم، همراه با پرامپت‌های آماده و نکاتی برای ترکیب آن با ابزارهای دیگر و رعایت اخلاق پژوهش.

    قابلیت‌ها، محدودیت‌ها و رابط کاربری NotebookLM به‌طور مرتب به‌روز می‌شوند. آنچه در این آموزش آمده، بر اساس وضعیت ابزار در زمان نگارش است. اگر گزینه‌ای را در جای متفاوتی دیدید، منطق کار همان است.

    چرا این موضوع برای دانشجویان ایرانی اهمیت ویژه‌ای دارد؟ بسیاری از دانشجویان ما مجبورند مقالات انگلیسی متعدد را با سرعت بخوانند، در حالی که زبان انگلیسی زبان دوم آن‌هاست. NotebookLM می‌تواند به‌عنوان یک «پل فهم» عمل کند: می‌توانید درباره‌ی مقاله‌ای انگلیسی به فارسی سؤال بپرسید، مفاهیم پیچیده را به زبان ساده توضیح بخواهید و سپس با فهم بهتر، متن اصلی را بخوانید. این کاربرد، اگر درست انجام شود، نه‌تنها سرعت کار را بالا می‌برد بلکه به تقویت مهارت خواندن انگلیسی آکادمیک هم کمک می‌کند، چون شما همچنان با متن اصلی سروکار دارید.

    NotebookLM چیست و چرا برای پژوهش مناسب است؟

    پیش از ورود به آموزش عملی، باید بدانیم NotebookLM دقیقاً چه کاری انجام می‌دهد، چه تفاوتی با چت‌بات‌های عمومی دارد، چه قابلیت‌هایی برای پژوهشگران دارد و کجا نباید به آن تکیه کرد. این شناخت به شما کمک می‌کند انتظارات واقع‌بینانه‌ای داشته باشید و ابزار را در جای درست جریان کاری خود قرار دهید.

    تفاوت NotebookLM برای پژوهش با چت‌بات‌های عمومی
    تفاوت NotebookLM برای پژوهش با چت‌بات‌های عمومی

    معرفی NotebookLM و تفاوت آن با چت‌بات‌های عمومی

    NotebookLM یک «دستیار پژوهشی مبتنی بر منبع» است. واحد اصلی کار در آن «نوت‌بوک» است؛ فضایی که شما در آن مجموعه‌ای از منابع را بارگذاری می‌کنید و سپس با آن منابع گفت‌وگو می‌کنید. مدل زبانی پشت NotebookLM از خانواده‌ی مدل‌های Gemini گوگل است، اما نحوه‌ی کار آن با Gemini یا ChatGPT در حالت عادی متفاوت است.

    تفاوت‌های کلیدی:

    • منبع پاسخ: چت‌بات‌های عمومی از دانش آموخته‌شده‌ی خود پاسخ می‌دهند؛ NotebookLM تلاش می‌کند فقط از منابع بارگذاری‌شده‌ی شما پاسخ دهد.
    • ارجاع درون‌متنی: هر بخش از پاسخ NotebookLM یک شماره‌ی ارجاع دارد که با کلیک روی آن، جمله یا پاراگراف دقیق منبع نمایش داده می‌شود.
    • کاهش توهم: چون پاسخ به منابع شما محدود است، احتمال تولید اطلاعات ساختگی به‌مراتب کمتر است؛ هرچند صفر نیست.
    • تمرکز بر مجموعه‌ی شما: به‌جای جست‌وجو در کل اینترنت، روی همان مقالاتی کار می‌کند که شما انتخاب کرده‌اید.

    این رویکرد که در اصطلاح فنی به آن «تولید تقویت‌شده با بازیابی» یا RAG گفته می‌شود، دقیقاً همان چیزی است که پژوهشگر برای کار با ادبیات نیاز دارد. شما منابع را انتخاب و ارزیابی می‌کنید و ابزار به شما کمک می‌کند آن‌ها را سریع‌تر و عمیق‌تر بفهمید.

    NotebookLM جایگزین خواندن مقاله نیست؛ ابزاری است برای اینکه مقالاتی را که انتخاب کرده‌اید، هدفمندتر بخوانید و سریع‌تر سنتز کنید.

    یک تفاوت مهم دیگر این است که NotebookLM برای یافتن مقالات طراحی نشده است. هرچند قابلیت‌هایی برای کشف منابع از وب اضافه شده، کار اصلی آن کار با منابعی است که شما آورده‌اید. برای یافتن مقالات، باید از Google Scholar، Scopus یا ابزارهای تخصصی مثل Elicit و Consensus استفاده کنید که در مقاله‌ی مقایسه Elicit و Consensus و SciSpace معرفی کرده‌ایم.

    یک مقایسه‌ی ساده‌ی ذهنی کمک می‌کند جایگاه NotebookLM را بهتر بفهمید. چت‌بات عمومی مانند یک همکار باهوش است که مطالب زیادی خوانده اما گاهی منبع حرف‌هایش را به یاد نمی‌آورد یا اشتباه به یاد می‌آورد. NotebookLM مانند دستیاری است که فقط کتاب‌ها و مقالاتی را که شما روی میزش گذاشته‌اید خوانده و هر بار که چیزی می‌گوید، صفحه‌ی مربوط را نشانتان می‌دهد. برای کار پژوهشی که در آن «از کجا می‌دانی؟» مهم‌ترین سؤال است، دستیار دوم ارزش بیشتری دارد.

    قابلیت‌های کلیدی NotebookLM برای پژوهشگران

    NotebookLM مجموعه‌ای از قابلیت‌ها دارد که هر کدام در مرحله‌ای از پژوهش مفیدند:

    1. انواع منابع: امکان بارگذاری PDF، فایل‌های متنی، Google Docs و Slides، صفحات وب (با وارد کردن لینک)، ویدیوهای یوتیوب (از طریق متن آن‌ها)، فایل‌های صوتی و متن کپی‌شده.
    2. گفت‌وگو با منابع: پرسیدن سؤال آزاد و دریافت پاسخ با ارجاع درون‌متنی. می‌توانید انتخاب کنید پاسخ از همه‌ی منابع باشد یا فقط از منابع منتخب.
    3. یادداشت‌ها: ذخیره‌ی پاسخ‌های مفید به‌عنوان یادداشت و نوشتن یادداشت‌های شخصی در کنار منابع.
    4. خلاصه‌ی خودکار منابع: هنگام افزودن هر منبع، یک خلاصه و موضوعات کلیدی آن نمایش داده می‌شود.
    5. خروجی‌های ساختاریافته: تولید راهنمای مطالعه، سند جمع‌بندی (Briefing Doc)، پرسش‌های متداول، جدول زمانی و گزارش‌های مشابه از منابع.
    6. نقشه‌ی ذهنی (Mind Map): نمایش بصری مفاهیم اصلی منابع و ارتباط آن‌ها.
    7. مرور صوتی (Audio Overview): تولید یک گفت‌وگوی صوتی شبیه پادکست درباره‌ی منابع، که برای مرور سریع در زمان رفت‌وآمد مفید است.
    8. پشتیبانی چندزبانه: امکان دریافت پاسخ و خروجی به زبان‌های مختلف، از جمله فارسی، از طریق تنظیمات زبان خروجی.

    برای پژوهشگران، ارزشمندترین قابلیت‌ها معمولاً گفت‌وگو با ارجاع درون‌متنی، یادداشت‌ها و خروجی‌های ساختاریافته هستند. مرور صوتی و نقشه‌ی ذهنی برای آشنایی اولیه با یک حوزه‌ی جدید مفیدند، اما برای نوشتن پیشینه، کار اصلی با گفت‌وگو و یادداشت‌ها انجام می‌شود.

    از تنظیمات نوت‌بوک می‌توانید برای گفت‌وگو یک «نقش» یا دستورالعمل کلی تعریف کنید؛ مثلاً: «تو دستیار پژوهشی من در مرور ادبیات هستی. پاسخ‌ها را به فارسی بده، اصطلاحات تخصصی را به انگلیسی در پرانتز بیاور و همیشه به محدودیت‌های هر مطالعه اشاره کن.» این کار کیفیت پاسخ‌ها را به‌طور محسوسی بهتر می‌کند.

    یک کاربرد خلاقانه‌ی دیگر، ساختن نوت‌بوک برای راهنماهای روش‌شناختی است. مثلاً می‌توانید کتاب‌ها یا مقالات روش‌شناسی مرتبط با طرح پژوهش خود، راهنمای سبک APA یا آیین‌نامه‌ی نگارش پایان‌نامه‌ی دانشگاهتان را در یک نوت‌بوک بارگذاری کنید و هر جا در اجرای روش یا قالب‌بندی تردید داشتید، از همان منابع معتبر بپرسید. به همین شکل، می‌توانید سیاست‌های هوش مصنوعی ناشرانی مثل Elsevier و Nature را در یک نوت‌بوک جمع کنید تا پیش از ارسال مقاله، الزامات را سریع بررسی کنید.

    محدودیت‌ها، دقت و حریم خصوصی

    هیچ ابزاری بی‌نقص نیست و NotebookLM هم محدودیت‌هایی دارد که باید بشناسید:

    • محدودیت تعداد و حجم منابع: هر نوت‌بوک تعداد مشخصی منبع را می‌پذیرد و هر منبع هم محدودیت حجم دارد. نسخه‌ی رایگان محدودیت‌های بیشتری نسبت به نسخه‌های پولی دارد. اگر صدها مقاله دارید، باید آن‌ها را در چند نوت‌بوک موضوعی تقسیم کنید.
    • کیفیت PDF: مقالات اسکن‌شده یا PDFهایی که متن قابل‌انتخاب ندارند، ممکن است به‌درستی خوانده نشوند. جدول‌ها و فرمول‌های پیچیده هم گاهی ناقص استخراج می‌شوند.
    • خطای تفسیر: ابزار ممکن است یافته‌ای را از زمینه‌اش جدا کند، مثلاً یافته‌ی یک زیرگروه را به کل نمونه تعمیم دهد، یا میان «فرضیه» و «یافته» در یک مقاله تمایز نگذارد.
    • محدود به منابع شما: اگر منابع شما ناقص یا جانب‌دارانه باشند، پاسخ‌ها هم همین‌طور خواهند بود. ابزار نمی‌تواند به شما بگوید چه مطالعه‌ی مهمی را از قلم انداخته‌اید.
    • متون فارسی: پشتیبانی از PDFهای فارسی بهتر شده، اما گاهی در استخراج متن از PDFهای فارسی با فونت‌های قدیمی یا ساختار نامنظم مشکل دیده می‌شود.

    درباره‌ی حریم خصوصی، گوگل اعلام کرده است که منابع، پرسش‌ها و پاسخ‌های کاربران در NotebookLM برای آموزش مدل‌ها استفاده نمی‌شود، هرچند ممکن است در صورت ارسال بازخورد، بخش‌هایی توسط بازبینان انسانی دیده شود. با این حال، اصول کلی محرمانگی پژوهش را رعایت کنید:

    داده‌های خام شرکت‌کنندگان، متن کامل مصاحبه‌های بی‌نام‌نشده یا مقالات تحت داوری دیگران را در NotebookLM یا هر ابزار عمومی دیگری بارگذاری نکنید. برای مقالات منتشرشده‌ی دیگران هم به شرایط حق نشر و مجوز استفاده توجه داشته باشید.

    برای اطلاع از آخرین قابلیت‌ها، محدودیت‌های تعداد منابع و سیاست‌های حریم خصوصی، مرکز راهنمای رسمی NotebookLM منبع معتبری است. پیش از اینکه منابع مهم پژوهش خود را بارگذاری کنید، این صفحه را مرور کنید. همچنین اگر از حساب دانشگاهی یا سازمانی گوگل استفاده می‌کنید، ممکن است مدیر سازمان سیاست‌های متفاوتی برای استفاده از این ابزار تعیین کرده باشد. یک نکته‌ی امنیتی دیگر: اگر نوت‌بوک را با همکاران به اشتراک می‌گذارید، سطح دسترسی (مشاهده یا ویرایش) را با دقت تعیین کنید.

    در مجموع، اگر بخواهیم جایگاه NotebookLM را در یک جمله خلاصه کنیم: این ابزار برای مرحله‌ی «فهم و سنتز منابعی که انتخاب کرده‌اید» بهترین است، برای «یافتن منابع» ابزار اصلی نیست و برای «نوشتن متن نهایی» نباید جایگزین شما شود. با همین تقسیم کار در ذهن، وارد آموزش عملی می‌شویم و می‌بینیم چگونه می‌توان از هر قابلیت آن بیشترین بهره را برد.

    آموزش گام‌به‌گام کار با NotebookLM

    حالا وارد آموزش عملی می‌شویم. در این بخش، سه مرحله‌ی اصلی کار با NotebookLM را مرور می‌کنیم: ساختن نوت‌بوک و افزودن منابع، پرسیدن سؤال و کار با ارجاعات و یادداشت‌ها، و تولید خروجی‌های مختلف. برای هر مرحله، نکات عملی و اشتباهات رایج را هم توضیح می‌دهیم.

    آموزش گام‌به‌گام NotebookLM برای پژوهش
    آموزش گام‌به‌گام NotebookLM برای پژوهش

    پیش از شروع، یک پوشه‌ی منظم از PDFهای منتخب روی رایانه یا Google Drive آماده کنید. اگر مقالات را هنوز غربال نکرده‌اید، ابتدا این کار را انجام دهید؛ بارگذاری ده‌ها مقاله‌ی نامرتبط، کیفیت پاسخ‌ها را پایین می‌آورد و وقت شما را هدر می‌دهد. همچنین سؤال یا هدف اصلی نوت‌بوک را در یک جمله یادداشت کنید تا در طول کار، تمرکز خود را حفظ کنید.

    گام اول: ساختن نوت‌بوک و افزودن منابع

    برای شروع، به سایت NotebookLM بروید و با حساب گوگل خود وارد شوید. سپس:

    1. روی گزینه‌ی ساختن نوت‌بوک جدید کلیک کنید.
    2. یک نام توصیفی انتخاب کنید؛ مثلاً «پیشینه-فصل۲-فرسودگی شغلی» به‌جای «نوت‌بوک ۱».
    3. منابع را اضافه کنید: PDF مقالات را از رایانه بارگذاری کنید، یا از Google Drive انتخاب کنید، یا لینک صفحات وب را وارد کنید.
    4. پس از پردازش، روی هر منبع کلیک کنید تا خلاصه‌ی خودکار و موضوعات کلیدی آن را ببینید.

    نکات مهم در انتخاب و سازمان‌دهی منابع:

    • یک نوت‌بوک برای هر سؤال یا فصل: به‌جای ریختن همه‌ی مقالات در یک نوت‌بوک، برای هر سؤال پژوهشی، هر متغیر اصلی یا هر فصل، نوت‌بوک جداگانه بسازید. پاسخ‌ها متمرکزتر و دقیق‌تر می‌شوند.
    • کیفیت فایل: از نسخه‌ی اصلی PDF ناشر استفاده کنید، نه اسکن‌های کم‌کیفیت. اگر PDF متن قابل‌انتخاب ندارد، ابتدا با ابزارهای OCR آن را قابل‌خواندن کنید.
    • نام‌گذاری فایل‌ها: پیش از بارگذاری، فایل‌ها را با الگوی «نام‌خانوادگی نویسنده‌ی اول-سال-کلیدواژه» نام‌گذاری کنید. این کار تشخیص منبع در ارجاعات را بسیار آسان‌تر می‌کند.
    • منابع منتخب، نه همه‌چیز: فقط مقالاتی را اضافه کنید که پس از غربالگری اولیه (بر اساس عنوان و چکیده) مرتبط تشخیص داده‌اید.

    اگر از Zotero برای مدیریت منابع استفاده می‌کنید، می‌توانید PDFهای یک مجموعه را مستقیماً از پوشه‌ی Zotero بارگذاری کنید. این ترکیب، جریان کاری بسیار کارآمدی ایجاد می‌کند: Zotero برای مدیریت و ارجاع‌دهی، NotebookLM برای فهم و سنتز.

    نکته‌ی مربوط به منابع فارسی: اگر منابع فارسی دارید، پیش از بارگذاری، یک صفحه از PDF را باز کنید و ببینید آیا متن آن قابل‌انتخاب و کپی است. اگر حروف به‌هم‌ریخته یا جدا از هم کپی می‌شوند، احتمالاً NotebookLM هم در خواندن آن مشکل خواهد داشت. در این حالت، می‌توانید نسخه‌ی Word مقاله را (اگر در دسترس است) تبدیل کنید یا متن بخش‌های کلیدی را مستقیماً به‌صورت متن کپی‌شده اضافه کنید. همچنین برای هر منبع، پس از بارگذاری، خلاصه‌ی خودکار را بخوانید؛ اگر خلاصه بی‌معنا بود، یعنی متن درست استخراج نشده است.

    ترکیب منابع مختلف: علاوه بر مقالات، می‌توانید یادداشت‌های جلسات با استاد راهنما، پروپوزال مصوب خود و فرم پروپوزال را هم به نوت‌بوک اضافه کنید. این کار به ابزار کمک می‌کند پاسخ‌ها را با چارچوب پژوهش شما مرتبط کند. مثلاً می‌توانید بپرسید: «با توجه به سؤالات پژوهش در پروپوزال من، کدام مقالات این نوت‌بوک بیشترین ارتباط را دارند؟»

    گام دوم: پرسیدن سؤال، کار با ارجاعات و یادداشت‌برداری

    پس از افزودن منابع، می‌توانید در پنل گفت‌وگو سؤال بپرسید. کیفیت پاسخ‌ها مستقیماً به کیفیت سؤال‌ها بستگی دارد. چند نوع سؤال مفید برای پژوهشگران:

    • سؤالات توصیفی: «هر یک از این مطالعات از چه روشی استفاده کرده و حجم نمونه چقدر بوده است؟»
    • سؤالات مقایسه‌ای: «یافته‌های این مطالعات درباره‌ی رابطه‌ی X و Y چه شباهت‌ها و تفاوت‌هایی دارند؟»
    • سؤالات تبیینی: «مطالعاتی که رابطه‌ی معنادار نیافته‌اند، چه تبیینی برای نتیجه‌ی خود ارائه داده‌اند؟»
    • سؤالات انتقادی: «محدودیت‌هایی که نویسندگان این مطالعات خودشان ذکر کرده‌اند چیست؟»
    • سؤالات شکاف‌یاب: «بر اساس پیشنهادهای پژوهش آینده در این مقالات، چه پرسش‌هایی هنوز بی‌پاسخ مانده است؟»

    کار با ارجاعات: هر پاسخ شامل شماره‌های ارجاع است. روی هر شماره کلیک کنید تا متن دقیق منبع را ببینید. این کار را همیشه برای ادعاهای مهم انجام دهید. هدف این است که مطمئن شوید ابزار منبع را درست فهمیده و از زمینه خارج نکرده است. این بررسی، تفاوت میان استفاده‌ی مسئولانه و استفاده‌ی سطحی است.

    یادداشت‌برداری: پاسخ‌های مفید را به‌عنوان یادداشت ذخیره کنید. همچنین یادداشت‌های شخصی خود را بنویسید: نقدهای شما بر هر مطالعه، ارتباطاتی که میان مطالعات می‌بینید و ایده‌هایی برای پیشینه. این یادداشت‌ها بعداً ماده‌ی خام نوشتن پیشینه خواهند بود.

    برای ادعاهای کلیدی که قصد دارید در پیشینه بیاورید، پس از دیدن ارجاع در NotebookLM، به PDF اصلی بروید و آن بخش را در متن کامل بخوانید. گاهی جمله‌ی قبل یا بعد، معنای یافته را تغییر می‌دهد.

    اشتباه رایج در پرسیدن سؤال: بسیاری از کاربران سؤال‌های خیلی کلی می‌پرسند، مثل «این مقالات درباره‌ی چه هستند؟» پاسخ چنین سؤالی معمولاً کلی و کم‌فایده است. سؤال‌های دقیق‌تر، با ذکر متغیر، روش یا جنبه‌ی مشخص، پاسخ‌های عمیق‌تری می‌گیرند. همچنین اگر پاسخ را نپسندیدید، سؤال را بازنویسی کنید یا از ابزار بخواهید پاسخ را در قالب دیگری مثل جدول یا فهرست ارائه دهد. گاهی هم مفید است منابع را محدود کنید؛ مثلاً فقط سه مقاله‌ی کلیدی را انتخاب کنید و سؤال مقایسه‌ای بپرسید تا پاسخ متمرکزتر شود.

    گام سوم: تولید خروجی‌ها؛ راهنمای مطالعه، نقشه‌ی ذهنی و مرور صوتی

    NotebookLM می‌تواند از منابع شما خروجی‌های ساختاریافته تولید کند. کاربرد هر کدام در پژوهش:

    • سند جمع‌بندی (Briefing Doc): خلاصه‌ای از موضوعات اصلی، یافته‌های کلیدی و نقل‌قول‌های مهم منابع. برای شروع نوشتن یک بخش از پیشینه، نقطه‌ی شروع خوبی است.
    • راهنمای مطالعه (Study Guide): شامل پرسش‌های کوتاه، پاسخ‌ها و واژه‌نامه‌ی اصطلاحات کلیدی. برای آمادگی آزمون جامع دکتری یا جلسه‌ی دفاع بسیار مفید است.
    • پرسش‌های متداول (FAQ): فهرستی از پرسش‌های اصلی که منابع به آن‌ها پاسخ می‌دهند.
    • جدول زمانی (Timeline): برای حوزه‌هایی که سیر تاریخی تحول یک مفهوم یا نظریه اهمیت دارد.
    • نقشه‌ی ذهنی: نمایش بصری مفاهیم و ارتباطات؛ برای طراحی ساختار فصل پیشینه یا مدل مفهومی مفید است.
    • مرور صوتی: یک گفت‌وگوی صوتی درباره‌ی منابع؛ برای آشنایی اولیه یا مرور در زمان‌های مرده.

    یک هشدار مهم درباره‌ی این خروجی‌ها: آن‌ها خلاصه هستند، نه سنتز انتقادی. ابزار می‌گوید منابع چه گفته‌اند، اما نمی‌تواند به‌خوبی شما قضاوت کند کدام مطالعه معتبرتر است، کدام روش ضعف دارد یا شکاف واقعی کجاست. از این خروجی‌ها برای سازمان‌دهی استفاده کنید، اما متن پیشینه را خودتان بنویسید.

    مرور صوتی را با احتیاط استفاده کنید: گفت‌وگوهای صوتی گاهی برای جذاب‌تر شدن، یافته‌ها را ساده‌سازی یا اغراق می‌کنند. آن‌ها را منبع نقل‌قول یا یادداشت دقیق قرار ندهید.

    کاربرد خروجی‌ها در آمادگی دفاع و آزمون جامع: دانشجویان دکتری می‌توانند برای هر حوزه‌ی آزمون جامع یک نوت‌بوک بسازند و از راهنمای مطالعه و پرسش‌های متداول برای مرور استفاده کنند. برای آمادگی دفاع هم می‌توانید پایان‌نامه‌ی خود را به‌همراه مقالات کلیدی در یک نوت‌بوک قرار دهید و بخواهید سؤالات احتمالی داوران را بر اساس محدودیت‌های پژوهش و مقایسه با مطالعات دیگر استخراج کند. البته پاسخ‌دادن به این سؤالات را خودتان و بدون کمک ابزار تمرین کنید تا در جلسه‌ی واقعی آماده باشید.

    مطالعهٔ تکمیلی: اگر می‌خواهید این موضوع را عمیق‌تر و بر پایهٔ یک منبع معتبر دانشگاهی دنبال کنید، راهنماهای هوش مصنوعی در پژوهش دانشگاهی، آموزش هوش مصنوعی برای دانشجویان و ساخت پاورپوینت با هوش مصنوعی را هم در ریسرچ اینتل بخوانید.

    مرور ادبیات با NotebookLM: جریان کاری کامل

    اکنون همه‌ی آنچه یاد گرفتیم را در یک جریان کاری کامل برای مرور ادبیات کنار هم می‌گذاریم. این بخش شامل مراحل عملی ساختن ماتریس پیشینه، پرامپت‌های آماده برای هر مرحله‌ی مرور و نکاتی برای مرورهای نظام‌مند، ترکیب با ابزارهای دیگر و رعایت اخلاق پژوهش است.

    مرور ادبیات و ساخت ماتریس پیشینه با NotebookLM برای پژوهش
    مرور ادبیات و ساخت ماتریس پیشینه با NotebookLM برای پژوهش

    جریان کاری مرور ادبیات و ساخت ماتریس پیشینه

    یک جریان کاری پیشنهادی هشت‌مرحله‌ای:

    1. تعریف سؤال مرور: دقیقاً مشخص کنید پیشینه قرار است به چه سؤالی پاسخ دهد.
    2. جست‌وجو و غربالگری: در Google Scholar، Scopus و پایگاه‌های داخلی جست‌وجو کنید و بر اساس عنوان و چکیده غربال کنید.
    3. ساخت نوت‌بوک: مقالات منتخب را در یک یا چند نوت‌بوک موضوعی بارگذاری کنید.
    4. آشنایی اولیه: سند جمع‌بندی و نقشه‌ی ذهنی بگیرید تا تصویر کلی حوزه را ببینید.
    5. استخراج اطلاعات: با پرامپت‌های ساختاریافته، اطلاعات هر مطالعه را استخراج کنید.
    6. ساخت ماتریس: اطلاعات استخراج‌شده را در یک جدول (در Excel یا Google Sheets) سازمان‌دهی و هر خانه را با منبع اصلی بررسی کنید.
    7. سنتز: با سؤالات مقایسه‌ای و تبیینی، الگوها، تناقض‌ها و شکاف‌ها را شناسایی کنید.
    8. نگارش: بر اساس ماتریس و یادداشت‌ها، پیشینه را خودتان بنویسید.

    ماتریس پیشینه معمولاً این ستون‌ها را دارد: نویسنده و سال، کشور یا زمینه، هدف، طرح پژوهش، نمونه، ابزار، یافته‌های اصلی، محدودیت‌ها و ارتباط با پژوهش شما. NotebookLM می‌تواند پیش‌نویس این جدول را تولید کند، اما هر خانه را باید با منبع اصلی تطبیق دهید، به‌ویژه اعداد مثل حجم نمونه و ضرایب.

    برای اصول کلی مرور ادبیات، صفحه‌ی مرور ادبیات ریسرچ اینتل را ببینید. اگر این مرور برای پایان‌نامه است، راهنمای نوشتن پایان‌نامه با هوش مصنوعی نشان می‌دهد این ماتریس چگونه به فصل دوم تبدیل می‌شود.

    مدیریت چند نوت‌بوک: در پروژه‌های بزرگ مثل رساله‌ی دکتری، ممکن است ده‌ها نوت‌بوک داشته باشید. برای نظم بیشتر، یک قاعده‌ی نام‌گذاری ثابت داشته باشید و یک فایل فهرست (مثلاً در Google Docs) بسازید که مشخص کند هر نوت‌بوک شامل چه منابعی است و برای کدام بخش پژوهش ساخته شده است. همچنین یادداشت‌های مهم هر نوت‌بوک را به‌طور دوره‌ای در فایل‌های خارج از ابزار کپی کنید تا در صورت تغییر سرویس یا مشکل دسترسی، کار شما از دست نرود.

    ارتباط با نگارش پروپوزال و پایان‌نامه: ماتریسی که در این مرحله می‌سازید، فقط برای فصل دوم نیست. همین ماتریس مبنای نوشتن بیان مسئله (بخش شکاف)، تعریف متغیرها در فصل اول، انتخاب ابزار سنجش در فصل سوم و مقایسه‌ی یافته‌ها در فصل پنجم است. بنابراین از ابتدا ستون‌های ماتریس را با این کاربردها در ذهن طراحی کنید؛ مثلاً ستونی برای «ابزار سنجش و پایایی گزارش‌شده» اضافه کنید که بعدها در فصل سوم و پنجم به کارتان می‌آید. برای خدمات و راهنمایی بیشتر در نگارش، صفحه‌ی نگارش پایان‌نامه را ببینید.

    پرامپت‌های کاربردی برای مرور ادبیات

    این پرامپت‌ها را می‌توانید مستقیماً در NotebookLM استفاده کنید و بر اساس پژوهش خود تنظیم کنید:

    • استخراج ساختاریافته: «برای هر منبع، این اطلاعات را در قالب جدول استخراج کن: نویسنده و سال، کشور، طرح پژوهش، حجم نمونه، ابزار سنجش متغیر اصلی، یافته‌ی اصلی، محدودیت ذکرشده. اگر اطلاعاتی در منبع نیست، بنویس “ذکر نشده”.»
    • دسته‌بندی: «این مطالعات را بر اساس روش (کمی، کیفی، ترکیبی) و بر اساس جهت یافته (رابطه‌ی مثبت، منفی، بی‌معنا) دسته‌بندی کن.»
    • یافتن تناقض: «کدام مطالعات یافته‌های متناقض درباره‌ی رابطه‌ی X و Y گزارش کرده‌اند؟ تفاوت‌های روش‌شناختی آن‌ها چیست؟»
    • تعاریف: «هر مطالعه متغیر X را چگونه تعریف و سنجیده است؟ آیا تعاریف یکسان‌اند؟»
    • چارچوب نظری: «کدام نظریه‌ها در این مطالعات به‌عنوان چارچوب نظری استفاده شده‌اند و هر کدام چند بار؟»
    • شکاف: «بر اساس بخش محدودیت‌ها و پیشنهادهای پژوهش آینده، پنج شکاف پژوهشی اصلی را با ارجاع به منابع فهرست کن.»
    • بررسی پیش‌نویس: «این پاراگراف را که برای پیشینه نوشته‌ام بخوان. آیا ادعاهای آن با منابع این نوت‌بوک سازگار است؟ کجا منبع را نادرست نقل کرده‌ام؟»

    پرامپت آخر یکی از ارزشمندترین کاربردهای NotebookLM است: به‌جای اینکه ابزار برای شما بنویسد، متن شما را با منابع می‌سنجد. پرامپت‌های بیشتر را در بانک پرامپت‌های پژوهشی ریسرچ اینتل پیدا می‌کنید.

    یک مثال عملی: فرض کنید پایان‌نامه‌ی شما درباره‌ی «نقش رهبری خدمتگزار در تعهد سازمانی کارکنان» است. بیست‌وپنج مقاله‌ی کلیدی را پیدا کرده‌اید. ابتدا با پرامپت استخراج ساختاریافته، جدولی از همه‌ی مطالعات می‌گیرید. سپس می‌پرسید «کدام مطالعات متغیر میانجی بررسی کرده‌اند و کدام متغیرها؟» و متوجه می‌شوید که اعتماد سازمانی در چند مطالعه میانجی بوده اما هیچ مطالعه‌ای نقش تعدیل‌گر فرهنگ سازمانی را بررسی نکرده است. این یک شکاف بالقوه است. پیش از اینکه آن را در پروپوزال بنویسید، با جست‌وجوی تکمیلی در پایگاه‌ها مطمئن می‌شوید که واقعاً مطالعه‌ای در این زمینه وجود ندارد. این همان نقطه‌ای است که ابزار و قضاوت پژوهشگر با هم کار می‌کنند.

    مرور نظام‌مند، ترکیب با ابزارهای دیگر و اخلاق پژوهش

    مرور نظام‌مند: اگر مرور نظام‌مند یا متاآنالیز انجام می‌دهید، باید از استانداردهایی مثل PRISMA پیروی کنید. در این نوع مرور، جست‌وجو، غربالگری و استخراج داده باید شفاف، قابل‌تکرار و معمولاً توسط دو داور مستقل انجام شود. NotebookLM می‌تواند در مرحله‌ی استخراج داده کمک کند، اما:

    • جایگزین غربالگری دوگانه‌ی انسانی نیست.
    • استخراج‌ها باید توسط داوران انسانی تأیید شوند.
    • استفاده از ابزار باید در بخش روش با جزئیات گزارش شود.

    ترکیب با ابزارهای دیگر: NotebookLM در یک جریان کاری ترکیبی بهترین عملکرد را دارد:

    • یافتن مقالات: Google Scholar، Scopus، Elicit، Consensus
    • کشف مقالات مرتبط: ResearchRabbit یا Connected Papers
    • مدیریت منابع و ارجاع‌دهی: Zotero یا Mendeley
    • فهم و سنتز: NotebookLM
    • ویرایش متن نهایی: یک دستیار عمومی مثل ChatGPT یا Claude

    برای مقایسه‌ی کامل این ابزارها، مقاله‌ی بهترین هوش مصنوعی برای پژوهش را بخوانید.

    اخلاق پژوهش: استفاده از NotebookLM برای فهم و سازمان‌دهی منابع، کاملاً با اخلاق پژوهش سازگار است. اما چند اصل را رعایت کنید:

    • متن پیشینه را خودتان بنویسید؛ کپی خلاصه‌های ابزار در متن پایان‌نامه یا مقاله، ممکن است در سامانه‌های همانندجو یا آشکارسازهای متن ماشینی مشکل ایجاد کند و از نظر اخلاقی هم پذیرفتنی نیست.
    • همیشه به منابع اصلی ارجاع دهید، نه به NotebookLM.
    • اگر مجله یا دانشگاه بخواهد، استفاده از ابزار را اعلام کنید. نحوه‌ی اعلام را در استفاده از ChatGPT در مقاله شرح داده‌ایم.

    یک توصیه درباره‌ی اعتبار و ارجاع‌دهی: وقتی متن پیشینه را می‌نویسید، ارجاعات را با نرم‌افزار مدیریت منابع و مطابق سبک موردنیاز (مثلاً APA) درج کنید، نه بر اساس شماره‌های ارجاع NotebookLM. شماره‌های ارجاع ابزار فقط برای ردیابی داخلی شما هستند. همچنین اصول اخلاق نشر، از جمله آنچه COPE درباره‌ی مسئولیت نویسندگان در قبال محتوای تولیدشده با کمک هوش مصنوعی گفته است، در اینجا هم صادق است: مسئولیت درستی هر ادعایی که در پیشینه می‌آورید، با شماست. اگر قصد دارید پیشینه را به مقاله تبدیل کنید، راهنمای مقاله‌نویسی علمی با هوش مصنوعی را هم ببینید.

    NotebookLM برای خواندن هدفمند طراحی شده، نه برای نخواندن. پژوهشگری که مقالات را نخوانده و فقط به خلاصه‌های ابزار تکیه کرده، در جلسه‌ی دفاع یا پاسخ به داوران با اولین سؤال عمیق دچار مشکل می‌شود.

    ملاحظه‌ی دسترسی: NotebookLM ابزار گوگل است و دسترسی به آن برای کاربران ایرانی ممکن است با محدودیت‌هایی همراه باشد. اگر قصد دارید کل جریان کاری مرور ادبیات را بر آن بنا کنید، از پایداری دسترسی خود مطمئن شوید و همیشه نسخه‌ی پشتیبان یادداشت‌ها و ماتریس را خارج از ابزار نگه دارید. صفحه‌ی خرید اکانت هوش مصنوعی اطلاعاتی درباره‌ی گزینه‌های دسترسی به ابزارهای هوش مصنوعی ارائه می‌دهد. برای آشنایی با جایگاه کلی این ابزارها در پژوهش هم صفحه‌ی هوش مصنوعی در پژوهش را ببینید. اگر هنوز در مرحله‌ی تعریف موضوع هستید، راهنمای نوشتن پروپوزال با هوش مصنوعی نشان می‌دهد چطور از همین نوت‌بوک‌ها برای نوشتن پیشینه‌ی پروپوزال استفاده کنید.

    جمع‌بندی: NotebookLM برای پژوهش یکی از بهترین ابزارهای رایگان برای کار با ادبیات است، چون پاسخ‌ها را به منابع خودتان محدود می‌کند و برای هر ادعا ارجاع دقیق می‌دهد. با ساختن نوت‌بوک‌های موضوعی، پرسیدن سؤالات ساختاریافته، بررسی همیشگی ارجاعات، ساختن ماتریس پیشینه و نوشتن متن نهایی توسط خودتان، می‌توانید زمان مرور ادبیات را کاهش و کیفیت آن را افزایش دهید. برای یادگیری عملی این جریان کاری در کنار مربی، دوره مقاله‌نویسی با هوش مصنوعی و برنامه‌های هفته پژوهش را دنبال کنید و اگر در طراحی مرور ادبیات به راهنمایی نیاز دارید، مشاوره پژوهشی ریسرچ اینتل در کنار شماست.

    برای آموزش‌ها و مشاوره‌های بیشتر پژوهشی به هوش پژوهشی سر بزنید.
  • استفاده از ChatGPT در مقاله علمی و نحوه‌ی اعلام آن

    استفاده از ChatGPT در مقاله علمی و نحوه‌ی اعلام آن

    استفاده از ChatGPT در مقاله علمی یکی از داغ‌ترین بحث‌های جامعه‌ی پژوهشی در چند سال اخیر بوده است. از زمانی که دستیارهای گفت‌وگومحور در دسترس همگان قرار گرفتند، پژوهشگران در سراسر جهان از آن‌ها برای ویرایش متن، خلاصه‌سازی، ایده‌پردازی و حتی نوشتن بخش‌هایی از مقاله استفاده کرده‌اند. هم‌زمان، ناشران، مجلات و نهادهای اخلاق نشر هم با سرعت سیاست‌هایی تدوین کردند تا مشخص کنند چه استفاده‌ای مجاز است، چه استفاده‌ای ممنوع است و چگونه باید آن را اعلام کرد.

    برای یک دانشجوی ارشد یا دکتری که می‌خواهد اولین مقاله‌ی خود را بنویسد، این وضعیت می‌تواند گیج‌کننده باشد. آیا اصلاً مجاز است از ChatGPT استفاده کنم؟ اگر فقط برای ویرایش گرامر استفاده کرده‌ام، باید اعلام کنم؟ کجای مقاله باید اعلام کنم؟ چه بنویسم که مقاله‌ام رد نشود؟ آیا اعلام استفاده باعث می‌شود داوران به کارم بدبین شوند؟

    در این راهنما به همه‌ی این سؤال‌ها پاسخ می‌دهیم. ابتدا چارچوب اخلاقی و سیاست‌های نهادهای بین‌المللی و ناشران بزرگ را مرور می‌کنیم. سپس کاربردهای مسئولانه‌ی ChatGPT را در هر مرحله‌ی نگارش مقاله بررسی می‌کنیم. در نهایت، با نمونه‌متن‌های آماده نشان می‌دهیم کجا و چگونه استفاده را اعلام کنید و چه ریسک‌هایی را باید در نظر بگیرید. هدف ما این است که شما با اطمینان و شفافیت از این ابزارها بهره ببرید، نه با ترس و پنهان‌کاری.

    در این مقاله، منظور از «ChatGPT» همه‌ی ابزارهای هوش مصنوعی مولد مشابه مانند Claude، Gemini، Grok و دیگران است. سیاست‌های ناشران معمولاً به «هوش مصنوعی مولد» به‌طور کلی اشاره دارند، نه به یک محصول خاص.

    پیش از ورود به جزئیات، بد نیست بدانیم چرا این بحث تا این اندازه اهمیت پیدا کرده است. نظام نشر علمی بر یک اعتماد بنیادین استوار است: خوانندگان، داوران و ویراستاران فرض می‌کنند که آنچه در مقاله آمده، حاصل کار فکری نویسندگان نام‌برده است و آن‌ها پاسخ‌گوی صحت آن هستند. ورود ابزارهایی که می‌توانند در چند ثانیه متنی روان و به‌ظاهر علمی تولید کنند، این اعتماد را در معرض خطر قرار داده است. سیاست‌های ناشران در واقع تلاشی برای حفظ همین اعتماد است، نه مخالفت با فناوری. وقتی این منطق را بفهمید، رعایت قواعد هم برایتان طبیعی‌تر می‌شود.

    چارچوب اخلاقی: آیا استفاده از ChatGPT در مقاله مجاز است؟

    پاسخ کوتاه این است: بله، در بیشتر مجلات، به شرط شفافیت و پذیرش مسئولیت. اما جزئیات اهمیت زیادی دارد. در این بخش، موضع نهادهای اصلی اخلاق نشر، سیاست ناشران بزرگ و طیف استفاده‌های مجاز و غیرمجاز را بررسی می‌کنیم تا تصویر روشنی از قواعد بازی داشته باشید.

    سیاست‌های ناشران درباره استفاده از ChatGPT در مقاله
    سیاست‌های ناشران درباره استفاده از ChatGPT در مقاله

    یک تصور نادرست رایج این است که ناشران با استفاده از هوش مصنوعی مخالف‌اند. در واقع، بسیاری از ناشران بزرگ خودشان ابزارهای هوش مصنوعی را در فرایندهای داخلی، مثل بررسی اولیه‌ی شباهت، پیشنهاد داور یا بررسی کیفیت زبانی، به کار می‌گیرند. آنچه آن‌ها می‌خواهند، نه ممنوعیت کامل، بلکه استفاده‌ی شفاف و مسئولانه است. نویسنده‌ای که این اصل را درک کند، می‌تواند با خیال راحت از مزایای این ابزارها بهره ببرد.

    موضع COPE، ICMJE و WAME

    سه نهاد بین‌المللی که بیشترین تأثیر را بر سیاست‌های مجلات دارند، موضع نسبتاً هم‌سویی گرفته‌اند:

    کمیته‌ی اخلاق نشر (COPE): در بیانیه‌ی رسمی خود درباره‌ی نویسندگی و ابزارهای هوش مصنوعی اعلام کرده است که ابزارهای هوش مصنوعی نمی‌توانند در فهرست نویسندگان قرار گیرند، چون نمی‌توانند مسئولیت اثر را بپذیرند، تعارض منافع را اعلام کنند یا حقوق نشر را مدیریت کنند. نویسندگانی که از این ابزارها استفاده می‌کنند، باید نحوه‌ی استفاده را در بخش روش یا بخش مشابه به‌طور شفاف اعلام کنند و مسئولیت کامل محتوا، از جمله بخش‌های تولیدشده توسط ابزار، با آن‌هاست.

    کمیته‌ی بین‌المللی ویراستاران مجلات پزشکی (ICMJE): در توصیه‌نامه‌ی خود از نویسندگان می‌خواهد که در زمان ارسال، استفاده از فناوری‌های هوش مصنوعی را در نامه‌ی همراه و در متن مقاله اعلام کنند. اگر از ابزار برای کمک به نگارش استفاده شده، این باید در بخش تقدیر و تشکر ذکر شود و اگر برای گردآوری یا تحلیل داده یا تولید شکل‌ها استفاده شده، در بخش روش. ICMJE همچنین تأکید می‌کند که ابزارهای هوش مصنوعی نباید به‌عنوان نویسنده یا هم‌نویسنده ذکر شوند و نباید به‌عنوان منبع اولیه‌ی ادعاها ارجاع داده شوند.

    انجمن جهانی ویراستاران پزشکی (WAME): این انجمن هم توصیه‌هایی مشابه منتشر کرده و بر شفافیت، مسئولیت انسانی و ضرورت بررسی صحت خروجی‌ها تأکید دارد.

    جمع‌بندی موضع نهادها: هوش مصنوعی نویسنده نیست؛ استفاده باید اعلام شود؛ و مسئولیت هر کلمه‌ی مقاله با نویسندگان انسانی است.

    در کنار این نهادها، بسیاری از دانشگاه‌ها هم رهنمودهای داخلی منتشر کرده‌اند. در ایران، هرچند هنوز آیین‌نامه‌ی جامع و یکسانی در همه‌ی دانشگاه‌ها وجود ندارد، اصول کلی منشور اخلاق پژوهش و آیین‌نامه‌های مربوط به تخلفات پژوهشی، به‌طور ضمنی شامل سوءاستفاده از ابزارهای هوش مصنوعی هم می‌شود. برای مثال، ارائه‌ی متن تولیدشده توسط ابزار به‌عنوان کار خود، می‌تواند مصداق «انتساب نادرست» یا سرقت علمی باشد. بنابراین حتی اگر دانشگاه شما سیاست مستقلی ندارد، اصول شفافیت و مسئولیت را رعایت کنید.

    سیاست ناشران بزرگ

    ناشران بزرگ، هر کدام سیاست‌های خود را بر پایه‌ی همین اصول تدوین کرده‌اند، اما جزئیات متفاوت است. مرور کلی سیاست‌های رایج (که باید همیشه با نسخه‌ی به‌روز سایت ناشر تطبیق داده شود):

    • Elsevier: از نویسندگان می‌خواهد در صورت استفاده از هوش مصنوعی مولد در فرایند نگارش، یک بخش اختصاصی با عنوانی مانند «Declaration of generative AI and AI-assisted technologies in the writing process» پیش از فهرست منابع اضافه کنند. استفاده باید محدود به بهبود خوانایی و زبان باشد و تحت نظارت انسانی انجام شود. راهنمای نویسندگان Elsevier جزئیات را شرح داده است.
    • Springer Nature: مدل‌های زبانی نمی‌توانند نویسنده باشند و استفاده از آن‌ها باید در بخش روش (یا بخش مناسب دیگر) مستند شود. این ناشر اعلام کرده است که استفاده برای «ویرایش زبانی» (AI-assisted copy editing) نیاز به اعلام ندارد. همچنین استفاده از تصاویر تولیدشده با هوش مصنوعی را جز در موارد خاص مجاز نمی‌داند. سیاست Nature در این زمینه شناخته‌شده است.
    • Science (AAAS): سیاست سخت‌گیرانه‌تری دارد؛ استفاده باید در نامه‌ی همراه و بخش تقدیر اعلام شود، جزئیات ابزار و پرامپت‌ها ذکر شود و تصاویر تولیدشده بدون اجازه‌ی صریح ویراستار مجاز نیستند.
    • Taylor & Francis، Wiley، SAGE و دیگران: همگی سیاست‌هایی با محوریت عدم نویسندگی هوش مصنوعی، شفافیت و مسئولیت انسانی دارند.

    سیاست‌های ناشران به‌طور مرتب به‌روز می‌شوند و ممکن است میان مجلات یک ناشر هم تفاوت‌هایی وجود داشته باشد. پیش از ارسال، حتماً بخش «Guide for Authors» یا «Editorial Policies» مجله‌ی هدف را بخوانید و دنبال کلیدواژه‌هایی مثل «AI»، «generative» یا «LLM» بگردید.

    یک نکته‌ی ظریف در سیاست ناشران، تفاوت میان «ابزارهای کمکی سنتی» و «هوش مصنوعی مولد» است. بیشتر ناشران تصریح کرده‌اند که استفاده از ابزارهایی مثل غلط‌یاب املایی، ابزارهای پایه‌ی بررسی گرامر یا نرم‌افزارهای مدیریت منابع نیاز به اعلام ندارد. اما وقتی ابزار، متن جدید تولید می‌کند یا جملات را به‌طور اساسی بازنویسی می‌کند، وارد قلمرو هوش مصنوعی مولد می‌شوید و قواعد اعلام اعمال می‌شود. اگر مطمئن نیستید استفاده‌ی شما در کدام دسته قرار می‌گیرد، قاعده‌ی محتاطانه این است که اعلام کنید.

    طیف استفاده‌ی مجاز و غیرمجاز

    برای تصمیم‌گیری عملی، مفید است استفاده‌ها را روی یک طیف ببینیم:

    استفاده‌هایی که معمولاً مجاز و کم‌ریسک هستند (اغلب با اعلام):

    • اصلاح گرامر، املا و نشانه‌گذاری
    • روان‌سازی جملات و بهبود خوانایی
    • پیشنهاد مترادف و یکدست‌کردن اصطلاحات
    • خلاصه‌سازی متن خودتان برای چکیده یا Highlights (با بازبینی کامل)
    • بازخورد ساختاری بر پیش‌نویس

    استفاده‌هایی که در منطقه‌ی خاکستری هستند و نیاز به احتیاط و اعلام دقیق دارند:

    • تولید پیش‌نویس اولیه‌ی بخش‌هایی از مقاله بر اساس یادداشت‌های شما
    • پیشنهاد ساختار استدلال در مقدمه یا بحث
    • کمک در نوشتن کد تحلیل داده
    • ترجمه‌ی متن از فارسی به انگلیسی

    استفاده‌هایی که غیرمجاز یا تخلف محسوب می‌شوند:

    • تولید داده، نتایج یا تصاویر ساختگی
    • تولید منابع بدون بررسی یا ارجاع به منابعی که وجود ندارند
    • نوشتن کل مقاله توسط ابزار و ارسال به نام خود
    • استفاده از ابزارهای «انسانی‌سازی» برای پنهان کردن متن ماشینی
    • ذکر ابزار به‌عنوان نویسنده
    • عدم اعلام استفاده‌ی محتوایی در حالی که مجله اعلام را الزامی کرده است

    برای آشنایی بیشتر با اصول صداقت علمی، صفحه‌ی صداقت علمی ریسرچ اینتل را ببینید.

    یک معیار عملی برای تشخیص جایگاه استفاده‌ی خودتان روی این طیف، «آزمون جایگزینی» است: اگر بخشی از مقاله را که با کمک ابزار نوشته‌اید حذف کنید و از خودتان بخواهید آن را بدون ابزار دوباره بنویسید، آیا می‌توانید همان محتوا را، شاید با زبانی ساده‌تر، تولید کنید؟ اگر بله، ابزار احتمالاً در نقش ویراستار یا دستیار بوده است. اگر نه، یعنی بخشی از کار فکری به ابزار سپرده شده و باید هم در اعلام دقیق‌تر باشید و هم آن بخش را عمیق‌تر بفهمید و بازنویسی کنید. برای آشنایی با جایگاه کلی این ابزارها در پژوهش، صفحه‌ی هوش مصنوعی در پژوهش را ببینید.

    کاربردهای مسئولانه‌ی ChatGPT در مراحل نگارش مقاله

    حالا که قواعد روشن شد، ببینیم در عمل چگونه می‌توان از ChatGPT در هر مرحله‌ی نگارش مقاله به‌شکل مسئولانه بهره برد. این بخش را در سه مرحله سازمان‌دهی کرده‌ایم: پیش از نگارش، حین نگارش، و تحلیل داده و پاسخ به داوران. در هر مرحله، نمونه پرامپت‌ها و هشدارهای مرتبط را می‌آوریم.

    کاربردهای مسئولانه در استفاده از ChatGPT در مقاله
    کاربردهای مسئولانه در استفاده از ChatGPT در مقاله

    برای اینکه کاربردهای زیر را بهتر به کار بگیرید، یک اصل کلی را در نظر داشته باشید: هرچه ورودی شما به ابزار غنی‌تر و دقیق‌تر باشد، خروجی مفیدتر و کم‌خطرتر است. ابزاری که فقط موضوع مقاله را می‌داند، ناچار است حدس بزند؛ اما ابزاری که یادداشت‌ها، یافته‌ها و پیش‌نویس شما را در اختیار دارد، می‌تواند روی همان محتوا کار کند. به همین دلیل، کاربردهای مسئولانه تقریباً همیشه با «ورودی از شما» شروع می‌شوند، نه با «تولید از صفر».

    پیش از نگارش: ایده‌پردازی، طرح و مرور

    در مرحله‌ی پیش از نگارش، ChatGPT می‌تواند یک هم‌فکر سریع باشد. کاربردهای مفید:

    • شفاف‌سازی پیام اصلی: «این یافته‌های من است؛ پیام اصلی مقاله را در یک جمله با سه نسخه‌ی مختلف پیشنهاد بده.»
    • طرح کلی مقاله: «بر اساس این پیام و یافته‌ها، یک طرح IMRaD با سرفصل‌های فرعی پیشنهاد بده.»
    • توضیح مفاهیم: «تفاوت متغیر میانجی و تعدیل‌گر را با یک مثال از حوزه‌ی مدیریت توضیح بده.»
    • سؤالات انتقادی: «یک داور سخت‌گیر درباره‌ی این طرح پژوهش چه سؤالاتی می‌پرسد؟»

    اما برای مرور ادبیات، ChatGPT در حالت پایه ابزار مناسبی نیست، چون ممکن است منابع ساختگی تولید کند. برای یافتن مقالات واقعی، از ابزارهای مبتنی بر منبع استفاده کنید که در مقاله‌ی مقایسه Elicit و Consensus و SciSpace معرفی کرده‌ایم، یا با NotebookLM برای پژوهش با PDFهای خودتان کار کنید.

    وقتی از ChatGPT درباره‌ی ادبیات یک حوزه سؤال می‌پرسید، در انتهای پرامپت بنویسید: «هیچ منبعی نام نبر؛ فقط مفاهیم و نظریه‌های اصلی را بگو تا خودم منابع را پیدا کنم.» این کار ریسک ارجاعات جعلی را تقریباً حذف می‌کند.

    یک کاربرد ارزشمند دیگر در این مرحله، کمک به انتخاب مجله است. ChatGPT می‌تواند معیارهای انتخاب را توضیح دهد و انواع مجلات مناسب را پیشنهاد دهد، اما نام و وضعیت نمایه‌ی هر مجله را باید در Scopus و Web of Science بررسی کنید تا گرفتار مجلات جعلی نشوید.

    یک کاربرد کمتر شناخته‌شده در این مرحله، استفاده از ChatGPT برای آماده‌سازی خواندن است. وقتی با یک مقاله‌ی پیچیده یا روش آماری ناآشنا روبه‌رو می‌شوید، می‌توانید از ابزار بخواهید مفاهیم پیش‌نیاز را برایتان توضیح دهد تا مقاله‌ی اصلی را با فهم بهتری بخوانید. این کاربرد کاملاً با اخلاق پژوهش سازگار است، چون ابزار به یادگیری شما کمک می‌کند و جای خواندن منبع اصلی را نمی‌گیرد. البته توضیح‌ها را با کتاب‌های مرجع یا منابع آموزشی معتبر هم بسنجید.

    حین نگارش: ویرایش، ساختار و انسجام

    مهم‌ترین و پذیرفته‌شده‌ترین کاربرد ChatGPT، کمک به کیفیت زبانی و ساختاری متنی است که خودتان نوشته‌اید. جریان کاری پیشنهادی:

    1. بخش موردنظر را خودتان بنویسید، حتی اگر ناهموار باشد.
    2. آن را پاراگراف‌به‌پاراگراف به ابزار بدهید.
    3. در پرامپت دقیقاً بگویید چه نوع ویرایشی می‌خواهید.
    4. خروجی را با متن اصلی مقایسه کنید و فقط تغییراتی را بپذیرید که معنا را حفظ کرده‌اند.

    چند پرامپت آزموده‌شده:

    • ویرایش زبانی محافظه‌کارانه: «این پاراگراف را از نظر گرامر و خوانایی برای یک مجله‌ی علمی ویرایش کن. محتوا، ادعاها، اعداد و اصطلاحات تخصصی را تغییر نده. تغییرات را به‌صورت فهرست توضیح بده.»
    • بررسی انسجام: «این بخش مقدمه است. بررسی کن آیا جریان منطقی از زمینه به شکاف و سپس به هدف وجود دارد. پاراگراف‌هایی را که نامرتبط یا تکراری‌اند مشخص کن.»
    • یکدستی: «در این متن، اصطلاحات X و Y هر دو برای یک مفهوم به کار رفته‌اند. پیشنهاد بده کدام را یکدست استفاده کنم.»
    • کوتاه‌سازی: «این بخش ۱۸۰۰ کلمه است و مجله حداکثر ۱۲۰۰ کلمه می‌پذیرد. بدون حذف اطلاعات کلیدی، پیشنهاد بده کجا می‌توانم کوتاه کنم.»

    اگر انگلیسی زبان دوم شماست، ChatGPT می‌تواند فاصله‌ی زیادی را پر کند. اما به یاد داشته باشید که متن شما باید همچنان «صدای شما» را داشته باشد. ویراستاران و داوران باتجربه، متن‌هایی که به‌طور کامل با ابزار بازنویسی شده‌اند را اغلب از روی واژگان تکراری، جملات قالبی و لحن یکنواخت تشخیص می‌دهند. راهنمای کامل‌تر این مرحله را در مقاله‌نویسی علمی با هوش مصنوعی ببینید.

    در این مرحله، یک هشدار دیگر هم لازم است: ChatGPT گاهی در ویرایش، قطعیت ادعاها را تغییر می‌دهد. مثلاً جمله‌ی «یافته‌ها نشان می‌دهد که ممکن است ارتباطی وجود داشته باشد» را به «یافته‌ها اثبات می‌کند که X باعث Y می‌شود» تبدیل می‌کند. این تغییرات کوچک، معنای علمی را عوض می‌کنند و داوران به آن‌ها بسیار حساس‌اند. در پرامپت بنویسید: «میزان قطعیت ادعاها و زبان احتیاطی (hedging) را حفظ کن.» و پس از هر ویرایش، جملات کلیدی را دوباره با متن اصلی مقایسه کنید. همچنین مراقب باشید که ابزار به‌طور ناخواسته، ارجاعات درون‌متنی را جابه‌جا یا حذف نکند.

    تحلیل داده، کدنویسی و پاسخ به داوران

    تحلیل داده و کدنویسی: ChatGPT می‌تواند در نوشتن کد R، Python یا Syntax در SPSS کمک کند، خروجی‌های آماری را توضیح دهد و روش گزارش‌دهی را پیشنهاد کند. اگر از آن برای تحلیل داده یا تولید کد استفاده کرده‌اید، معمولاً باید در بخش روش اعلام کنید. نکات کلیدی:

    • کد تولیدشده را خط‌به‌خط بخوانید و بفهمید؛ هرگز کدی را که نمی‌فهمید اجرا و گزارش نکنید.
    • نتایج را با نرم‌افزار اصلی تطبیق دهید.
    • داده‌های خام با اطلاعات هویتی را در ابزار وارد نکنید.

    آموزش کامل تفسیر خروجی SPSS با کمک این ابزار را در تحلیل SPSS با ChatGPT آورده‌ایم.

    پاسخ به داوران: پس از دریافت نظرات داوران، ChatGPT می‌تواند در این کارها کمک کند:

    • دسته‌بندی نظرات به اصلی و جزئی، و به موارد قابل‌پذیرش و موارد نیازمند توضیح
    • پیشنهاد ساختار نامه‌ی پاسخ (Response to Reviewers) به‌صورت نقطه‌به‌نقطه
    • ویرایش لحن پاسخ‌ها برای مؤدبانه و حرفه‌ای بودن، به‌ویژه وقتی با نظر داور مخالفید

    اما تصمیم درباره‌ی اینکه کدام نقد را بپذیرید، چه تحلیل اضافه‌ای انجام دهید و چگونه استدلال کنید، تصمیم علمی شماست.

    اگر خودتان داور مقاله‌ی دیگران هستید، بدانید که بسیاری از ناشران و نهادها، بارگذاری مقاله‌ی تحت داوری در ابزارهای هوش مصنوعی عمومی را نقض محرمانگی داوری می‌دانند. پیش از هر استفاده، سیاست مجله درباره‌ی داوران را بررسی کنید.

    یک توصیه‌ی تکمیلی درباره‌ی تحلیل داده: اگر از قابلیت اجرای کد در ابزار استفاده می‌کنید و فایل داده را بارگذاری می‌کنید، فقط نسخه‌ی بی‌نام‌شده‌ی داده را وارد کنید و پیش از آن مطمئن شوید که رضایت‌نامه‌ی شرکت‌کنندگان چنین پردازشی را منع نکرده است. برای تحلیل‌های پیچیده‌تر یا زمانی که در انتخاب آزمون تردید دارید، مشورت با متخصص آمار همچنان بهترین راه است؛ صفحه‌ی تحلیل آماری ریسرچ اینتل در این زمینه کمک می‌کند. در پاسخ به داوران نیز به یاد داشته باشید که اگر تحلیل جدیدی به درخواست داور انجام می‌دهید، همان قواعد شفافیت درباره‌ی استفاده از ابزار در بخش روش اعمال می‌شود.

    مطالعهٔ تکمیلی: اگر می‌خواهید این موضوع را عمیق‌تر و بر پایهٔ یک منبع معتبر دانشگاهی دنبال کنید، راهنماهای اخلاق هوش مصنوعی در پژوهش، ویرایش مقاله با هوش مصنوعی و همکاری انسان و هوش مصنوعی را هم در ریسرچ اینتل بخوانید.

    نحوه‌ی اعلام استفاده از ChatGPT در مقاله و مدیریت ریسک‌ها

    اکنون به مهم‌ترین بخش عملی می‌رسیم: چگونه استفاده را اعلام کنیم؟ در این بخش، محل و شیوه‌ی اعلام را با نمونه‌متن‌های آماده توضیح می‌دهیم، نحوه‌ی ارجاع به ChatGPT در سبک APA را مرور می‌کنیم و ریسک‌هایی مثل آشکارسازها، محرمانگی و اعتماد داوران را بررسی می‌کنیم.

    نمونه متن اعلام استفاده از ChatGPT در مقاله
    نمونه متن اعلام استفاده از ChatGPT در مقاله

    پیش از نوشتن متن اعلام، از خودتان سه سؤال بپرسید: از کدام ابزار استفاده کردم؟ برای کدام بخش‌های مقاله؟ و با خروجی چه کردم؟ پاسخ این سه سؤال، اسکلت متن اعلام شماست. اگر دفترچه‌ی استفاده داشته باشید، پاسخ‌ها آماده‌اند.

    کجا و چگونه اعلام کنیم؟ نمونه‌متن‌های آماده

    محل اعلام بسته به سیاست مجله و نوع استفاده متفاوت است:

    • بخش اختصاصی اعلام (Declaration): مانند الزام Elsevier، معمولاً پیش از منابع.
    • بخش روش (Methods): اگر ابزار در گردآوری، تحلیل داده یا تولید کد نقش داشته است.
    • بخش تقدیر و تشکر (Acknowledgments): برای استفاده در نگارش و ویرایش، طبق توصیه‌ی ICMJE.
    • نامه‌ی همراه (Cover Letter): برخی مجلات اعلام در نامه‌ی همراه را هم می‌خواهند.
    • فرم ارسال آنلاین: برخی سامانه‌های ارسال، سؤال مشخصی درباره‌ی استفاده از هوش مصنوعی دارند.

    نمونه‌متن ۱ – فقط ویرایش زبانی:

    During the preparation of this work, the authors used ChatGPT (OpenAI) to improve the readability and language of the manuscript. After using this tool, the authors reviewed and edited the content as needed and take full responsibility for the content of the publication.

    نمونه‌متن ۲ – ویرایش و بازخورد ساختاری:

    The authors used ChatGPT (OpenAI) to provide feedback on the structure of the Introduction and Discussion sections and to edit the manuscript for grammar and clarity. All scientific content, interpretations, and conclusions were developed by the authors, who reviewed all AI-assisted edits and take full responsibility for the final text.

    نمونه‌متن ۳ – کمک در کدنویسی تحلیل (در بخش روش):

    ChatGPT (OpenAI) was used to assist in drafting R code for data visualization. All code was reviewed, tested, and validated by the authors against the original statistical output.

    نمونه‌ی فارسی برای مقالات داخلی:

    در تهیه‌ی این مقاله، نویسندگان از ابزار هوش مصنوعی ChatGPT صرفاً برای ویرایش نگارشی و بهبود خوانایی متن استفاده کرده‌اند. تمامی محتوای علمی، تحلیل‌ها و نتیجه‌گیری‌ها توسط نویسندگان انجام شده و مسئولیت کامل متن نهایی بر عهده‌ی آنان است.

    چند نکته برای نوشتن متن اعلام: نام ابزار و ارائه‌دهنده را ذکر کنید، نوع استفاده را مشخص و صادقانه بنویسید، تأکید کنید که خروجی‌ها بازبینی شده‌اند و مسئولیت را بپذیرید. از نوشتن عبارات مبهم مثل «از ابزارهای مختلف استفاده شد» پرهیز کنید.

    اگر از چند ابزار استفاده کرده‌اید (مثلاً ChatGPT برای ویرایش و Elicit برای یافتن مقالات)، همه را با نوع استفاده ذکر کنید. البته ابزارهای جست‌وجوی مقاله که فقط برای یافتن منابع به کار رفته‌اند و متن تولید نکرده‌اند، معمولاً نیاز به اعلام در بخش هوش مصنوعی مولد ندارند؛ با این حال، اگر مرور نظام‌مند انجام داده‌اید، ذکر ابزارهای جست‌وجو در بخش روش، بخشی از گزارش‌دهی شفاف بر اساس رهنمودهایی مانند PRISMA است.

    در پایان‌نامه‌ها هم همین اصول قابل‌اجراست. می‌توانید در مقدمه‌ی پایان‌نامه یا در پیوست، یک بخش کوتاه با عنوان «اعلام استفاده از ابزارهای هوش مصنوعی» اضافه کنید. این کار به‌ویژه اگر قصد دارید بعداً از پایان‌نامه مقاله استخراج کنید مفید است؛ راهنمای استخراج مقاله از پایان‌نامه و صفحه‌ی نگارش پایان‌نامه را در این زمینه ببینید.

    اشتباهات رایج در متن اعلام: برخی نویسندگان، استفاده‌ی گسترده را با عبارتی مثل «برای ویرایش جزئی» کم‌رنگ جلوه می‌دهند؛ برخی دیگر متن اعلام را از مقاله‌ی دیگری کپی می‌کنند بدون اینکه با استفاده‌ی واقعی خودشان تطابق داشته باشد؛ و برخی هم آن را در جایی قرار می‌دهند که مجله نخواسته است. هر سه اشتباه، در صورت بررسی دقیق، می‌تواند مشکل‌ساز شود. متن اعلام باید دقیق، متناسب با استفاده‌ی واقعی و در محل تعیین‌شده توسط مجله باشد.

    ارجاع‌دهی به ChatGPT در سبک APA

    گاهی ممکن است بخواهید به خروجی ChatGPT به‌عنوان موضوع پژوهش اشاره کنید؛ مثلاً اگر پژوهش شما درباره‌ی پاسخ‌های هوش مصنوعی است. در این حالت، انجمن روان‌شناسی آمریکا (APA) راهنمای مشخصی برای ارجاع ارائه کرده است. قالب کلی ارجاع در فهرست منابع به این صورت است:

    OpenAI. (2026). ChatGPT (Version) [Large language model]. https://chat.openai.com/

    و در متن به‌صورت (OpenAI, 2026) ارجاع داده می‌شود. APA همچنین توصیه می‌کند متن پرامپت را در متن یا پیوست ذکر کنید و اگر پاسخ طولانی است، آن را در پیوست بیاورید.

    اما توجه داشته باشید: ارجاع به ChatGPT به‌عنوان منبع یک ادعای علمی، کار درستی نیست. اگر ChatGPT گفته که «فلان نظریه این را بیان می‌کند»، باید منبع اصلی آن نظریه را پیدا و ارجاع دهید. ICMJE هم صراحتاً گفته است که هوش مصنوعی نباید به‌عنوان منبع اولیه‌ی ادعاها ارجاع داده شود. ارجاع به ChatGPT فقط زمانی معنا دارد که خود خروجی ابزار، موضوع بحث یا داده‌ی پژوهش شما باشد.

    برای تنظیم دقیق فهرست منابع، استفاده از نرم‌افزارهای مدیریت مرجع مثل Zotero و رعایت نسخه‌ی به‌روز سبک APA را پیشنهاد می‌کنیم.

    یک نکته‌ی دیگر درباره‌ی ارجاع: نسخه‌ی ابزار و تاریخ استفاده را ثبت کنید. پاسخ‌های مدل‌های زبانی با گذشت زمان و به‌روزرسانی‌ها تغییر می‌کند و ممکن است همان پرامپت در ماه بعد پاسخ متفاوتی بگیرد. به همین دلیل، اگر خروجی ابزار داده‌ی پژوهش شماست، متن کامل پاسخ‌ها را ذخیره و در پیوست یا مخزن داده‌ی مقاله منتشر کنید تا دیگران بتوانند کار شما را ارزیابی کنند. این همان اصل تکرارپذیری است که در همه‌ی پژوهش‌های علمی اهمیت دارد.

    ریسک‌ها: آشکارسازها، محرمانگی و اعتماد داوران

    آشکارسازهای متن هوش مصنوعی: بسیاری از دانشجویان نگران‌اند که مقاله‌شان در ابزارهای تشخیص متن ماشینی «مثبت» شود. چند واقعیت را بدانید: این ابزارها دقت محدودی دارند، ممکن است متن انسانی را به اشتباه ماشینی تشخیص دهند (به‌ویژه برای نویسندگان غیرانگلیسی‌زبان) و بیشتر مجلات معتبر به‌تنهایی بر اساس آن‌ها تصمیم نمی‌گیرند. بهترین محافظت، نوشتن واقعی با صدای خودتان، نگهداری نسخه‌های پیش‌نویس و اعلام شفاف استفاده است. اگر پرسشی مطرح شد، می‌توانید تاریخچه‌ی پیش‌نویس‌ها و دفترچه‌ی استفاده از ابزار را ارائه دهید.

    محرمانگی: مقاله‌ی منتشرنشده، دارایی فکری شما و هم‌نویسندگان است. پیش از وارد کردن متن کامل، تنظیمات حریم خصوصی ابزار را بررسی و در صورت امکان، استفاده از داده‌ها برای آموزش را غیرفعال کنید. داده‌های هویتی شرکت‌کنندگان را هرگز وارد نکنید.

    اعتماد داوران: آیا اعلام استفاده باعث بدبینی داوران می‌شود؟ تجربه نشان می‌دهد که اعلام شفاف و دقیق استفاده‌ی محدود (مانند ویرایش زبانی) معمولاً هیچ اثر منفی ندارد و حتی نشانه‌ی حرفه‌ای بودن است. آنچه اعتماد را از بین می‌برد، کشف استفاده‌ی اعلام‌نشده است؛ مثلاً وقتی داور در متن عباراتی مثل «As an AI language model» یا منابع ساختگی پیدا می‌کند. چنین مواردی در سال‌های اخیر به پس‌گرفتن چندین مقاله منجر شده است.

    دسترسی و حساب کاربری: برای پژوهشگران ایرانی، پایداری دسترسی به ابزار و امنیت حساب کاربری هم اهمیت دارد. حساب مشترک با دیگران، یعنی دیگران به تاریخچه‌ی گفت‌وگوها و متن مقاله‌ی شما دسترسی دارند. برای کارهای پژوهشی محرمانه، حساب شخصی با تأیید دومرحله‌ای استفاده کنید. صفحه‌ی خرید اکانت هوش مصنوعی گزینه‌های مختلف را معرفی کرده است. همچنین برای انتخاب ابزاری که بیشترین تناسب را با نیاز شما دارد، مقاله‌ی بهترین هوش مصنوعی برای پژوهش را بخوانید.

    اپلای و مکاتبات آکادمیک: همین اصول درباره‌ی SOP، ایمیل به استاد و رزومه هم صدق می‌کند. بسیاری از دانشگاه‌های خارجی اکنون در فرم‌های پذیرش، سؤالی درباره‌ی استفاده از هوش مصنوعی در نگارش مدارک دارند. ویرایش زبانی معمولاً پذیرفته است، اما متنی که کاملاً توسط ابزار تولید شده باشد، هم از نظر اخلاقی مسئله‌دار است و هم معمولاً کیفیت لازم برای متمایز کردن شما را ندارد. نکات تنظیم رزومه را در صفحه‌ی رزومه دکتری ببینید.

    یک «دفترچه‌ی استفاده از هوش مصنوعی» نگه دارید: تاریخ، ابزار، بخشی از مقاله، پرامپت کلیدی و نحوه‌ی استفاده از خروجی. این دفترچه هم نوشتن متن اعلام را آسان می‌کند و هم در صورت هر پرسشی از سوی مجله یا دانشگاه، مستند شما خواهد بود.

    در پایان، یادآوری می‌کنیم که قواعد این حوزه هنوز در حال تکامل است. ممکن است در سال‌های آینده، استانداردهای یکسان‌تری برای اعلام استفاده و قالب‌های مشخصی برای گزارش آن تدوین شود. بهترین راه برای به‌روز ماندن، دنبال کردن سیاست‌های ناشران اصلی حوزه‌ی خودتان، خبرنامه‌های COPE و رویدادهای آموزشی مثل برنامه‌های هفته پژوهش است. پیش از هر ارسال هم، یک بار دیگر سیاست مجله را بررسی کنید و برای آشنایی با کل فرایند ارسال و پیگیری، صفحه‌ی انتشار مقاله را ببینید.

    جمع‌بندی: استفاده از ChatGPT در مقاله علمی، وقتی شفاف، محدود به نقش دستیار و همراه با بازبینی دقیق باشد، نه‌تنها مجاز است بلکه می‌تواند کیفیت و سرعت کار شما را بالا ببرد. قواعد اصلی ساده‌اند: هوش مصنوعی نویسنده نیست، داده و منبع نمی‌سازد، استفاده باید اعلام شود و مسئولیت تمام متن با شماست. سیاست مجله‌ی هدف را بخوانید، از نمونه‌متن‌های بالا متناسب با استفاده‌ی واقعی خود بهره ببرید و دفترچه‌ی استفاده داشته باشید. برای یادگیری عملی این مهارت‌ها، دوره مقاله‌نویسی با هوش مصنوعی و بانک پرامپت‌های پژوهشی ریسرچ اینتل را ببینید و اگر در موارد خاص تردید دارید، از مشاوره پژوهشی کمک بگیرید.

    برای آموزش‌ها و مشاوره‌های بیشتر پژوهشی به هوش پژوهشی سر بزنید.
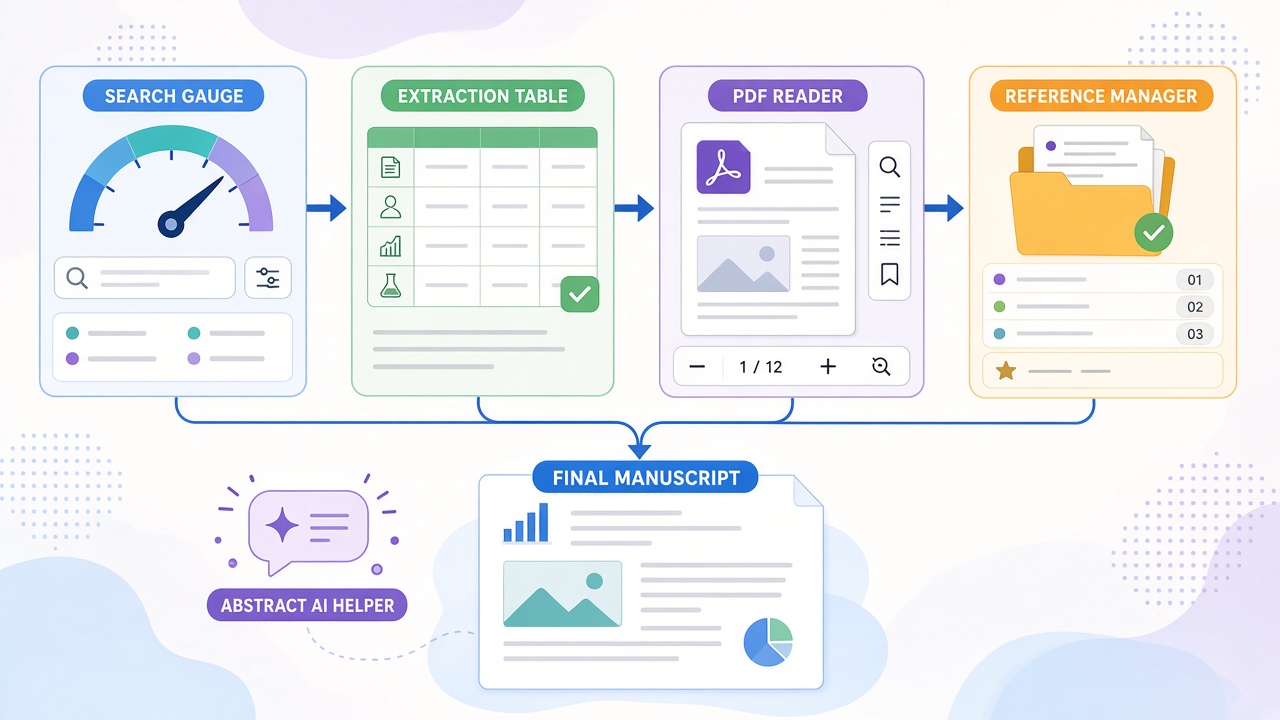
  • مجلات جعلی و لیست سیاه؛ تشخیص مجله معتبر

    مجلات جعلی و لیست سیاه؛ تشخیص مجله معتبر

    مجلات جعلی یکی از جدی‌ترین تهدیدهای پیش روی دانشجویان تحصیلات تکمیلی و پژوهشگران جوان در ایران و جهان هستند. هر سال تعداد زیادی از دانشجویانی که برای دفاع، اپلای یا ارتقا عجله دارند، مقاله‌ی حاصل ماه‌ها پژوهش خود را به مجله‌ای می‌سپارند که ظاهری حرفه‌ای دارد، وعده‌ی داوری سریع می‌دهد و در نهایت پس از دریافت هزینه، مقاله را بدون داوری واقعی منتشر می‌کند. نتیجه؟ مقاله‌ای که دانشگاه آن را نمی‌پذیرد، در پایگاه‌های معتبر دیده نمی‌شود و گاهی حتی نمی‌توان آن را پس گرفت و در جای دیگری منتشر کرد.

    مشکل وقتی جدی‌تر می‌شود که بدانیم این مجلات روزبه‌روز پیچیده‌تر شده‌اند. دیگر فقط سایت‌های ساده با غلط‌های املایی فاحش نیستند. برخی از آن‌ها ظاهر سایت مجلات معتبر را کپی می‌کنند، شماره‌ی ISSN واقعی را سرقت می‌کنند، هیئت تحریریه‌ای از نام‌های معروف (اغلب بدون اطلاع آن افراد) نمایش می‌دهند و حتی ادعا می‌کنند در Scopus یا Web of Science نمایه شده‌اند.

    در این راهنما، ابتدا توضیح می‌دهیم مجلات جعلی و ربوده‌شده دقیقاً چه هستند و چه پیامدهایی دارند. سپس منابع معتبر اعتبارسنجی، شامل لیست‌های سیاه و سفید بین‌المللی و فهرست‌های داخلی را معرفی می‌کنیم. در نهایت، یک چک‌لیست عملی و یک روش گام‌به‌گام برای بررسی هر مجله ارائه می‌دهیم و نشان می‌دهیم هوش مصنوعی چگونه می‌تواند در این بررسی کمک کند و کجا نباید به آن تکیه کرد.

    اگر ایمیلی دریافت کرده‌اید که شما را به ارسال مقاله با «داوری ۷ روزه» و «پذیرش تضمینی» دعوت می‌کند، پیش از هر پاسخی این مقاله را تا انتها بخوانید. هیچ مجله‌ی معتبری پذیرش را پیش از داوری تضمین نمی‌کند.

    چرا دانشجویان ایرانی بیشتر در معرض این خطر هستند؟ چند عامل هم‌زمان نقش دارند: الزام انتشار مقاله برای دفاع و فارغ‌التحصیلی، فشار زمانی در ماه‌های پایانی تحصیل، دشواری نگارش به انگلیسی، زمان‌های داوری طولانی مجلات معتبر و البته فعالیت واسطه‌هایی که با وعده‌ی «چاپ تضمینی» از این شرایط سوءاستفاده می‌کنند. شناخت این عوامل کمک می‌کند بدانید چه زمانی بیشتر باید مراقب باشید: معمولاً زمانی که عجله دارید و پیشنهادی «خیلی خوب برای واقعی بودن» به دستتان می‌رسد.

    نکته‌ی امیدوارکننده این است که تشخیص مجلات جعلی، مهارتی آموختنی است. با یک روش بررسی ساده که بیش از نیم ساعت وقت نمی‌گیرد، می‌توانید اکثر قریب به اتفاق مجلات مشکوک را شناسایی کنید. این نیم ساعت، ممکن است ماه‌ها کار پژوهشی شما را نجات دهد.

    مجلات جعلی چیست و چرا خطرناک‌اند؟

    برای مقابله با یک تهدید، ابتدا باید آن را دقیق بشناسیم. اصطلاح «مجله‌ی جعلی» در فارسی برای چند پدیده‌ی متفاوت به کار می‌رود که شناخت تفاوت آن‌ها در تشخیص اهمیت زیادی دارد. در این بخش، مجلات غارتگر (Predatory)، مجلات ربوده‌شده (Hijacked) و پیامدهای انتشار در آن‌ها را بررسی می‌کنیم.

    شناخت مجلات جعلی غارتگر و ربوده‌شده
    شناخت مجلات جعلی غارتگر و ربوده‌شده

    مجلات غارتگر (Predatory) چه ویژگی‌هایی دارند؟

    مجلات غارتگر، نشریاتی هستند که خود را مجله‌ی علمی دسترسی آزاد معرفی می‌کنند، اما هدف اصلی‌شان دریافت هزینه‌ی انتشار (APC) است، نه انتشار علم معتبر. در سال ۲۰۱۹، گروهی از پژوهشگران و ناشران در نشستی بین‌المللی تعریفی توافقی برای این پدیده ارائه کردند که در مجله‌ی Nature منتشر شد. بر اساس این تعریف، نشریات غارتگر «منافع شخصی را بر دانش مقدم می‌دانند و با اطلاعات نادرست، انحراف از رویه‌های ویرایشی و انتشاراتی استاندارد، نبود شفافیت و درخواست‌های تهاجمی و بی‌رویه مشخص می‌شوند.»

    ویژگی‌های رایج مجلات غارتگر:

    • داوری صوری یا بدون داوری: مقاله در چند روز «پذیرفته» می‌شود، معمولاً با نظرات داوری کلی و بی‌محتوا یا اصلاً بدون نظر.
    • ایمیل‌های انبوه و تملق‌آمیز: «ما مقاله‌ی برجسته‌ی شما را خواندیم و از شما دعوت می‌کنیم…»
    • دامنه‌ی موضوعی بسیار گسترده: مثلاً مجله‌ای که هم‌زمان مقاله‌ی پزشکی، مهندسی، مدیریت و ادبیات منتشر می‌کند.
    • ادعاهای نادرست درباره‌ی نمایه: ادعای نمایه در Scopus، ISI یا «Impact Factor» از منابع جعلی مثل «Global Impact Factor».
    • هزینه‌های پنهان یا ناگهانی: هزینه پس از پذیرش اعلام می‌شود یا مبالغ اضافی درخواست می‌شود.
    • هیئت تحریریه‌ی مشکوک: نام افرادی که وجود ندارند، اطلاعات تماس ناقص یا نام پژوهشگرانی که از عضویت خود بی‌اطلاع‌اند.
    • کیفیت پایین مقالات منتشرشده: مقالات با خطاهای فاحش علمی و زبانی.

    نکته‌ی مهم این است که «دسترسی آزاد» به خودی خود نشانه‌ی جعلی بودن نیست. بسیاری از مجلات بسیار معتبر دنیا دسترسی آزاد هستند و هزینه‌ی انتشار دریافت می‌کنند. تفاوت در این است که مجلات معتبر داوری واقعی، شفافیت کامل و رویه‌های ویرایشی استاندارد دارند.

    یک پدیده‌ی نزدیک به مجلات غارتگر، کنفرانس‌های جعلی است. این کنفرانس‌ها با نام‌های پرطمطراق و در شهرهای جذاب برگزار می‌شوند یا حتی اصلاً برگزار نمی‌شوند و فقط مقالات را با دریافت هزینه در «مجموعه‌مقالات» آنلاین منتشر می‌کنند. همان نشانه‌های هشدار مجلات غارتگر، یعنی پذیرش سریع، دامنه‌ی موضوعی گسترده و برگزارکنندگان ناشناخته، در این کنفرانس‌ها هم دیده می‌شود. پیش از ارسال مقاله به کنفرانس خارجی، سابقه‌ی برگزارکننده و نمایه‌ی مجموعه‌مقالات را بررسی کنید.

    مجلات ربوده‌شده (Hijacked): خطرناک‌تر از جعلی

    نوع دوم و خطرناک‌تر، مجلات ربوده‌شده هستند. در این پدیده، کلاهبرداران یک مجله‌ی واقعی و معتبر را انتخاب می‌کنند، معمولاً مجله‌ای که فقط نسخه‌ی چاپی دارد یا سایت ضعیفی دارد، و یک وب‌سایت جعلی با همان نام، همان ISSN و ظاهری مشابه می‌سازند. سپس مقالات را با دریافت هزینه در این سایت جعلی «منتشر» می‌کنند.

    چرا این نوع خطرناک‌تر است؟ چون اگر نام مجله را در Scopus جست‌وجو کنید، مجله را پیدا می‌کنید و فکر می‌کنید معتبر است. مشکل این است که آدرس سایتی که شما مقاله را به آن فرستاده‌اید، سایت واقعی مجله نیست. مقالاتی که در سایت ربوده‌شده منتشر می‌شوند، هرگز در مجله‌ی واقعی و در نمایه‌های معتبر ظاهر نمی‌شوند.

    نشانه‌های مجله‌ی ربوده‌شده:

    1. آدرس سایت با آدرسی که در Scopus یا سایت ناشر اصلی ثبت شده متفاوت است.
    2. دامنه‌ی سایت جدید است یا با پسوندهای غیرمعمول ثبت شده است.
    3. مجله‌ی اصلی معمولاً هزینه‌ی انتشار نمی‌گیرد، اما سایت جعلی هزینه می‌خواهد.
    4. مقالات منتشرشده در سایت جعلی موضوعات نامرتبط با حوزه‌ی اصلی مجله دارند.
    5. سایت فقط ایمیل‌های عمومی (مثل Gmail) برای تماس ارائه می‌دهد.

    قاعده‌ی طلایی: هرگز از لینک موجود در ایمیل دعوت یا نتایج جست‌وجوی عمومی به سایت مجله نروید؛ همیشه آدرس سایت را از منبع رسمی نمایه (Scopus، Web of Science یا سایت ناشر) بردارید.

    Scopus در سال‌های اخیر در صفحه‌ی پروفایل برخی مجلات، لینک سایت رسمی را نمایش می‌دهد. همچنین برخی پژوهشگران و نهادها فهرست‌هایی از مجلات ربوده‌شده‌ی شناخته‌شده را منتشر و به‌روز می‌کنند که می‌تواند در بررسی کمک کند.

    یک نمونه‌ی رایج دیگر در سال‌های اخیر، مجلاتی است که پس از حذف از Scopus همچنان روی سایت خود لوگو و ادعای نمایه را نگه می‌دارند. این مجلات ممکن است جعلی به معنای دقیق کلمه نباشند، اما مقالاتی که پس از تاریخ حذف منتشر می‌کنند، در Scopus نمایه نمی‌شوند. اگر دانشگاه شما نمایه در Scopus را شرط کرده باشد، چنین مقاله‌ای برای شما قابل‌قبول نخواهد بود. بنابراین تاریخ پایان پوشش را همیشه بررسی کنید و صرفاً به ادعای سایت مجله اعتماد نکنید.

    پیامدهای انتشار در مجلات جعلی برای دانشجو و پژوهشگر

    شاید فکر کنید «در بدترین حالت، مقاله در جای کم‌اعتبارتری منتشر شده است». اما پیامدها جدی‌تر از این هستند:

    • رد شدن برای دفاع یا ارتقا: بسیاری از دانشگاه‌ها مقالات منتشرشده در مجلات نامعتبر را برای نمره‌ی پایان‌نامه، شرط دفاع دکتری یا ارتقای اعضای هیئت علمی نمی‌پذیرند.
    • از دست رفتن پژوهش: چون مقاله «منتشر» شده، معمولاً نمی‌توانید آن را در مجله‌ی معتبر دیگری منتشر کنید. مجلات جعلی اغلب درخواست پس‌گرفتن را نادیده می‌گیرند یا برای آن هزینه می‌خواهند.
    • آسیب به اعتبار حرفه‌ای: نام شما در کنار یک مجله‌ی شناخته‌شده‌ی جعلی در رزومه، برای کمیته‌های پذیرش و استخدام علامت منفی است.
    • ضرر مالی: هزینه‌های پرداختی معمولاً قابل‌بازگشت نیستند.
    • آلوده کردن ادبیات علمی: پژوهش‌های بدون داوری می‌توانند یافته‌های نادرست را وارد ادبیات کنند.

    یک عادت ساده‌ی پیشگیرانه: پوشه‌ای در ایمیل خود به نام «دعوت مجلات» بسازید و همه‌ی ایمیل‌های ناخواسته‌ی دعوت را به آن منتقل کنید. بدون بررسی کامل، به هیچ‌کدام پاسخ ندهید. این کار هم ذهن شما را آرام نگه می‌دارد و هم مجموعه‌ای از نمونه‌ها برای یادگیری نشانه‌ها فراهم می‌کند.

    اگر قصد اپلای دارید، بدانید که کمیته‌های پذیرش در دانشگاه‌های خارجی معمولاً مجلات رزومه‌ی شما را بررسی می‌کنند. یک مقاله در مجله‌ی معتبر متوسط، از سه مقاله در مجلات مشکوک ارزشمندتر است. صفحه‌ی رزومه دکتری نکات بیشتری در این زمینه دارد.

    یکی دیگر از پیامدهای کمتر دیده‌شده، آسیب به هم‌نویسندگان است. وقتی شما مقاله را به مجله‌ی جعلی می‌فرستید، نام استاد راهنما و سایر نویسندگان هم در کنار آن مجله قرار می‌گیرد. به همین دلیل، اخلاق نشر ایجاب می‌کند که انتخاب مجله با تأیید همه‌ی نویسندگان انجام شود. اصول کلی رفتار مسئولانه در پژوهش و نشر را در صفحه‌ی صداقت علمی ریسرچ اینتل بخوانید. همچنین به یاد داشته باشید که پرداخت هزینه به واسطه‌هایی که وعده‌ی «چاپ تضمینی» می‌دهند، می‌تواند شما را درگیر پرونده‌های تخلف پژوهشی کند؛ چون برخی از این واسطه‌ها با کارخانه‌های تولید مقاله (Paper Mills) و خرید و فروش جایگاه نویسندگی مرتبط‌اند.

    لیست سیاه، لیست سفید و منابع اعتبارسنجی مجلات

    برای تشخیص اعتبار یک مجله، منابع مختلفی وجود دارد که هر کدام نقاط قوت و محدودیت‌هایی دارند. برخی «لیست سیاه» هستند، یعنی مجلات مشکوک را فهرست می‌کنند، و برخی «لیست سفید»، یعنی مجلات معتبر و نمایه‌شده را. در این بخش، تاریخچه‌ی لیست‌های سیاه، مهم‌ترین لیست‌های سفید بین‌المللی و فهرست‌های داخلی را مرور می‌کنیم.

    لیست سیاه و لیست سفید برای شناسایی مجلات جعلی
    لیست سیاه و لیست سفید برای شناسایی مجلات جعلی

    پیش از معرفی منابع، یک اصل را در نظر داشته باشید: هیچ منبع واحدی برای قضاوت درباره‌ی اعتبار یک مجله کافی نیست. ترکیب چند منبع، یعنی یک لیست سفید بین‌المللی، یک فهرست داخلی و بررسی مستقیم سایت و محتوای مجله، تصویر قابل‌اتکایی به شما می‌دهد. اگر این منابع با هم تناقض داشتند، مثلاً مجله در Scopus بود اما در فهرست نامعتبر وزارت علوم هم قرار داشت، معمولاً قاعده‌ی محتاطانه این است که فهرست داخلی را برای امور اداری مثل دفاع و ارتقا ملاک قرار دهید و پیش از ارسال با معاونت پژوهشی دانشگاه مشورت کنید.

    لیست بیل، Cabells و محدودیت‌های لیست سیاه

    مشهورترین لیست سیاه تاریخ نشر علمی، لیست بیل (Beall’s List) است که جفری بیل، کتابدار دانشگاه کلرادو، از حدود سال ۲۰۱۰ منتشر می‌کرد. این لیست شامل ناشران و مجلات مستقلی بود که به نظر او «احتمالاً غارتگر» بودند. در سال ۲۰۱۷، بیل به دلایلی که هرگز به‌طور کامل روشن نشد، لیست را از سایت خود حذف کرد. از آن زمان، نسخه‌های آرشیوی و به‌روزشده‌ای توسط افراد ناشناس در اینترنت منتشر می‌شود.

    چند نکته درباره‌ی استفاده از لیست بیل:

    • نسخه‌های فعلی توسط خود بیل نگهداری نمی‌شوند و کیفیت به‌روزرسانی آن‌ها نامشخص است.
    • لیست بیل در زمان خود هم منتقدانی داشت که معتقد بودند برخی ناشران به ناحق در آن قرار گرفته‌اند.
    • بسیاری از مجلات جعلی جدید پس از سال ۲۰۱۷ ایجاد شده‌اند و در نسخه‌های قدیمی وجود ندارند.

    جایگزین تجاری و ساختاریافته‌تر، Cabells Predatory Reports است که مجلات را با معیارهای مشخص و منتشرشده ارزیابی می‌کند و برای هر مجله دلایل قرار گرفتن در فهرست را ذکر می‌کند. این سرویس پولی است و معمولاً از طریق اشتراک کتابخانه‌های دانشگاهی در دسترس است.

    محدودیت اصلی همه‌ی لیست‌های سیاه این است که هرگز کامل نیستند. هر روز مجلات جعلی جدیدی با نام‌های تازه ایجاد می‌شوند. بنابراین «نبودن در لیست سیاه» به معنای «معتبر بودن» نیست. به همین دلیل، لیست‌های سفید منبع قابل‌اتکاتری برای تصمیم‌گیری هستند.

    رویکرد درست این است: ابتدا بررسی کنید مجله در لیست سفید معتبر (مثل Scopus یا Web of Science) هست یا نه. اگر بود، آدرس سایت رسمی را از همان‌جا بردارید. لیست‌های سیاه را فقط به‌عنوان یک هشدار تکمیلی استفاده کنید.

    یک خطای رایج دیگر، تکیه بر «لیست‌های سیاه» دست‌دوم است که در کانال‌ها و گروه‌های پیام‌رسان دست‌به‌دست می‌شوند. این فهرست‌ها معمولاً منبع مشخص، تاریخ به‌روزرسانی و معیار روشنی ندارند و ممکن است هم مجلات معتبر را به اشتباه شامل شوند و هم مجلات جعلی جدید را نداشته باشند. همیشه منبع اصلی و رسمی را ملاک قرار دهید.

    لیست‌های سفید: Scopus، Web of Science و DOAJ

    لیست‌های سفید، پایگاه‌هایی هستند که مجلات را پس از ارزیابی پذیرفته و نمایه کرده‌اند. مهم‌ترین آن‌ها:

    • Scopus: پایگاه استنادی Elsevier که فهرست منابع نمایه‌شده‌ی آن (Source List) به‌صورت عمومی در دسترس است. در صفحه‌ی هر مجله می‌توانید وضعیت پوشش، سال‌های نمایه، چارک (Quartile) در Scimago و ناشر را ببینید. دقت کنید که برخی مجلات پس از مدتی از Scopus حذف (Discontinued) می‌شوند؛ تاریخ پوشش را بررسی کنید.
    • Web of Science Master Journal List: فهرست رسمی مجلات نمایه‌شده در Web of Science (که در ایران گاهی به‌اشتباه ISI نامیده می‌شود). این فهرست شامل مجموعه‌های SCIE، SSCI، AHCI و ESCI است. ابزار جست‌وجوی Master Journal List رایگان است.
    • DOAJ (Directory of Open Access Journals): فهرست مجلات دسترسی آزاد که معیارهای کیفیت و شفافیت را رعایت می‌کنند. DOAJ مجلات را پیش از پذیرش بررسی می‌کند و مجلات متخلف را حذف می‌کند.
    • PubMed و MEDLINE: برای حوزه‌ی علوم پزشکی؛ البته توجه کنید که حضور یک مقاله در PubMed (از طریق PMC) به‌تنهایی نشانه‌ی معتبر بودن مجله نیست و باید به نمایه‌ی MEDLINE توجه کرد.
    • عضویت در COPE: کمیته‌ی اخلاق نشر (COPE) فهرست اعضای خود را منتشر می‌کند. عضویت در COPE نشانه‌ی تعهد به اصول اخلاق نشر است، هرچند به‌تنهایی تضمین کیفیت نیست.

    یک ابزار بسیار مفید دیگر، کمپین بین‌المللی Think. Check. Submit. است که یک چک‌لیست ساده و رایگان برای ارزیابی مجلات ارائه می‌دهد و به زبان‌های مختلف در دسترس است.

    درباره‌ی معیارهای کمّی مثل Impact Factor و CiteScore هم یک توضیح لازم است. Impact Factor واقعی فقط توسط Clarivate و در Journal Citation Reports منتشر می‌شود. CiteScore را Elsevier بر اساس داده‌های Scopus محاسبه می‌کند و SJR و چارک‌ها را سایت Scimago ارائه می‌دهد. هر عددی که از منابعی مثل «Universal Impact Factor»، «Global Impact Factor» یا «International Scientific Indexing» ادعا شود، معیار معتبری نیست و اغلب خودش نشانه‌ی هشدار است. هوش مصنوعی می‌تواند تفاوت این معیارها را برای شما توضیح دهد، اما عدد هر مجله را مستقیماً از منبع اصلی بخوانید.

    فهرست‌های داخلی: وزارت علوم، وزارت بهداشت و ISC

    در ایران، علاوه بر منابع بین‌المللی، چند منبع داخلی هم برای اعتبارسنجی مجلات اهمیت دارند:

    • فهرست نشریات نامعتبر وزارت علوم: معاونت پژوهشی وزارت علوم، تحقیقات و فناوری به‌طور دوره‌ای فهرستی از نشریات و ناشران نامعتبر یا مشکوک منتشر می‌کند که مقالات منتشرشده در آن‌ها برای امور آموزشی و پژوهشی (مانند ارتقا و دفاع) پذیرفته نمی‌شود. همیشه آخرین نسخه را از سایت رسمی بگیرید.
    • وزارت بهداشت: برای دانشگاه‌های علوم پزشکی، معاونت تحقیقات و فناوری وزارت بهداشت هم فهرست‌ها و ضوابط مشابهی دارد.
    • پایگاه استنادی علوم جهان اسلام (ISC): این پایگاه مجلات فارسی و منطقه‌ای را نمایه می‌کند و برای ارزیابی مجلات داخلی منبع مهمی است.
    • سامانه‌ی نشریات علمی کشور: برای بررسی رتبه و اعتبار نشریات داخلی و دارا بودن مجوز معتبر.
    • آیین‌نامه‌ی دانشگاه شما: برخی دانشگاه‌ها معیارهای سخت‌گیرانه‌تری دارند؛ مثلاً فقط مجلات دارای چارک مشخص را می‌پذیرند.

    مجله‌ای که امروز معتبر است، ممکن است فردا در فهرست نامعتبر قرار گیرد یا از Scopus حذف شود. پیش از ارسال و دوباره پیش از پرداخت هزینه، وضعیت مجله را بررسی کنید. ثبت تاریخ و تصویر صفحه‌ی بررسی، در صورت بروز اختلاف بعدی می‌تواند مفید باشد.

    یک توصیه‌ی کاربردی دیگر: کتابخانه‌ی مرکزی دانشگاه شما احتمالاً کارشناسانی دارد که در ارزیابی مجلات تجربه دارند و گاهی به پایگاه‌هایی مثل Cabells یا Journal Citation Reports دسترسی سازمانی دارند. پیش از ارسال مقاله به مجله‌ای که درباره‌ی آن مطمئن نیستید، با کتابخانه تماس بگیرید. این مشورت رایگان، یکی از کم‌استفاده‌ترین منابع دانشگاهی است.

    در کنار این منابع، داشتن دانش پایه درباره‌ی مرور ادبیات و شناخت مجلات اصلی حوزه‌ی خودتان هم یک سپر محافظتی مهم است. پژوهشگری که در طول نوشتن پیشینه، مقالات زیادی از مجلات معتبر حوزه‌اش خوانده، به‌طور طبیعی با نام ناشران، ساختار سایت‌ها و کیفیت مقالات معتبر آشناست و مجله‌ی مشکوک را راحت‌تر تشخیص می‌دهد. هنگام مرور ادبیات، فهرستی از مجلاتی که مقالات کلیدی شما در آن‌ها منتشر شده‌اند تهیه کنید؛ این فهرست، بهترین نقطه‌ی شروع برای انتخاب مجله‌ی هدف است. برای اصول مرور ادبیات، صفحه‌ی مرور ادبیات را ببینید و برای یافتن سریع‌تر مقالات کلیدی از ابزارهای معرفی‌شده در مقایسه Elicit و Consensus و SciSpace کمک بگیرید.

    مطالعهٔ تکمیلی: اگر می‌خواهید این موضوع را عمیق‌تر و بر پایهٔ یک منبع معتبر دانشگاهی دنبال کنید، راهنماهای اخلاق هوش مصنوعی در پژوهش، ویرایش مقاله با هوش مصنوعی و آینده هوش مصنوعی در پژوهش را هم در ریسرچ اینتل بخوانید.

    روش عملی تشخیص مجله معتبر و نقش هوش مصنوعی

    حالا که منابع را شناختیم، وقت آن است که یک روش عملی و قابل‌تکرار برای بررسی هر مجله داشته باشیم. در این بخش، چک‌لیستی از نشانه‌های هشدار، یک نمونه‌ی بررسی گام‌به‌گام ایمیل دعوت و نقش هوش مصنوعی در این فرایند را مرور می‌کنیم. همچنین می‌گوییم اگر گرفتار مجله‌ی جعلی شدید، چه کاری می‌توانید انجام دهید.

    روش گام‌به‌گام تشخیص مجلات جعلی پیش از ارسال مقاله
    روش گام‌به‌گام تشخیص مجلات جعلی پیش از ارسال مقاله

    این روش را یک بار با دقت روی چند مجله‌ی شناخته‌شده‌ی حوزه‌ی خودتان تمرین کنید؛ هم یک مجله‌ی معتبر و هم مجله‌ای که درباره‌اش تردید دارید. با این تمرین، چشم شما به تفاوت‌ها عادت می‌کند و دفعه‌ی بعد که ایمیل دعوت مشکوکی دریافت کردید، در چند دقیقه نشانه‌ها را تشخیص می‌دهید. می‌توانید نتیجه‌ی بررسی‌ها را در یک جدول ساده ذخیره کنید و با همکلاسی‌ها و همکاران پژوهشی به اشتراک بگذارید تا دیگران هم از تجربه‌ی شما استفاده کنند.

    چک‌لیست نشانه‌های هشدار

    هر چه تعداد بیشتری از این نشانه‌ها در یک مجله دیده شود، احتمال جعلی بودن آن بیشتر است:

    1. وعده‌ی داوری کمتر از دو هفته یا «پذیرش تضمینی»
    2. ایمیل دعوت ناخواسته با لحن تملق‌آمیز و ارجاع کلی به «مقاله‌ی اخیر شما»
    3. ادعای Impact Factor از منابعی غیر از Journal Citation Reports
    4. دامنه‌ی موضوعی بسیار گسترده و نامرتبط
    5. نبود اطلاعات روشن درباره‌ی فرایند داوری
    6. هزینه‌ی انتشار که در سایت به‌طور شفاف اعلام نشده است
    7. هیئت تحریریه‌ی ناشناخته یا بدون وابستگی سازمانی قابل‌بررسی
    8. آدرس فیزیکی نامشخص یا ناسازگار با کشور ادعایی
    9. ایمیل تماس با سرویس‌های عمومی مثل Gmail یا Yahoo
    10. خطاهای املایی و دستوری در سایت و ایمیل‌ها
    11. نام مجله شبیه به یک مجله‌ی معتبر شناخته‌شده
    12. نبود سیاست‌های اخلاقی روشن (سرقت علمی، پس‌گرفتن، تعارض منافع)
    13. مقالات منتشرشده با کیفیت پایین یا نامرتبط
    14. نبود DOI یا DOI‌هایی که در Crossref ثبت نشده‌اند
    15. فشار برای پرداخت فوری با روش‌های پرداخت غیرمعمول

    برای تکمیل این چک‌لیست، می‌توانید DOI مقالات منتشرشده‌ی مجله را در سایت Crossref بررسی کنید. اگر DOIها ثبت نشده باشند یا به سایت دیگری هدایت شوند، نشانه‌ی جدی هشدار است. همچنین جست‌وجوی چند عضو هیئت تحریریه در Google Scholar یا ORCID نشان می‌دهد آیا این افراد واقعاً وجود دارند و در آن حوزه فعال‌اند.

    فراتر از نشانه‌های منفی، به نشانه‌های مثبت هم توجه کنید. مجلات معتبر معمولاً این ویژگی‌ها را دارند: سیاست داوری روشن (یک‌سوکور، دوسوکور یا باز)، اعلام شفاف زمان متوسط داوری، هیئت تحریریه‌ی قابل‌بررسی با پروفایل‌های پژوهشی واقعی، عضویت در COPE یا پیروی از رهنمودهای آن، سیاست مشخص درباره‌ی هوش مصنوعی، استفاده از سامانه‌های استاندارد ارسال مقاله (مثل ScholarOne یا Editorial Manager) و آرشیو منظم شماره‌ها با DOI معتبر. هرچه این نشانه‌های مثبت بیشتر باشد، اطمینان شما می‌تواند بیشتر شود.

    بررسی گام‌به‌گام یک ایمیل دعوت

    فرض کنید ایمیلی با این مضمون دریافت کرده‌اید: «ما مقاله‌ی ارزشمند شما را در کنفرانس اخیر دیدیم و از شما دعوت می‌کنیم مقاله‌ی بعدی خود را برای International Journal of Advanced Research in Management Sciences ارسال کنید. داوری سریع، انتشار در کمتر از دو هفته، نمایه در Scopus و Google Scholar.» چه باید بکنید؟

    گام ۱ – مکث کنید: هیچ عجله‌ای نکنید و روی لینک‌های ایمیل کلیک نکنید.

    گام ۲ – جست‌وجو در لیست سفید: نام دقیق مجله و ISSN آن را در Scopus Sources و Web of Science Master Journal List جست‌وجو کنید. اگر پیدا نشد، تقریباً مطمئن باشید که ادعای نمایه نادرست است.

    گام ۳ – تطبیق آدرس سایت: اگر مجله در Scopus بود، آدرس سایت رسمی را از صفحه‌ی Scopus یا سایت ناشر بردارید و با آدرس داخل ایمیل مقایسه کنید.

    گام ۴ – بررسی وضعیت پوشش: آیا پوشش مجله در Scopus هنوز ادامه دارد یا Discontinued شده است؟

    گام ۵ – بررسی فهرست‌های داخلی: آیا مجله یا ناشر در فهرست نشریات نامعتبر وزارت علوم یا بهداشت قرار دارد؟

    گام ۶ – بررسی محتوا: چند مقاله‌ی اخیر مجله را باز کنید. آیا کیفیت علمی و زبانی قابل‌قبول دارند؟ آیا موضوعات با Aims and Scope سازگارند؟

    گام ۷ – مشورت: با استاد راهنما، کتابدار دانشگاه یا همکاران باتجربه مشورت کنید.

    نکته‌ی مهم در مثال بالا این است که «نمایه در Google Scholar» هیچ ارزشی به‌عنوان معیار اعتبار ندارد، چون Google Scholar تقریباً هر سندی را که ساختار آکادمیک داشته باشد، بدون ارزیابی کیفیت نمایه می‌کند.

    یک پرامپت کاربردی برای این مرحله: «این متن ایمیل دعوت یک مجله است. بر اساس معیارهای Think. Check. Submit. و نشانه‌های رایج مجلات غارتگر، هر نشانه‌ی هشدار را با نقل جمله‌ی مربوط مشخص کن و بگو چه چیزی را باید در منابع رسمی بررسی کنم. درباره‌ی معتبر بودن یا نبودن مجله حکم نهایی نده.» جمله‌ی آخر پرامپت مهم است، چون ابزار را از قضاوت نهایی که برای آن اطلاعات کافی ندارد بازمی‌دارد. پرامپت‌های بیشتر را در بانک پرامپت‌های پژوهشی ببینید.

    نقش هوش مصنوعی و اگر گرفتار شدید چه کنید

    آیا می‌توان از ChatGPT یا ابزارهای مشابه پرسید «آیا این مجله معتبر است؟» پاسخ این است: می‌توانید بپرسید، اما نباید به پاسخ اعتماد کنید. مدل‌های زبانی اطلاعات نمایه‌ی مجلات را به‌روز ندارند، ممکن است مجله‌ای را با مجله‌ی دیگری با نام مشابه اشتباه بگیرند و حتی ممکن است با اطمینان کامل بگویند یک مجله‌ی جعلی در Scopus نمایه است.

    کاربردهای درست هوش مصنوعی در این زمینه:

    • تحلیل ایمیل دعوت: متن ایمیل را به ابزار بدهید و بخواهید نشانه‌های هشدار را بر اساس چک‌لیست بالا شناسایی کند.
    • تحلیل متن سایت: متن صفحه‌ی «About» و «Peer Review Policy» را وارد کنید و بخواهید ناسازگاری‌ها و ادعاهای مبهم را مشخص کند.
    • فهم معیارها: توضیح مفاهیمی مثل Quartile، Impact Factor، CiteScore و تفاوت آن‌ها.
    • نوشتن ایمیل استعلام: کمک در نوشتن ایمیل مؤدبانه به دفتر مجله یا ناشر اصلی برای تأیید آدرس سایت.
    • پیشنهاد مجلات جایگزین: به‌عنوان نقطه‌ی شروع، به شرطی که همه را در لیست‌های سفید بررسی کنید.

    برای آشنایی با ابزارهای مناسب هر کار پژوهشی، مقاله‌ی بهترین هوش مصنوعی برای پژوهش را ببینید.

    اگر گرفتار مجله‌ی جعلی شدید:

    1. اگر هنوز مقاله منتشر نشده، فوراً با ایمیل کتبی درخواست انصراف (Withdrawal) بدهید و هیچ هزینه‌ای پرداخت نکنید.
    2. اگر منتشر شده، درخواست کتبی پس‌گرفتن را ارسال کنید و همه‌ی مکاتبات را نگه دارید.
    3. با استاد راهنما و معاونت پژوهشی دانشگاه موضوع را در میان بگذارید.
    4. پیش از ارسال به مجله‌ی دیگر، در نامه‌ی همراه وضعیت را صادقانه توضیح دهید؛ برخی مجلات معتبر در شرایط مستند، این مقالات را بررسی می‌کنند.

    برای آشنایی با مسیر صحیح انتخاب مجله و ارسال، صفحه‌ی انتشار مقاله ریسرچ اینتل و راهنمای استخراج مقاله از پایان‌نامه را ببینید.

    پیشگیری بهتر از درمان است: بهترین راه برای اینکه گرفتار مجلات جعلی نشوید، این است که از ابتدای پژوهش، چند مجله‌ی معتبر هدف را در نظر بگیرید و مقاله را مطابق استانداردهای آن‌ها بنویسید. وقتی مقاله‌ای باکیفیت و متناسب با یک مجله‌ی معتبر آماده دارید، وسوسه‌ی میان‌بُر زدن کمتر می‌شود. برنامه‌ریزی زمانی واقع‌بینانه هم مهم است: اگر می‌دانید داوری مجلات معتبر حوزه‌ی شما سه تا شش ماه طول می‌کشد، مقاله را حداقل شش ماه پیش از موعد دفاع ارسال کنید. اگر هنوز در مرحله‌ی نگارش پایان‌نامه هستید، راهنمای نوشتن پایان‌نامه با هوش مصنوعی را بخوانید تا از همان ابتدا با نگاه به انتشار بنویسید.

    همچنین درباره‌ی استفاده از هوش مصنوعی در نگارش مقاله، بدانید که مجلات معتبر سیاست‌های روشنی دارند و اعلام شفاف استفاده را می‌خواهند؛ در حالی که مجلات جعلی معمولاً هیچ سیاستی در این زمینه ندارند. نبود سیاست هوش مصنوعی در یک مجله در سال ۱۴۰۵، خود می‌تواند یک نشانه‌ی ضعف باشد. نحوه‌ی اعلام را در استفاده از ChatGPT در مقاله ببینید و برای آشنایی با کاربردهای مسئولانه‌ی این ابزارها، صفحه‌ی هوش مصنوعی در پژوهش و برنامه‌های آموزشی هفته پژوهش را دنبال کنید.

    جمع‌بندی: مجلات جعلی و ربوده‌شده با سوءاستفاده از عجله و ناآگاهی پژوهشگران کار می‌کنند. بهترین دفاع، یک روش بررسی منظم است: ابتدا لیست سفید (Scopus، Web of Science، DOAJ)، سپس تطبیق آدرس رسمی، بعد فهرست‌های داخلی و در نهایت بررسی محتوا و مشورت. هوش مصنوعی را برای تحلیل ایمیل‌ها و متن سایت‌ها به کار بگیرید، اما هرگز داوری نهایی درباره‌ی اعتبار مجله را به آن نسپارید. اگر برای انتخاب مجله‌ی مناسب و نوشتن مقاله‌ای که شانس واقعی پذیرش داشته باشد به همراهی نیاز دارید، مشاوره پژوهشی و دوره مقاله‌نویسی با هوش مصنوعی ریسرچ اینتل در کنار شماست. همچنین راهنمای مقاله‌نویسی علمی با هوش مصنوعی را برای بهبود کیفیت مقاله بخوانید.

    برای آموزش‌ها و مشاوره‌های بیشتر پژوهشی به هوش پژوهشی سر بزنید.
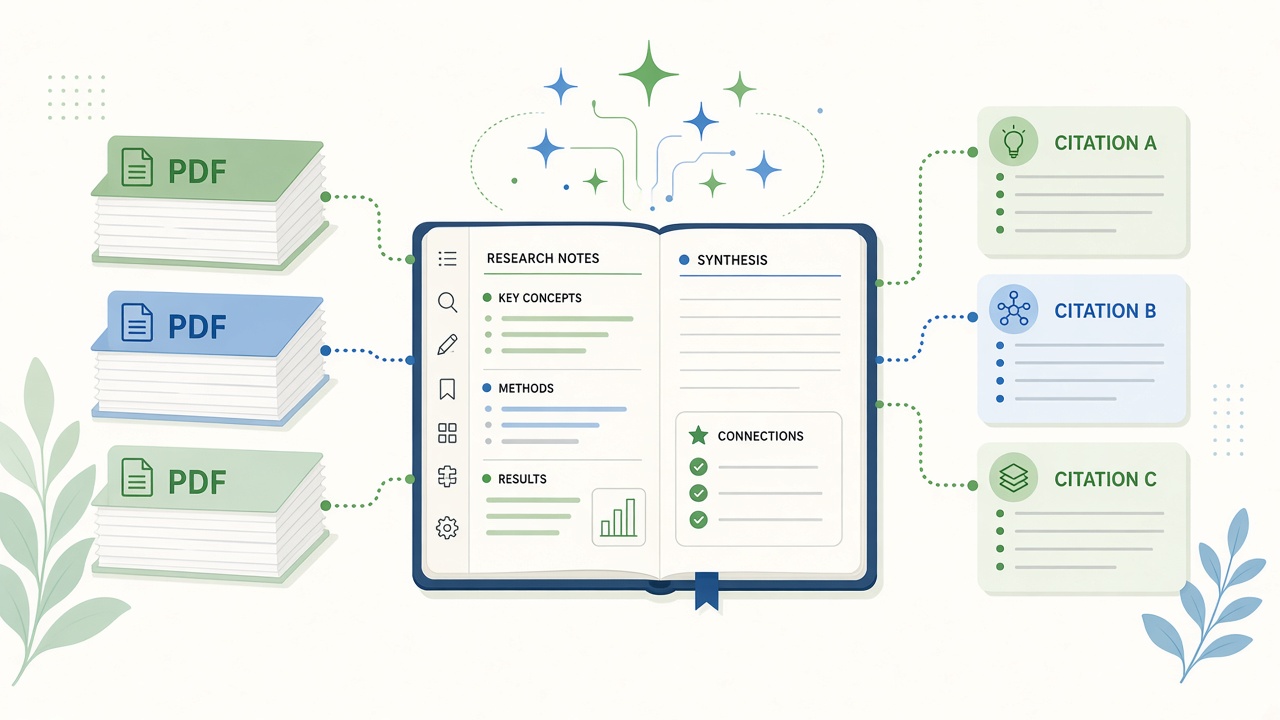
  • استخراج مقاله از پایان‌نامه؛ روش عملی و قالب IMRaD

    استخراج مقاله از پایان‌نامه؛ روش عملی و قالب IMRaD

    استخراج مقاله از پایان‌نامه یکی از مهم‌ترین و در عین حال سخت‌ترین مراحل مسیر تحصیلات تکمیلی است. شما ماه‌ها یا سال‌ها روی پژوهشی کار کرده‌اید، داده جمع کرده‌اید، تحلیل انجام داده‌اید و صدها صفحه نوشته‌اید. حالا باید همه‌ی این‌ها را در قالب یک مقاله‌ی شش تا ده هزار کلمه‌ای فشرده کنید که برای ویراستار یک مجله‌ی معتبر جذاب باشد و از داوری همتا عبور کند.

    بسیاری از دانشجویان تصور می‌کنند استخراج مقاله یعنی کپی کردن بخش‌هایی از هر فصل و کنار هم گذاشتن آن‌ها. نتیجه‌ی این کار معمولاً مقاله‌ای طولانی، نامتمرکز و با مقدمه‌ای پنج‌صفحه‌ای است که ویراستار پیش از رسیدن به یافته‌ها، آن را رد می‌کند. در واقع، استخراج مقاله نوعی «بازنویسی هدفمند» است؛ شما باید پیام اصلی را پیدا کنید، هر چیزی را که به آن پیام کمک نمی‌کند کنار بگذارید و باقی را با ساختار و زبان مقاله بازنویسی کنید.

    در این راهنمای عملی، ابتدا تفاوت‌های اساسی پایان‌نامه و مقاله، مقررات مربوط به نویسندگان و تصمیم‌گیری درباره‌ی تعداد مقالات را بررسی می‌کنیم. سپس گام‌به‌گام نشان می‌دهیم چگونه هر فصل پایان‌نامه به بخشی از قالب IMRaD تبدیل می‌شود. در نهایت، به نوشتن عنوان و چکیده، انتخاب مجله‌ی معتبر و نقش مسئولانه‌ی هوش مصنوعی در این فرایند می‌پردازیم.

    اگر هنوز پایان‌نامه را تمام نکرده‌اید، خواندن راهنمای نوشتن پایان‌نامه با هوش مصنوعی را پیشنهاد می‌کنیم. پایان‌نامه‌ای که از ابتدا با نگاه به انتشار نوشته شود، استخراج مقاله از آن بسیار آسان‌تر است.

    چرا این کار تا این حد مهم است؟ در بسیاری از دانشگاه‌ها، انتشار یا پذیرش مقاله‌ی مستخرج، بخشی از نمره‌ی پایان‌نامه یا شرط دفاع رساله‌ی دکتری است. فراتر از الزامات اداری، مقاله راهی است که پژوهش شما از قفسه‌ی کتابخانه‌ی دانشگاه بیرون می‌آید و در اختیار جامعه‌ی علمی قرار می‌گیرد. برای متقاضیان اپلای و کسانی که به دنبال موقعیت پژوهشی یا هیئت‌علمی هستند، مقالات منتشرشده در مجلات معتبر یکی از مهم‌ترین اجزای رزومه است. صفحه‌ی رزومه دکتری نشان می‌دهد این مقالات چگونه در پرونده‌ی شما دیده می‌شوند.

    چرا استخراج مقاله از پایان‌نامه ساده نیست؟

    پیش از شروع کار عملی، باید بدانیم چه چیزی پایان‌نامه را از مقاله متمایز می‌کند، چه قوانینی بر استخراج مقاله حاکم است و چگونه تصمیم بگیریم چند مقاله و با چه محتوایی از پایان‌نامه استخراج کنیم. این سه موضوع، پایه‌ی تمام تصمیم‌هایی است که در ادامه می‌گیرید و نادیده گرفتن آن‌ها می‌تواند به ریجکت، اختلاف میان نویسندگان یا حتی تخلف پژوهشی منجر شود.

    مقایسه پایان‌نامه و مقاله در استخراج مقاله از پایان‌نامه
    مقایسه پایان‌نامه و مقاله در استخراج مقاله از پایان‌نامه

    تفاوت‌های اساسی پایان‌نامه و مقاله‌ی علمی

    پایان‌نامه و مقاله هر دو گزارش پژوهش هستند، اما برای مخاطبان متفاوت و با اهداف متفاوت نوشته می‌شوند. پایان‌نامه برای نشان دادن «توانایی پژوهشی دانشجو» به کمیته‌ی داوران نوشته می‌شود؛ بنابراین جامع است، همه‌چیز را توضیح می‌دهد و نشان می‌دهد شما ادبیات حوزه را کامل می‌شناسید. مقاله برای «انتقال یک یافته‌ی مشخص به جامعه‌ی علمی» نوشته می‌شود؛ بنابراین متمرکز، فشرده و معطوف به یک پیام اصلی است.

    مهم‌ترین تفاوت‌ها را در این فهرست ببینید:

    • طول: پایان‌نامه معمولاً ۱۰۰ تا ۳۰۰ صفحه است؛ مقاله ۶ تا ۱۰ هزار کلمه، یعنی حدود ۲۰ تا ۳۰ صفحه با فاصله‌ی دوبرابر.
    • مخاطب: پایان‌نامه برای کمیته‌ی داوری؛ مقاله برای پژوهشگران متخصص که وقت محدودی دارند.
    • پیشینه: در پایان‌نامه یک فصل کامل؛ در مقاله چند پاراگراف در مقدمه.
    • مبانی نظری: در پایان‌نامه تفصیلی؛ در مقاله فقط نظریه‌هایی که مستقیماً به استدلال کمک می‌کنند.
    • روش: در هر دو باید قابل‌تکرار باشد، اما در مقاله فشرده‌تر و بدون توضیح کلیات روش‌شناختی.
    • نتایج: در پایان‌نامه همه‌ی تحلیل‌ها؛ در مقاله فقط تحلیل‌های مرتبط با پیام اصلی.
    • زبان: پایان‌نامه معمولاً فارسی؛ مقاله‌ی بین‌المللی انگلیسی و با سبک مجله‌ی هدف.

    قاعده‌ی کلیدی: مقاله خلاصه‌ی پایان‌نامه نیست؛ مقاله روایت متمرکز یک یافته‌ی مهم از پایان‌نامه است.

    یک پیامد عملی این تفاوت این است که شما باید آماده‌ی «حذف» باشید. بسیاری از بخش‌هایی که در پایان‌نامه با زحمت زیاد نوشته‌اید، مثل تاریخچه‌ی مفاهیم، تعاریف متعدد از یک متغیر یا جدول‌های جمعیت‌شناختی تفصیلی، در مقاله جایی ندارند. حذف این بخش‌ها از نظر روانی سخت است، اما برای موفقیت مقاله ضروری است.

    یک تفاوت مهم دیگر، لحن و صدا است. پایان‌نامه‌های فارسی معمولاً با لحن رسمی، جملات طولانی و گاهی مجهول نوشته می‌شوند. مقالات بین‌المللی امروز بیشتر به جملات کوتاه، فعل معلوم و زبان مستقیم گرایش دارند. بسیاری از مجلات حتی استفاده از «we» را برای اشاره به نویسندگان ترجیح می‌دهند. بنابراین استخراج مقاله فقط فشرده‌سازی محتوا نیست؛ تغییر سبک نگارش هم هست. هوش مصنوعی در این تغییر سبک بسیار مفید است، به شرطی که محتوا را دست‌نخورده نگه دارد.

    مقررات، ترتیب نویسندگان و وابستگی سازمانی

    استخراج مقاله از پایان‌نامه در ایران تابع آیین‌نامه‌های وزارت علوم یا وزارت بهداشت و مقررات داخلی هر دانشگاه است. چند نکته‌ی رایج که باید پیش از نوشتن با استاد راهنما هماهنگ کنید:

    1. ترتیب نویسندگان: در بسیاری از دانشگاه‌ها، دانشجو نویسنده‌ی اول و استاد راهنما نویسنده‌ی مسئول (Corresponding Author) است؛ اما این قاعده در همه‌جا یکسان نیست. ترتیب را از ابتدا و به‌صورت کتبی توافق کنید.
    2. وابستگی سازمانی (Affiliation): نام دانشگاه محل تحصیل باید به شکل استاندارد و یکسان ذکر شود. برخی دانشگاه‌ها شیوه‌ی نگارش دقیق نام انگلیسی را مشخص کرده‌اند.
    3. سهم استادان مشاور: حضور یا عدم حضور استادان مشاور در فهرست نویسندگان باید بر اساس سهم واقعی و آیین‌نامه‌ی دانشگاه تعیین شود.
    4. مجلات قابل‌قبول: برخی دانشگاه‌ها فهرستی از مجلات قابل‌قبول برای امتیاز دفاع یا ارتقا دارند و مجلات خاصی را نامعتبر اعلام کرده‌اند.
    5. ذکر منشأ مقاله: معمولاً باید در بخش تقدیر و تشکر یا پانویس ذکر شود که مقاله مستخرج از پایان‌نامه است.

    معیارهای نویسندگی در سطح بین‌المللی را توصیه‌نامه‌ی ICMJE به‌خوبی تعریف کرده است. بر اساس این معیارها، هر نویسنده باید در طراحی، اجرا یا تحلیل مشارکت اساسی داشته باشد، در نگارش یا بازبینی انتقادی نقش داشته باشد، نسخه‌ی نهایی را تأیید کند و مسئولیت محتوا را بپذیرد. افزودن نام افرادی که این معیارها را ندارند («نویسندگی هدیه») یا حذف کسانی که سهم داشته‌اند («نویسندگی پنهان»)، هر دو تخلف محسوب می‌شوند.

    پیش از ارسال مقاله، حتماً تأیید کتبی (حتی از طریق ایمیل) همه‌ی نویسندگان را بر نسخه‌ی نهایی و ترتیب نام‌ها بگیرید. اختلاف بر سر نویسندگی پس از انتشار، یکی از رایج‌ترین دلایل شکایت به COPE و دانشگاه‌هاست.

    مسئله‌ی دیگری که کمتر به آن توجه می‌شود، حق انتشار پایان‌نامه است. پایان‌نامه‌ها معمولاً در مخازن دانشگاهی یا ایرانداک ثبت می‌شوند و گاهی متن کامل آن‌ها در دسترس عموم است. برخی مجلات نگران‌اند که مقاله‌ی مستخرج، انتشار تکراری محسوب شود؛ اما بیشتر ناشران بزرگ صراحتاً اعلام کرده‌اند که پایان‌نامه‌ی منتشرنشده در مخزن دانشگاهی، «انتشار قبلی» محسوب نمی‌شود. با این حال، بهتر است در نامه‌ی همراه به ویراستار اطلاع دهید که مقاله از پایان‌نامه استخراج شده است. شفافیت در این زمینه، همان اصلی است که در صفحه‌ی صداقت علمی بر آن تأکید کرده‌ایم.

    چند مقاله؟ کدام یافته؟ پرهیز از برش سالامی

    سؤال بعدی این است که از یک پایان‌نامه چند مقاله می‌توان استخراج کرد. پاسخ به حجم و تنوع یافته‌ها بستگی دارد. یک پایان‌نامه‌ی ارشد معمولی معمولاً یک یا دو مقاله‌ی قوی تولید می‌کند و یک رساله‌ی دکتری ممکن است سه تا پنج مقاله داشته باشد. معیار اصلی این است که هر مقاله یک پیام مستقل و ارزشمند داشته باشد.

    راه‌های رایج برای تقسیم پایان‌نامه به چند مقاله:

    • مقاله‌ی اصلی: پاسخ به سؤال یا فرضیه‌ی اصلی پژوهش.
    • مقاله‌ی روش‌شناختی: اگر ابزار جدیدی ساخته یا اعتباریابی کرده‌اید، مثلاً اعتباریابی نسخه‌ی فارسی یک پرسشنامه.
    • مقاله‌ی مروری: اگر فصل دوم شما یک مرور نظام‌مند یا جامع است که ارزش انتشار مستقل دارد.
    • مقاله‌ی مکمل: یافته‌های فرعی که پیام متمایزی دارند، مثلاً تفاوت‌های جنسیتی یا نقش یک متغیر تعدیل‌گر.

    اما مراقب برش سالامی (Salami Slicing) باشید؛ یعنی تقسیم یک پژوهش واحد به چندین مقاله‌ی کوچک که هر کدام بخش ناچیزی از یافته‌ها را گزارش می‌کنند. این کار از نظر بیشتر ناشران و رهنمودهای اخلاق نشر، رفتار نامناسب است، چون ادبیات علمی را با مقالات تکراری پر می‌کند و ممکن است به انتشار تکراری (Duplicate Publication) منجر شود. اگر چند مقاله از یک داده‌ی مشترک منتشر می‌کنید، در هر مقاله به مقالات دیگر اشاره کنید و در نامه‌ی همراه به ویراستار اطلاع دهید.

    هوش مصنوعی در این مرحله می‌تواند هم‌فکر خوبی باشد. خلاصه‌ی یافته‌های پایان‌نامه را به ابزار بدهید و بپرسید: «با توجه به این یافته‌ها، چند مقاله‌ی مستقل با پیام متمایز می‌توان نوشت؟ برای هر کدام پیام اصلی و نوع مجله‌ی مناسب را پیشنهاد بده و بگو کجا خطر هم‌پوشانی وجود دارد.» سپس پیشنهادها را با استاد راهنما بررسی کنید.

    پیش از نوشتن هر مقاله، «پیام اصلی» آن را در یک جمله بنویسید و بالای فایل بچسبانید. در هر مرحله از نوشتن، هر پاراگراف را با این سؤال بسنجید: «آیا این پاراگراف به پیام اصلی کمک می‌کند؟» اگر پاسخ منفی است، حذفش کنید.

    یک ملاحظه‌ی زمانی هم وجود دارد: بهترین زمان برای شروع استخراج مقاله، بلافاصله پس از تکمیل فصل چهارم و پنجم است، یعنی زمانی که یافته‌ها هنوز در ذهن شما تازه است. بسیاری از دانشجویان پس از دفاع، استخراج مقاله را ماه‌ها عقب می‌اندازند و وقتی دوباره سراغش می‌روند، هم انگیزه کمتر است و هم پیشینه قدیمی‌تر شده است. اگر از ابتدا بدانید چه مقاله‌ای می‌خواهید بنویسید، می‌توانید حتی پیش از دفاع، پیش‌نویس اول را آماده کنید.

    تبدیل فصل‌های پایان‌نامه به قالب IMRaD

    حالا وارد بخش اصلی و عملی استخراج مقاله از پایان‌نامه می‌شویم. قالب IMRaD (مقدمه، روش، نتایج و بحث) استاندارد غالب مقالات پژوهشی تجربی است و نقشه‌ی تبدیل فصل‌های پایان‌نامه به آن نسبتاً روشن است: فصل‌های یک و دو به مقدمه، فصل سه به روش، فصل چهار به نتایج و فصل پنج به بحث تبدیل می‌شوند. اما این تبدیل، یک کپی ساده نیست و هر بخش ملاحظات خاص خودش را دارد.

    نقشه تبدیل فصل‌ها به IMRaD در استخراج مقاله از پایان‌نامه
    نقشه تبدیل فصل‌ها به IMRaD در استخراج مقاله از پایان‌نامه

    پیش از شروع تبدیل، یک کپی جداگانه از پایان‌نامه تهیه کنید و روی آن کار کنید. سپس با رنگ‌های مختلف، بخش‌هایی را که قطعاً در مقاله می‌مانند، بخش‌هایی که باید فشرده شوند و بخش‌هایی که حذف می‌شوند علامت بزنید. این «نقشه‌ی رنگی» دید کلی خوبی به شما می‌دهد و می‌توانید آن را با استاد راهنما هم مرور کنید. هوش مصنوعی می‌تواند برای هر فصل، پیشنهاد اولیه‌ی این دسته‌بندی را بدهد، اما قضاوت نهایی درباره‌ی اهمیت هر بخش، به شناخت شما از پژوهش و مجله‌ی هدف بستگی دارد. همچنین حواستان باشد که جمله‌های کپی‌شده از پایان‌نامه‌ی خودتان هم در بررسی شباهت مجلات ممکن است دیده شوند؛ بازنویسی با زبان مقاله، این مشکل را نیز برطرف می‌کند.

    از فصل اول و دوم به مقدمه‌ی مقاله

    مقدمه‌ی مقاله معمولاً بین ۸۰۰ تا ۱۵۰۰ کلمه است؛ در حالی که فصل اول و دوم پایان‌نامه ممکن است مجموعاً بیش از ۳۰ هزار کلمه باشند. این یعنی باید بیش از ۹۵ درصد این محتوا را کنار بگذارید یا به‌شدت فشرده کنید.

    ساختار پیشنهادی برای مقدمه‌ی مستخرج:

    1. پاراگراف اول (زمینه و اهمیت): چرا این موضوع مهم است؟ یک یا دو آمار یا شاهد کلیدی از بخش اهمیت و ضرورت فصل اول.
    2. پاراگراف‌های دوم تا چهارم (آنچه می‌دانیم): مرور فشرده‌ی مهم‌ترین یافته‌های پیشینه که مستقیماً به سؤال شما مربوط‌اند. معمولاً ۱۵ تا ۳۰ منبع کلیدی کافی است.
    3. پاراگراف پنجم (چارچوب نظری): نظریه‌ای که فرضیه‌ها را پشتیبانی می‌کند، در چند جمله.
    4. پاراگراف ششم (شکاف): آنچه نمی‌دانیم و چرا مهم است.
    5. پاراگراف پایانی (هدف): هدف مطالعه و در صورت نیاز، فرضیه‌ها.

    یک نکته‌ی مهم: پیشینه‌ی مقاله باید به‌روز باشد. اگر پایان‌نامه را دو سال پیش شروع کرده‌اید، احتمالاً مطالعات جدیدی منتشر شده که باید در مقدمه‌ی مقاله بیایند. داوران معمولاً به نبود منابع یک تا دو سال اخیر حساس‌اند. با جست‌وجو در Google Scholar و ابزارهایی مثل Elicit، مطالعات تازه را پیدا کنید. مقایسه‌ی ابزارهای این کار را در مقایسه Elicit و Consensus و SciSpace بخوانید.

    نقش هوش مصنوعی در این مرحله: می‌توانید فصل اول و بخش‌های کلیدی فصل دوم را (یا خلاصه‌ی آن‌ها را) به ابزار بدهید و بخواهید با توجه به پیام اصلی مقاله، مهم‌ترین استدلال‌ها و منابع را شناسایی کند. پرامپت نمونه: «پیام اصلی مقاله‌ی من این است: […]. از این متن، فقط استدلال‌ها و مطالعاتی را انتخاب کن که مستقیماً برای ساختن این پیام لازم‌اند و بقیه را کنار بگذار. هیچ منبع جدیدی اضافه نکن.» سپس مقدمه را خودتان بر اساس این انتخاب بنویسید.

    برای اصول مرور ادبیات فشرده و اثربخش، صفحه‌ی مرور ادبیات ریسرچ اینتل را ببینید.

    یک ترفند مفید برای فشرده‌سازی مقدمه، روش «درخت استدلال» است. پیام اصلی را در بالای یک صفحه بنویسید و زیر آن، سه یا چهار ادعای پشتیبان را که برای پذیرفتن پیام لازم است فهرست کنید. سپس برای هر ادعا، دو یا سه منبع کلیدی را مشخص کنید. هر چیزی که در این درخت جایی ندارد، احتمالاً در مقدمه‌ی مقاله هم جایی ندارد. هوش مصنوعی می‌تواند به شما کمک کند این درخت را از دل فصل دوم بیرون بکشید، اما تصمیم نهایی درباره‌ی شاخه‌ها با شماست. این روش، همچنین نوشتن پاسخ به داورانی را که می‌پرسند «چرا فلان مطالعه را ذکر نکرده‌اید؟» ساده‌تر می‌کند.

    از فصل سوم به بخش روش

    بخش روش مقاله معمولاً ۸۰۰ تا ۱۵۰۰ کلمه است. برخلاف فصل سوم پایان‌نامه که گاهی با تعاریف کلی «پژوهش کاربردی چیست» یا «روش توصیفی-همبستگی یعنی چه» شروع می‌شود، بخش روش مقاله مستقیماً به جزئیات مطالعه‌ی شما می‌پردازد.

    آنچه باید بماند:

    • طرح پژوهش در یک جمله (مثلاً «این مطالعه‌ی مقطعی با طرح همبستگی انجام شد»)
    • جامعه، روش نمونه‌گیری، حجم نمونه و نحوه‌ی تعیین آن
    • معیارهای ورود و خروج
    • ابزارها با نام، سازنده، تعداد گویه، طیف پاسخ و شواهد روایی و پایایی (هم از منبع اصلی و هم در نمونه‌ی شما)
    • روش اجرا و گردآوری داده
    • ملاحظات اخلاقی و کد اخلاق
    • روش‌ها و نرم‌افزارهای تحلیل

    آنچه باید حذف شود:

    • تعاریف کتاب‌درسی از انواع پژوهش
    • توضیح کلی درباره‌ی مفهوم روایی و پایایی
    • فرمول‌های عمومی آماری که همه می‌دانند
    • جزئیات اداری غیرضروری

    اگر مقاله را برای مجله‌ی بین‌المللی می‌فرستید، بررسی کنید که آیا برای نوع مطالعه‌ی شما چک‌لیست گزارش‌دهی خاصی وجود دارد؛ مثلاً STROBE برای مطالعات مشاهده‌ای، CONSORT برای کارآزمایی‌ها یا PRISMA برای مرورهای نظام‌مند. بسیاری از مجلات ارسال چک‌لیست تکمیل‌شده را الزامی می‌دانند.

    نقش هوش مصنوعی: فصل سوم را به ابزار بدهید و بخواهید بر اساس چک‌لیست مرتبط، آن را به بخش روش مقاله تبدیل کند و موارد جاافتاده را گزارش دهد. اما همه‌ی اعداد، نام ابزارها و ضرایب را با فصل اصلی و منابع تطبیق دهید.

    در بسیاری از موارد، هنگام استخراج مقاله متوجه می‌شوید که برخی جزئیات روش در پایان‌نامه به‌طور کامل ثبت نشده است؛ مثلاً نرخ پاسخ‌دهی، تعداد داده‌های گمشده و نحوه‌ی برخورد با آن‌ها یا جزئیات دقیق نسخه‌ی نرم‌افزار. این‌ها اطلاعاتی هستند که داوران مجلات بین‌المللی معمولاً می‌پرسند. پیش از نوشتن، به داده‌ها و یادداشت‌های اجرای پژوهش برگردید و این اطلاعات را کامل کنید. اگر در تحلیل‌های تکمیلی به کمک نیاز دارید، صفحه‌ی تحلیل آماری ریسرچ اینتل راهنمایی می‌کند.

    از فصل چهارم و پنجم به نتایج و بحث

    بخش نتایج در مقاله باید فقط یافته‌هایی را گزارش کند که به پیام اصلی مربوط‌اند. اگر در فصل چهارم ده آزمون فرضیه گزارش کرده‌اید و مقاله فقط بر سه فرضیه تمرکز دارد، فقط همان سه را بیاورید (و فرضیه‌های دیگر را در صورت لزوم برای مقاله‌ی دیگری نگه دارید، با رعایت اصول ضد برش سالامی). معمولاً سه تا پنج جدول یا شکل برای یک مقاله کافی است.

    نکات کلیدی برای نتایج:

    • جدول‌های جمعیت‌شناختی را خلاصه کنید؛ معمولاً یک جدول یا چند جمله کافی است.
    • آمار توصیفی و همبستگی متغیرهای اصلی را در یک جدول ترکیبی ارائه کنید.
    • گزارش آماری را مطابق سبک مجله (معمولاً APA) تنظیم کنید: مقدار آماره، درجه‌ی آزادی، مقدار p و اندازه‌ی اثر.
    • از تکرار اعداد جدول‌ها در متن پرهیز کنید؛ متن باید مهم‌ترین یافته‌ها را برجسته کند.

    اگر خروجی‌های SPSS را برای مقاله دوباره بررسی می‌کنید، راهنمای تحلیل SPSS با ChatGPT نحوه‌ی تفسیر و گزارش‌دهی درست را شرح داده است.

    بخش بحث معمولاً ۱۰۰۰ تا ۲۰۰۰ کلمه است. برخلاف فصل پنجم که گاهی برای هر فرضیه چند صفحه بحث دارد، بحث مقاله باید متمرکز باشد. ساختار پیشنهادی:

    1. یافته‌ی اصلی در یک یا دو جمله (بدون تکرار اعداد)
    2. مقایسه با مطالعات قبلی و تبیین نظری، برای هر یافته‌ی کلیدی
    3. نقاط قوت و محدودیت‌های مطالعه
    4. پیامدهای نظری و کاربردی
    5. پیشنهاد برای پژوهش‌های آینده
    6. نتیجه‌گیری کوتاه

    هنگام بازنویسی فصل پنجم برای مقاله، از ادعاهای بزرگ‌تر از داده پرهیز کنید. اگر مطالعه‌ی شما مقطعی است، از زبان علّی («باعث می‌شود»، «اثر می‌گذارد») با احتیاط استفاده کنید. داوران به این نوع اغراق‌ها بسیار حساس‌اند.

    نقش هوش مصنوعی: ابزار می‌تواند فصل پنجم شما را بخواند و بندهایی را که مستقیماً به یافته‌های منتخب مقاله مربوط‌اند جدا کند. همچنین می‌تواند بررسی کند که آیا ادعاها با طرح مطالعه سازگارند. اما تبیین‌ها و پیامدها باید از دانش و قضاوت شما بیایند.

    یک نکته‌ی تکمیلی درباره‌ی بحث: در پایان‌نامه، گاهی بحث با تکرار کامل یافته‌ها و اعداد شروع می‌شود. در مقاله، داوران این تکرار را نمی‌پسندند. به‌جای آن، بحث را با یک جمله‌ی جمع‌بندی‌کننده آغاز کنید که پاسخ پژوهش به مسئله را بیان می‌کند و سپس سراغ تفسیر بروید. همچنین بخش «نقاط قوت» را که در پایان‌نامه‌ها کمتر دیده می‌شود، فراموش نکنید؛ گفتن اینکه مطالعه‌ی شما از چه نظر نسبت به مطالعات قبلی برتری روش‌شناختی دارد، به داوران کمک می‌کند ارزش کار را بهتر ببینند.

    مطالعهٔ تکمیلی: اگر می‌خواهید این موضوع را عمیق‌تر و بر پایهٔ یک منبع معتبر دانشگاهی دنبال کنید، راهنماهای ویرایش مقاله با هوش مصنوعی، اخلاق هوش مصنوعی در پژوهش و ساخت پاورپوینت با هوش مصنوعی را هم در ریسرچ اینتل بخوانید.

    نهایی‌سازی، انتخاب مجله و نقش هوش مصنوعی

    پس از تبدیل فصل‌ها به IMRaD، مقاله هنوز آماده‌ی ارسال نیست. باید عنوان و چکیده‌ای قوی بنویسید، متن را به انگلیسی آکادمیک روان برسانید، مجله‌ی مناسب و معتبر را انتخاب کنید و در کل فرایند از هوش مصنوعی به‌شکل مسئولانه استفاده کنید. این بخش به همین مراحل نهایی می‌پردازد.

    نهایی‌سازی و انتخاب مجله پس از استخراج مقاله از پایان‌نامه
    نهایی‌سازی و انتخاب مجله پس از استخراج مقاله از پایان‌نامه

    عنوان، چکیده و ویرایش زبانی

    عنوان پایان‌نامه معمولاً طولانی است و همه‌ی متغیرها، جامعه و حتی سال را در بر دارد؛ مثلاً «بررسی رابطه‌ی حمایت سازمانی ادراک‌شده با فرسودگی شغلی با نقش میانجی تاب‌آوری در پرستاران بیمارستان‌های دولتی شهر تهران در سال ۱۴۰۴». عنوان مقاله باید کوتاه‌تر، جذاب‌تر و قابل‌جست‌وجوتر باشد؛ مثلاً «Perceived Organizational Support and Nurse Burnout: The Mediating Role of Resilience».

    برای نوشتن عنوان مقاله:

    • متغیرهای اصلی و نوع رابطه را حفظ کنید.
    • جامعه را در صورت اهمیت ذکر کنید، اما جزئیات مکانی و زمانی را معمولاً حذف کنید.
    • از کلمات زائد مثل «بررسی» یا «مطالعه‌ای درباره‌ی» پرهیز کنید.
    • از هوش مصنوعی بخواهید ده نسخه در سبک‌های مختلف پیشنهاد دهد و با سبک عناوین مجله‌ی هدف مقایسه کنید.

    چکیده‌ی مقاله معمولاً ۱۵۰ تا ۲۵۰ کلمه است و باید پس از نهایی شدن متن نوشته شود. چکیده‌ی پایان‌نامه را مستقیماً کپی نکنید؛ چون آن چکیده کل پایان‌نامه را خلاصه می‌کند، نه یافته‌های منتخب مقاله را. ابتدا خودتان پیش‌نویس را بنویسید، سپس از هوش مصنوعی بخواهید بررسی کند که آیا هدف، روش، یافته‌های کلیدی با اعداد و نتیجه‌گیری در آن حضور دارند و آیا در محدوده‌ی کلمات مجله است.

    ویرایش زبانی: اگر پایان‌نامه فارسی است و مقاله انگلیسی، توصیه‌ی ما این است که مقاله را مستقیماً به انگلیسی بنویسید، حتی اگر ابتدا ساده و ناهموار باشد، و سپس با کمک هوش مصنوعی ویرایش کنید. ترجمه‌ی ماشینی کامل متن فارسی معمولاً جملات طولانی و ساختارهای غیرطبیعی تولید می‌کند. در پرامپت ویرایش، صراحتاً بنویسید: «فقط زبان را بهبود بده؛ محتوا، ادعاها، اعداد و اصطلاحات تخصصی را تغییر نده.» جزئیات بیشتر را در مقاله‌نویسی علمی با هوش مصنوعی آورده‌ایم.

    نامه‌ی همراه و آماده‌سازی فایل‌ها: پس از نهایی شدن متن، نامه‌ی همراه کوتاهی بنویسید که پیام اصلی، دلیل تناسب با مجله و مستخرج بودن مقاله از پایان‌نامه را ذکر کند. فایل‌ها را مطابق راهنمای مجله آماده کنید: صفحه‌ی عنوان جداگانه با اطلاعات نویسندگان، متن بی‌نام برای داوری دوسوکور، جدول‌ها و شکل‌ها با کیفیت مناسب و فرم‌های تعارض منافع. بسیاری از ریجکت‌های اولیه به‌خاطر رعایت نکردن همین الزامات فنی است، نه کیفیت علمی.

    انتخاب مجله‌ی معتبر و پرهیز از مجلات جعلی

    انتخاب مجله باید پیش از نهایی‌سازی مقاله انجام شود، چون طول، ساختار و سبک ارجاع‌دهی به آن بستگی دارد. معیارهای انتخاب:

    • تناسب موضوع با Aims and Scope مجله
    • نمایه شدن در Scopus، Web of Science یا پایگاه‌های معتبر رشته
    • مقبولیت در آیین‌نامه‌ی دانشگاه شما
    • زمان داوری و انتشار، به‌ویژه اگر برای دفاع یا اپلای محدودیت زمانی دارید
    • هزینه‌ی انتشار در مجلات دسترسی آزاد
    • انتشار مقالات مشابه در شماره‌های اخیر مجله

    ابزارهایی مثل Elsevier Journal Finder و Springer Journal Suggester می‌توانند بر اساس عنوان و چکیده، مجلات مناسب را پیشنهاد دهند. هوش مصنوعی هم می‌تواند فهرست اولیه‌ای بدهد، اما همیشه نمایه و اعتبار مجله را مستقیماً در سایت Scopus یا Web of Science بررسی کنید، چون مدل‌ها گاهی اطلاعات قدیمی یا نادرست دارند.

    خطر مجلات جعلی: دانشجویانی که برای دفاع عجله دارند، هدف اصلی مجلات جعلی (Predatory) و مجلات ربوده‌شده (Hijacked) هستند. این مجلات با ایمیل‌های جذاب، وعده‌ی داوری یک‌هفته‌ای و پذیرش قطعی، مقاله را در ازای هزینه منتشر می‌کنند؛ اما مقاله‌ی شما در جایی منتشر می‌شود که اعتبار علمی ندارد و ممکن است دانشگاه آن را نپذیرد. نحوه‌ی تشخیص این مجلات را در مقاله‌ی مجلات جعلی و لیست سیاه به تفصیل توضیح داده‌ایم.

    هیچ مجله‌ی معتبری پذیرش مقاله را پیش از داوری تضمین نمی‌کند. اگر کسی «پذیرش تضمینی» یا «چاپ قطعی در مجله‌ی ISI» وعده می‌دهد، با احتمال بسیار زیاد با یک مجله‌ی جعلی یا یک واسطه‌ی متخلف سروکار دارید. صفحه‌ی انتشار مقاله ریسرچ اینتل راهنمای مسیر صحیح انتشار است.

    یک توصیه‌ی دیگر: پیش از ارسال به مجله‌ی خارجی، بررسی کنید که آیا مجله در فهرست مجلات نامعتبر وزارت علوم یا دانشگاه شما قرار دارد یا نه. این فهرست‌ها به‌طور دوره‌ای به‌روز می‌شوند و انتشار در مجله‌ای که در فهرست قرار گرفته، ممکن است برای دفاع یا ارتقا قابل‌قبول نباشد. همچنین اگر مجله‌ای ایمیل دعوت به ارسال برای شما فرستاده، پیش از هر اقدامی آدرس سایت آن را با آدرس ثبت‌شده در Scopus یا سایت ناشر مقایسه کنید تا از ربوده‌نشدن آن مطمئن شوید.

    پرامپت‌ها و جریان کاری مسئولانه با هوش مصنوعی

    برای جمع‌بندی، یک جریان کاری کامل استخراج مقاله از پایان‌نامه با کمک هوش مصنوعی را مرور می‌کنیم:

    1. تعیین پیام اصلی: خلاصه‌ی یافته‌ها را به ابزار بدهید و چند نسخه‌ی پیام اصلی بخواهید؛ با استاد یکی را انتخاب کنید.
    2. طرح یک‌صفحه‌ای: برای هر بخش IMRaD سه جمله بنویسید و از ابزار بخواهید منطق کلی را نقد کند.
    3. انتخاب محتوا: از ابزار بخواهید از هر فصل بخش‌های مرتبط با پیام اصلی را شناسایی کند.
    4. نگارش: هر بخش را خودتان بنویسید، با محتوای منتخب و با زبان مقاله.
    5. به‌روزرسانی پیشینه: با ابزارهای مبتنی بر منبع، مطالعات جدید را پیدا کنید و خودتان بخوانید.
    6. ویرایش زبانی: پاراگراف‌به‌پاراگراف با ابزار ویرایش کنید و تغییرات را بررسی کنید.
    7. داوری شبیه‌سازی‌شده: از ابزار بخواهید نقش داور را بازی کند و گزارش داوری بنویسد.
    8. اعلام استفاده: بر اساس سیاست مجله، استفاده از هوش مصنوعی را اعلام کنید.

    چند پرامپت کاربردی دیگر:

    • «این بخش روش از پایان‌نامه‌ی من است. آن را به بخش روش یک مقاله‌ی ۱۰۰۰ کلمه‌ای تبدیل کن، تعاریف کلی را حذف کن و اگر بر اساس چک‌لیست STROBE چیزی جا افتاده، فهرست کن.»
    • «این بحث فصل پنجم است. فقط بندهای مرتبط با فرضیه‌های ۱ و ۳ را نگه دار و بگو کجا ادعا فراتر از طرح مقطعی مطالعه است.»
    • «این چکیده‌ی مقاله‌ی من است. بررسی کن آیا با متن مقاله سازگار است و ادعای اضافه‌ای ندارد.»

    پرامپت‌های بیشتر برای هر مرحله‌ی استخراج و نگارش مقاله را در بانک پرامپت‌های پژوهشی پیدا می‌کنید. نحوه‌ی اعلام استفاده از ابزار در مقاله را هم با نمونه‌متن در استفاده از ChatGPT در مقاله ببینید.

    درباره‌ی ابزارها هم یک نکته‌ی عملی: برای کار با متن‌های بلند پایان‌نامه، ابزارهایی که پنجره‌ی متنی بزرگ‌تری دارند یا امکان بارگذاری فایل را فراهم می‌کنند، کار را ساده‌تر می‌کنند. اگر نسخه‌ی رایگان ابزار محدودیت دارد، می‌توانید فصل‌ها را بخش‌بخش وارد کنید یا از نسخه‌های پیشرفته استفاده کنید؛ صفحه‌ی خرید اکانت هوش مصنوعی گزینه‌ها را معرفی کرده است. انتخاب ابزار مناسب را هم در بهترین هوش مصنوعی برای پژوهش بخوانید. در هر حال، پیش از بارگذاری متن کامل، تنظیمات حریم خصوصی را بررسی کنید و از وارد کردن داده‌های هویتی خودداری کنید. برای آشنایی گسترده‌تر با کاربردهای این ابزارها هم صفحه‌ی هوش مصنوعی در پژوهش و رویدادهای آموزشی هفته پژوهش را دنبال کنید.

    جمع‌بندی: استخراج مقاله از پایان‌نامه، تبدیل یک گزارش جامع به یک روایت متمرکز است. با تعیین پیام اصلی شروع کنید، مقررات نویسندگی را از ابتدا روشن کنید، از برش سالامی پرهیز کنید، هر فصل را با منطق IMRaD فشرده و بازنویسی کنید، پیشینه را به‌روز کنید، مجله‌ی معتبر را با دقت انتخاب کنید و از هوش مصنوعی به‌عنوان دستیار سازمان‌دهی، ویرایش و نقد، نه نویسنده، استفاده کنید. اگر به همراهی تخصصی نیاز دارید، مشاوره پژوهشی ریسرچ اینتل و دوره مقاله‌نویسی با هوش مصنوعی در کنار شما هستند. همچنین برای ثبت پروفایل پژوهشی، یک شناسه‌ی ORCID بسازید و آن را به مقالات خود متصل کنید.

    برای آموزش‌ها و مشاوره‌های بیشتر پژوهشی به هوش پژوهشی سر بزنید.
  • نوشتن پایان‌نامه با هوش مصنوعی؛ فصل‌به‌فصل

    نوشتن پایان‌نامه با هوش مصنوعی؛ فصل‌به‌فصل

    نوشتن پایان‌نامه با هوش مصنوعی برای بسیاری از دانشجویان هم فرصت است و هم نگرانی. فرصت، چون ابزارهایی مثل ChatGPT، Claude، Gemini و NotebookLM می‌توانند ساعت‌ها از وقت صرف‌شده برای سازمان‌دهی، خلاصه‌نویسی و ویرایش را کم کنند. نگرانی، چون مرز میان استفاده‌ی مجاز و تخلف پژوهشی برای خیلی‌ها روشن نیست و ترس از رد شدن در سامانه‌ی همانندجو یا زیر سؤال رفتن اصالت کار، همیشه وجود دارد.

    پایان‌نامه با مقاله و پروپوزال تفاوت مهمی دارد: طولانی‌تر است، چند ماه یا چند سال طول می‌کشد، ساختار فصل‌بندی مشخصی دارد و در نهایت باید در جلسه‌ای رسمی از تک‌تک صفحات آن دفاع کنید. همین ویژگی‌ها باعث می‌شود که نحوه‌ی استفاده از هوش مصنوعی در هر فصل متفاوت باشد. کاری که در فصل اول مفید است، ممکن است در فصل چهارم خطرناک باشد.

    در این راهنمای فصل‌به‌فصل، ابتدا چارچوب کلی، قوانین و جریان کاری مناسب را مرور می‌کنیم. سپس برای هر یک از پنج فصل رایج پایان‌نامه‌های ایرانی، توضیح می‌دهیم که هوش مصنوعی دقیقاً چه کمکی می‌کند، چه پرامپت‌هایی مفیدند و کجا باید متوقف شوید. در پایان هم به نوشتن چکیده، ویرایش نهایی و آمادگی برای جلسه‌ی دفاع می‌پردازیم.

    این راهنما فرض می‌کند پروپوزال شما تصویب شده است. اگر هنوز در مرحله‌ی پروپوزال هستید، ابتدا مقاله‌ی نوشتن پروپوزال با هوش مصنوعی را بخوانید؛ چون کیفیت پایان‌نامه تا حد زیادی به کیفیت پروپوزال وابسته است.

    یک نکته‌ی واقع‌بینانه را هم از همین ابتدا بگوییم: هوش مصنوعی زمان نوشتن پایان‌نامه را کوتاه‌تر می‌کند، اما آن را حذف نمی‌کند. کارهایی مثل گردآوری داده، هماهنگی با استاد، خواندن منابع اصلی و اصلاحات پس از بازخورد، همچنان زمان می‌برند. دانشجویانی که انتظار دارند با چند پرامپت در چند روز پایان‌نامه را تمام کنند، معمولاً با متنی روبه‌رو می‌شوند که در اولین جلسه با استاد راهنما رد می‌شود. اما دانشجویانی که هوش مصنوعی را به‌عنوان دستیار در کنار کار منظم خود به کار می‌گیرند، معمولاً گزارش می‌دهند که کیفیت متن و سرعت پیشرفتشان به‌طور محسوسی بهتر شده است.

    پیش از شروع: ساختار، قوانین و جریان کاری

    بسیاری از دانشجویان مستقیم سراغ ابزار می‌روند و از همان روز اول از ChatGPT می‌خواهند فصل اول را بنویسد. این شروع اشتباه، معمولاً به متنی کلی، ناهماهنگ و پر از ارجاعات نامعتبر منجر می‌شود که بعداً باید از نو نوشته شود. قبل از هر چیز، سه کار را انجام دهید: ساختار پایان‌نامه را دقیق بشناسید، قوانین دانشگاه و سامانه‌های همانندجویی را بدانید و یک جریان کاری منظم برای خودتان بسازید.

    برنامه‌ریزی و جریان کاری برای نوشتن پایان‌نامه با هوش مصنوعی
    برنامه‌ریزی و جریان کاری برای نوشتن پایان‌نامه با هوش مصنوعی

    ساختار پنج‌فصلی پایان‌نامه و نقش هر فصل

    بیشتر پایان‌نامه‌های کارشناسی ارشد و رساله‌های دکتری در دانشگاه‌های ایران از ساختار پنج‌فصلی پیروی می‌کنند. هرچند برخی رشته‌ها، به‌ویژه مهندسی و علوم پایه، ساختار متفاوتی دارند، منطق کلی یکسان است:

    1. فصل اول، کلیات پژوهش: بیان مسئله، اهمیت و ضرورت، اهداف، سؤالات و فرضیه‌ها، تعریف مفهومی و عملیاتی متغیرها.
    2. فصل دوم، مبانی نظری و پیشینه: چارچوب نظری، مدل مفهومی و مرور پژوهش‌های داخلی و خارجی.
    3. فصل سوم، روش‌شناسی: نوع پژوهش، جامعه و نمونه، ابزار گردآوری، روایی و پایایی، روش تحلیل.
    4. فصل چهارم، تجزیه و تحلیل داده‌ها: آمار توصیفی و استنباطی یا یافته‌های کیفی.
    5. فصل پنجم، بحث و نتیجه‌گیری: تفسیر یافته‌ها، مقایسه با پیشینه، محدودیت‌ها و پیشنهادها.

    هر فصل نوع متفاوتی از کار فکری را می‌طلبد. فصل اول و دوم بیشتر «استدلالی و مروری» هستند، فصل سوم «فنی و دقیق»، فصل چهارم «عددی و گزارشی» و فصل پنجم «تفسیری و انتقادی». به همین دلیل، نقش هوش مصنوعی در هر فصل فرق می‌کند. برای مثال، در فصل دوم خطر منابع جعلی بالاست، در فصل چهارم خطر خطای عددی و در فصل پنجم خطر تفسیرهای کلی و بی‌پشتوانه.

    یک نکته‌ی ساختاری مهم، انسجام میان فصل‌ها است. متغیرهایی که در فصل اول تعریف می‌کنید، باید در فصل دوم مبنای نظری داشته باشند، در فصل سوم با ابزار مشخصی سنجیده شوند، در فصل چهارم تحلیل شوند و در فصل پنجم تفسیر شوند. هوش مصنوعی در بررسی همین انسجام بسیار توانمند است و می‌تواند ناهماهنگی‌هایی را پیدا کند که شما بعد از ماه‌ها کار روی متن، دیگر نمی‌بینید.

    برای آشنایی بیشتر با الزامات نگارشی و ساختاری، صفحه‌ی نگارش پایان‌نامه ریسرچ اینتل را ببینید که نمونه‌ی ساختارها و شیوه‌نامه‌های رایج را معرفی کرده است.

    در رشته‌هایی که پایان‌نامه به‌صورت «مقاله‌محور» نوشته می‌شود، یعنی چند مقاله‌ی منتشرشده یا آماده‌ی انتشار به‌همراه یک مقدمه و جمع‌بندی کلی، ساختار متفاوت است. در این حالت، نقش هوش مصنوعی بیشتر در هماهنگ‌سازی مقالات، نوشتن فصل مقدمه‌ی جامع و یکدست‌کردن اصطلاحات میان مقالات است. پیش از شروع، با استاد راهنما مشخص کنید که پایان‌نامه‌ی شما سنتی است یا مقاله‌محور، چون این تصمیم روی کل جریان کاری اثر می‌گذارد.

    قوانین دانشگاه، همانندجویی و اخلاق پژوهش

    پیش از استفاده از هر ابزاری، سه منبع قانونی را بررسی کنید: آیین‌نامه‌ی دانشگاه درباره‌ی هوش مصنوعی (اگر وجود دارد)، شیوه‌نامه‌ی نگارش پایان‌نامه‌ی دانشکده و نظر استاد راهنما. بسیاری از دانشگاه‌ها هنوز آیین‌نامه‌ی مستقلی ندارند، اما اصول کلی صداقت علمی و منع سرقت علمی به‌طور کامل شامل استفاده از هوش مصنوعی هم می‌شود.

    در ایران، پایان‌نامه‌ها معمولاً پیش از دفاع در سامانه‌ی همانندجوی ایرانداک بررسی می‌شوند. این سامانه میزان شباهت متن شما با پایان‌نامه‌ها و مقالات موجود را می‌سنجد. نکته‌ی مهم این است که متن تولیدشده با هوش مصنوعی ممکن است در همانندجو شباهت پایینی نشان دهد، اما این به معنای اصیل بودن آن نیست. علاوه بر این، ابزارهای تشخیص متن ماشینی هم روزبه‌روز بیشتر به کار گرفته می‌شوند و برخی داوران و استادان به‌راحتی الگوهای نگارشی ماشینی را تشخیص می‌دهند.

    هدف شما نباید «عبور از همانندجو» باشد، بلکه نوشتن متنی است که واقعاً متعلق به شماست و می‌توانید از تک‌تک جملات آن دفاع کنید.

    اصول اخلاقی پیشنهادی ما برای پایان‌نامه:

    • شفافیت با استاد راهنما: از ابتدا درباره‌ی ابزارهایی که استفاده می‌کنید و نوع استفاده صحبت کنید.
    • مالکیت فکری: ایده‌ها، استدلال‌ها، تفسیرها و نتیجه‌گیری‌ها باید از شما باشد.
    • صحت منابع: هر منبع را خودتان پیدا، بررسی و مطالعه کنید.
    • صداقت در داده: هوش مصنوعی هرگز نباید داده بسازد یا نتایج را تغییر دهد.
    • محرمانگی: داده‌های شرکت‌کنندگان را بی‌نام‌سازی کنید و در ابزارهای عمومی وارد نکنید.
    • اعلام استفاده: اگر دانشگاه یا استاد بخواهد، در مقدمه یا پیوست، ابزارها و نوع استفاده را ذکر کنید.

    استفاده از ابزارهای «بازنویسی خودکار» یا «پارافریز» برای کاهش درصد همانندجویی متن دیگران، نوعی سرقت علمی پنهان است و اگر کشف شود، ممکن است به ابطال مدرک منجر شود. نقل مطالب دیگران باید همیشه با ارجاع صحیح باشد.

    برای مطالعه‌ی بیشتر درباره‌ی چارچوب‌های بین‌المللی، رهنمودهای COPE درباره‌ی نقش هوش مصنوعی در نویسندگی و صفحه‌ی صداقت علمی ریسرچ اینتل را ببینید.

    اگر قصد دارید بخش‌هایی از پایان‌نامه را بعداً به‌صورت مقاله منتشر کنید، باید از همین حالا به قوانین مجلات هم توجه کنید. توصیه‌نامه‌ی ICMJE و سیاست‌های ناشرانی مثل Elsevier و Springer Nature درباره‌ی استفاده از هوش مصنوعی، اعلام شفاف را الزامی می‌دانند. اگر در پایان‌نامه از ابزار استفاده‌ی گسترده کرده باشید و آن را ثبت نکرده باشید، در زمان نوشتن مقاله دچار مشکل می‌شوید. جزئیات نحوه‌ی اعلام را در مقاله‌ی استفاده از ChatGPT در مقاله ببینید.

    راه‌اندازی یک جریان کاری منظم

    یک جریان کاری منظم، تفاوت میان پایان‌نامه‌ای که شش ماه طول می‌کشد و پایان‌نامه‌ای که دو سال در جا می‌زند را رقم می‌زند. پیشنهاد ما برای راه‌اندازی این جریان:

    • پوشه‌بندی: برای هر فصل یک پوشه بسازید و نسخه‌ها را با تاریخ نام‌گذاری کنید (مثلاً «فصل۲-نسخه۳-۱۴۰۵-۰۷-۱۵»).
    • مدیریت منابع: از روز اول Zotero یا Mendeley را نصب کنید و همه‌ی مقالات را با برچسب فصل مربوط ذخیره کنید.
    • دفترچه‌ی هوش مصنوعی: یک فایل جداگانه بسازید و پرامپت‌های مهم، خروجی‌ها و تصمیم‌هایی که بر اساس آن‌ها گرفته‌اید را ثبت کنید.
    • پرامپت مادر: یک متن خلاصه شامل عنوان، سؤالات، متغیرها، روش و سبک نگارش پایان‌نامه بنویسید و در ابتدای هر گفت‌وگوی جدید با ابزار وارد کنید.
    • نوت‌بوک منابع: در NotebookLM یک نوت‌بوک برای مقالات کلیدی پایان‌نامه بسازید تا بتوانید با منابع خودتان گفت‌وگو کنید.
    • جدول هم‌راستایی: جدولی از اهداف، سؤالات، فرضیه‌ها، متغیرها، ابزارها و آزمون‌ها که در طول کار به‌روز می‌شود.

    پرامپت مادر یکی از مؤثرترین ابزارهاست. مدل‌های زبانی در هر گفت‌وگوی جدید، چیزی از پژوهش شما نمی‌دانند و اگر زمینه ندهید، پاسخ‌های کلی می‌دهند. با پرامپت مادر، هر پاسخ دقیقاً با موضوع، متغیرها و سبک شما هماهنگ است.

    برای انتخاب ابزارهای این جریان کاری، مقاله‌ی بهترین هوش مصنوعی برای پژوهش را بخوانید. آموزش گام‌به‌گام ساختن نوت‌بوک منابع را هم در NotebookLM برای پژوهش آورده‌ایم.

    یک توصیه‌ی مهم دیگر درباره‌ی زمان‌بندی: برای هر فصل یک «تاریخ تحویل پیش‌نویس» به استاد راهنما تعیین کنید و آن را جدی بگیرید. هوش مصنوعی می‌تواند به شما کمک کند برنامه‌ی هفتگی بنویسید و کارهای بزرگ را به کارهای کوچک‌تر تقسیم کنید؛ مثلاً «فصل دوم» را به «یافتن بیست مقاله‌ی کلیدی»، «تکمیل ماتریس»، «نوشتن بخش نظریه‌ها» و «نوشتن پیشینه‌ی داخلی» بشکنید. تقسیم کار، یکی از مؤثرترین راه‌ها برای غلبه بر اهمال‌کاری است که بسیاری از دانشجویان پایان‌نامه با آن درگیرند.

    فصل‌های یک تا سه: کلیات، پیشینه و روش

    سه فصل اول پایان‌نامه، معمولاً بر اساس پروپوزال نوشته می‌شوند و در بسیاری از موارد پیش از گردآوری داده تکمیل می‌شوند. این فصل‌ها پایه‌ی استدلالی و روش‌شناختی کل پژوهش هستند. در این بخش، برای هر فصل توضیح می‌دهیم هوش مصنوعی چگونه می‌تواند به گسترش پروپوزال، سازمان‌دهی ادبیات و دقیق‌تر کردن روش کمک کند.

    فصل‌های اول تا سوم در نوشتن پایان‌نامه با هوش مصنوعی
    فصل‌های اول تا سوم در نوشتن پایان‌نامه با هوش مصنوعی

    یک نکته‌ی کاربردی پیش از ورود به فصل‌ها: هر فصل را در یک گفت‌وگوی جداگانه با ابزار کار کنید، اما در ابتدای هر گفت‌وگو پرامپت مادر و خلاصه‌ی فصل‌های قبلی را وارد کنید. این کار از قاطی شدن اطلاعات جلوگیری می‌کند و در عین حال انسجام میان فصل‌ها را حفظ می‌کند. همچنین پس از اتمام هر فصل، از ابزار بخواهید یک خلاصه‌ی یک‌صفحه‌ای از آن تهیه کند؛ این خلاصه‌ها بعدها برای نوشتن چکیده، ارائه‌ی دفاع و استخراج مقاله بسیار کاربردی خواهند بود.

    فصل اول: کلیات پژوهش

    فصل اول در واقع نسخه‌ی گسترش‌یافته و پخته‌تر پروپوزال است. اگر پروپوزال خوبی نوشته باشید، بخش زیادی از فصل اول آماده است. اما معمولاً باید بیان مسئله را عمیق‌تر کنید، اهمیت و ضرورت را با شواهد به‌روزتر تقویت کنید و تعاریف مفهومی و عملیاتی را دقیق‌تر بنویسید.

    هوش مصنوعی در این فصل این کمک‌ها را می‌کند:

    • مقایسه‌ی پروپوزال و فصل اول: «این بیان مسئله‌ی پروپوزال من است. بر اساس بازخورد استاد که گفته شکاف پژوهشی روشن نیست، نقاط ضعف استدلال را نشان بده و پیشنهاد بده کجا شواهد بیشتری لازم است.»
    • تفکیک تعاریف مفهومی و عملیاتی: «برای این متغیرها، تفاوت تعریف مفهومی و عملیاتی را توضیح بده و بررسی کن آیا تعاریف عملیاتی من با ابزار سنجش هم‌خوان است.»
    • بررسی اهداف و سؤالات: «آیا اهداف من مشخص، قابل‌سنجش و با سؤالات هم‌راستا هستند؟»

    یک خطای رایج در فصل اول، «شعارزدگی» است؛ جملاتی مثل «امروزه اهمیت این موضوع بر کسی پوشیده نیست» یا «در عصر حاضر که عصر اطلاعات است». هوش مصنوعی گاهی همین نوع جملات را تولید می‌کند. از ابزار بخواهید جملات کلی و بی‌شاهد را مشخص کند تا آن‌ها را با داده‌های مشخص، آمار و ارجاع واقعی جایگزین کنید.

    نکته‌ی دیگر، تعریف عملیاتی است. تعریف عملیاتی باید دقیقاً بگوید هر متغیر در این پژوهش با چه ابزاری و چگونه سنجیده می‌شود. اگر از پرسشنامه‌ی استاندارد استفاده می‌کنید، نام دقیق، سازنده، تعداد گویه‌ها و طیف پاسخ را ذکر کنید. این اطلاعات را از منبع اصلی پرسشنامه بردارید، نه از پاسخ هوش مصنوعی.

    یک کاربرد مفید دیگر هوش مصنوعی در فصل اول، کمک به نوشتن بخش «نوآوری پژوهش» است. بسیاری از دانشجویان نمی‌دانند نوآوری کار خود را چگونه بیان کنند. از ابزار بخواهید بر اساس شکاف پژوهشی که در بیان مسئله نوشته‌اید، انواع نوآوری ممکن را دسته‌بندی کند: نوآوری در موضوع، در جامعه‌ی آماری، در روش، در ترکیب متغیرها یا در زمینه‌ی فرهنگی. سپس شما تصمیم بگیرید کدام نوع واقعاً در کار شما وجود دارد و آن را بدون اغراق بنویسید. یادتان باشد که ادعای «برای اولین بار در جهان» تقریباً همیشه سؤال‌برانگیز است.

    فصل دوم: مبانی نظری و پیشینه‌ی پژوهش

    فصل دوم معمولاً طولانی‌ترین فصل پایان‌نامه است و همان‌جایی است که بیشترین سوءاستفاده از هوش مصنوعی رخ می‌دهد. دانشجویانی که از ابزار می‌خواهند «مبانی نظری متغیر X را بنویس»، معمولاً متنی کلی، بی‌ارجاع یا با ارجاعات ساختگی دریافت می‌کنند. چنین متنی در جلسه‌ی دفاع به‌راحتی آشکار می‌شود، چون داور با یک سؤال ساده درباره‌ی یکی از منابع، ماجرا را روشن می‌کند.

    روش درست برای نوشتن فصل دوم:

    1. شناسایی نظریه‌های اصلی: از دستیار عمومی بپرسید چه نظریه‌هایی معمولاً برای تبیین رابطه‌ی متغیرهای شما به کار می‌روند. سپس برای هر نظریه، منبع اصلی (کتاب یا مقاله‌ی بنیان‌گذار) را خودتان پیدا کنید.
    2. جست‌وجوی نظام‌مند پیشینه: در Google Scholar، Scopus و پایگاه‌های داخلی مثل SID، Magiran و ایرانداک جست‌وجو کنید. ابزارهایی مثل Elicit و Consensus می‌توانند در یافتن مقالات انگلیسی کمک کنند.
    3. ساختن ماتریس پیشینه: برای هر مطالعه، نویسنده، سال، هدف، روش، نمونه، یافته‌ها و محدودیت‌ها را ثبت کنید.
    4. سنتز با کمک هوش مصنوعی: ماتریس را به ابزار بدهید و بخواهید الگوها، تناقض‌ها و شکاف‌ها را شناسایی کند.
    5. نگارش توسط خودتان: بر اساس سنتز، متن را بنویسید و سپس برای انسجام و روانی از ابزار کمک بگیرید.
    6. جمع‌بندی و مدل مفهومی: در پایان فصل، جمع‌بندی انتقادی بنویسید و مدل مفهومی پژوهش را با استناد به نظریه‌ها ارائه دهید.

    ابزارهای مبتنی بر منبع در این فصل ارزش زیادی دارند. مقایسه‌ی دقیق آن‌ها را در مقایسه Elicit و Consensus و SciSpace بخوانید. برای اصول کلی مرور ادبیات هم صفحه‌ی مرور ادبیات راهنمای جامعی است.

    پیش از قرار دادن هر منبع در فهرست مراجع، آن را در Google Scholar یا سایت ناشر جست‌وجو کنید و DOI را بررسی کنید. یک منبع جعلی در فصل دوم، اعتبار کل پایان‌نامه را زیر سؤال می‌برد.

    یک تکنیک مفید دیگر، استفاده از هوش مصنوعی برای ساختاردهی فصل است. وقتی پنجاه یا صد مطالعه را مرور کرده‌اید، تصمیم‌گیری درباره‌ی ترتیب ارائه دشوار است. می‌توانید ماتریس را به ابزار بدهید و بپرسید: «این مطالعات را بر اساس موضوع، روش یا زمان چگونه دسته‌بندی کنم که روایت منسجم‌تری داشته باشد؟» سپس یکی از پیشنهادها را با نظر استاد انتخاب کنید.

    در نوشتن پیشینه‌ی داخلی، دقت کنید که بسیاری از ابزارهای هوش مصنوعی به پایگاه‌های فارسی دسترسی ندارند. برای این بخش باید مستقیماً در SID، Magiran، نورمگز، ایرانداک و پایگاه‌های دانشگاهی جست‌وجو کنید. سپس می‌توانید PDF مقالات فارسی را در NotebookLM بارگذاری کنید و با آن‌ها گفت‌وگو کنید. برای پیشینه‌ی خارجی هم Google Scholar نقطه‌ی شروع خوبی است و قابلیت «Cited by» آن به شما کمک می‌کند مقالات جدیدتری را پیدا کنید که به مقالات کلیدی ارجاع داده‌اند.

    فصل سوم: روش‌شناسی پژوهش

    فصل سوم فنی‌ترین فصل پایان‌نامه است و دقت در آن حیاتی است. این فصل باید آن‌قدر کامل باشد که پژوهشگر دیگری بتواند پژوهش شما را تکرار کند. اجزای اصلی فصل سوم:

    • نوع پژوهش از نظر هدف (بنیادی، کاربردی، توسعه‌ای) و از نظر روش (توصیفی، همبستگی، آزمایشی، کیفی، ترکیبی)
    • جامعه‌ی آماری، روش نمونه‌گیری و حجم نمونه
    • ابزار گردآوری داده، روایی و پایایی
    • روش اجرا و ملاحظات اخلاقی
    • روش‌ها و نرم‌افزارهای تحلیل داده

    هوش مصنوعی در این فصل نقش «بازبین فنی» دارد. پرامپت‌های مفید:

    • «این طرح پژوهش و سؤالات من است. آیا روش نمونه‌گیری و حجم نمونه برای پاسخ به این سؤالات مناسب است؟ نقاط ضعف را بگو.»
    • «برای سنجش روایی این پرسشنامه، چه روش‌هایی (محتوایی، سازه، همگرا) معمول است و هر کدام چه چیزی را نشان می‌دهد؟»
    • «با توجه به نوع متغیرها و سؤالات، کدام آزمون‌های آماری مناسب‌اند و پیش‌فرض‌های هر کدام چیست؟»

    اما چند هشدار جدی: پاسخ هوش مصنوعی درباره‌ی ضریب پایایی پرسشنامه‌ها، تعداد گویه‌ها یا روایی گزارش‌شده در مطالعات قبلی ممکن است نادرست باشد. این اطلاعات را همیشه از منبع اصلی بردارید. همچنین برای محاسبه‌ی حجم نمونه، از ابزارهای معتبر مثل G*Power یا فرمول کوکران با پارامترهای واقعی استفاده کنید.

    اگر روش شما کیفی است، هوش مصنوعی می‌تواند در طراحی راهنمای مصاحبه، توضیح رویکردهای تحلیل مضمون یا نظریه‌ی داده‌بنیاد و بررسی معیارهای اعتبار کیفی (مثل معیارهای لینکلن و گوبا) کمک کند. برای انتخاب و اجرای روش‌های آماری، صفحه‌ی تحلیل آماری ریسرچ اینتل و مشاوره با متخصص آمار را پیشنهاد می‌کنیم.

    بخش ملاحظات اخلاقی فصل سوم را هم دست‌کم نگیرید. اگر پژوهش شما با انسان سروکار دارد، باید کد اخلاق از کمیته‌ی اخلاق دانشگاه دریافت کرده باشید و در این بخش ذکر کنید. همچنین نحوه‌ی کسب رضایت آگاهانه، حفظ محرمانگی، حق انصراف شرکت‌کنندگان و شیوه‌ی نگهداری داده‌ها را توضیح دهید. هوش مصنوعی می‌تواند فهرستی از ملاحظات اخلاقی رایج برای نوع پژوهش شما ارائه دهد تا چیزی از قلم نیفتد، اما متن نهایی باید با واقعیت اجرای پژوهش شما مطابق باشد. اگر از ابزار هوش مصنوعی در تحلیل داده‌ها استفاده می‌کنید، این را هم در همین بخش ذکر کنید.

    همچنین فراموش نکنید که فصل سوم باید محدودیت‌های روش‌شناختی را هم صادقانه منعکس کند؛ مثلاً اگر نمونه‌گیری در دسترس بوده یا داده‌ها خودگزارشی هستند، این موضوع در فصل پنجم و در بخش محدودیت‌ها هم باید تکرار شود.

    مطالعهٔ تکمیلی: اگر می‌خواهید این موضوع را عمیق‌تر و بر پایهٔ یک منبع معتبر دانشگاهی دنبال کنید، راهنماهای طراحی پژوهش با هوش مصنوعی، تحلیل داده با هوش مصنوعی و ویرایش مقاله با هوش مصنوعی را هم در ریسرچ اینتل بخوانید.

    فصل‌های چهار و پنج و نهایی‌سازی پایان‌نامه

    پس از گردآوری داده‌ها، نوبت به دو فصل پایانی می‌رسد که نتیجه‌ی ماه‌ها کار شما را نشان می‌دهند. فصل چهارم باید یافته‌ها را دقیق و بی‌طرفانه گزارش کند و فصل پنجم باید آن‌ها را عمیق و انتقادی تفسیر کند. در نهایت، چکیده، ویرایش نهایی و آمادگی برای دفاع، آخرین مراحل این مسیر هستند.

    فصل یافته‌ها، بحث و دفاع در نوشتن پایان‌نامه با هوش مصنوعی
    فصل یافته‌ها، بحث و دفاع در نوشتن پایان‌نامه با هوش مصنوعی

    یکی از مفیدترین کارها در پایان سه فصل اول، تهیه‌ی «نسخه‌ی پیش از گردآوری داده» برای استاد راهنماست. این نسخه شامل فصل‌های اول تا سوم به‌همراه ابزار نهایی گردآوری داده است. تأیید استاد در این مرحله، از اصلاحات پرهزینه پس از گردآوری داده جلوگیری می‌کند. پیش از ارسال، از هوش مصنوعی بخواهید این سه فصل را از نظر هم‌خوانی متغیرها، تعاریف و ابزارها بررسی کند و هر ناهماهنگی را با ذکر شماره‌ی صفحه یا بخش گزارش دهد.

    فصل چهارم: تجزیه و تحلیل داده‌ها

    فصل چهارم، فصل «اعداد و واقعیت‌ها» است. اینجا شما یافته‌ها را بدون تفسیر و به ترتیب سؤالات یا فرضیه‌ها گزارش می‌کنید. ساختار رایج این فصل:

    1. آمار توصیفی ویژگی‌های جمعیت‌شناختی نمونه
    2. آمار توصیفی متغیرهای اصلی (میانگین، انحراف معیار، چولگی، کشیدگی)
    3. بررسی پیش‌فرض‌های آزمون‌ها (نرمال بودن، همگنی واریانس و…)
    4. آزمون فرضیه‌ها یا پاسخ به سؤالات، یکی‌یکی
    5. جمع‌بندی یافته‌ها

    هوش مصنوعی در این فصل می‌تواند به فهم و تفسیر خروجی نرم‌افزار کمک کند. مثلاً می‌توانید جدول خروجی SPSS را (بدون داده‌های هویتی) به ابزار بدهید و بپرسید: «این جدول رگرسیون را توضیح بده؛ کدام مقادیر را باید گزارش کنم و چگونه؟» سپس با کمک این توضیح، متن گزارش را خودتان بنویسید.

    همه‌ی اعدادی که در متن فصل چهارم می‌آیند، باید دقیقاً با خروجی نرم‌افزار مطابقت داشته باشند. هوش مصنوعی گاهی در بازنویسی اعداد را گرد یا جابه‌جا می‌کند. هر عدد را دو بار با خروجی اصلی تطبیق دهید و هرگز از ابزار نخواهید نتیجه‌ای «معنادار» بسازد.

    آموزش کامل این فرایند را در مقاله‌ی تحلیل SPSS با ChatGPT آورده‌ایم که شامل پرامپت‌ها، نمونه‌ی گزارش‌دهی به سبک APA و خطاهای رایج است. برای قالب‌بندی جدول‌ها و گزارش آماری، راهنمای سبک APA منبع معتبری است.

    یک نکته‌ی مهم دیگر: اگر فرضیه‌ای تأیید نشد، آن را پنهان نکنید و سعی نکنید با تغییر آزمون یا حذف داده‌ها نتیجه را عوض کنید. نتایج معنادار نشده هم یافته‌ی علمی هستند و در فصل پنجم می‌توانید آن‌ها را تبیین کنید.

    برای پژوهش‌های کیفی، فصل چهارم ساختار متفاوتی دارد و معمولاً شامل مضامین اصلی، زیرمضامین و نقل‌قول‌های منتخب از مشارکت‌کنندگان است. هوش مصنوعی می‌تواند در سازمان‌دهی کدها و پیشنهاد دسته‌بندی‌های اولیه کمک کند، اما کدگذاری و تفسیر باید توسط خود پژوهشگر انجام شود، چون فهم زمینه و معنای عمیق گفته‌ها نیازمند حضور پژوهشگر در میدان است. همچنین هرگز متن کامل مصاحبه‌ها را بدون بی‌نام‌سازی در ابزارهای عمومی وارد نکنید و پیش از هر استفاده، با رضایت‌نامه‌ای که شرکت‌کنندگان امضا کرده‌اند تطبیق دهید.

    فصل پنجم: بحث، نتیجه‌گیری و پیشنهادها

    فصل پنجم جایی است که داوران بیشترین توجه را به آن دارند، چون عمق فهم شما از پژوهش را نشان می‌دهد. ساختار پیشنهادی:

    • خلاصه‌ی پژوهش: یک مرور کوتاه از مسئله، روش و یافته‌ها.
    • بحث درباره‌ی هر فرضیه یا سؤال: یافته را بیان کنید، با مطالعات قبلی (هم‌سو و ناهم‌سو) مقایسه کنید و تبیین نظری ارائه دهید.
    • نتیجه‌گیری کلی: پاسخ نهایی به مسئله‌ی پژوهش.
    • محدودیت‌ها: محدودیت‌های در اختیار و خارج از اختیار پژوهشگر.
    • پیشنهادها: پیشنهادهای کاربردی بر اساس یافته‌ها و پیشنهادهای پژوهشی برای آینده.

    هوش مصنوعی در فصل پنجم می‌تواند تبیین‌های جایگزین پیشنهاد دهد. برای مثال: «یافته‌ی من نشان داد حمایت سازمانی اثر معناداری بر رضایت شغلی ندارد، در حالی که سه مطالعه‌ی قبلی اثر مثبت گزارش کرده بودند. چه تبیین‌های نظری، زمینه‌ای و روش‌شناختی برای این تفاوت ممکن است؟» سپس شما باید این تبیین‌ها را با پیشینه و زمینه‌ی واقعی پژوهش بسنجید.

    یک خطای رایج، پیشنهادهای کلیشه‌ای است؛ مثل «پیشنهاد می‌شود مدیران به این موضوع توجه بیشتری کنند». پیشنهادهای کاربردی باید مستقیماً از یافته‌ها بیایند و مشخص باشند: چه کسی، چه کاری، بر اساس کدام یافته. از هوش مصنوعی بخواهید پیشنهادهای شما را نقد کند و بگوید کدام کلی و کدام مشخص است.

    برای هر بند بحث، از قاعده‌ی «یافته، مقایسه، تبیین، پیامد» استفاده کنید. این ساختار چهارمرحله‌ای، بحث شما را منسجم و قابل‌دفاع می‌کند و هوش مصنوعی هم می‌تواند بررسی کند که هر چهار جزء در هر بند حضور دارند.

    یکی دیگر از کاربردهای ارزشمند هوش مصنوعی در فصل پنجم، بررسی پیوستگی میان فصل‌ها است. خلاصه‌ی فصل اول (اهداف و سؤالات) و خلاصه‌ی فصل پنجم (نتیجه‌گیری‌ها) را به ابزار بدهید و بپرسید: «آیا به همه‌ی سؤالات پژوهش در نتیجه‌گیری پاسخ داده شده است؟ آیا نتیجه‌ای وجود دارد که به هیچ سؤالی مربوط نیست؟» این بررسی ساده اغلب نکاتی را آشکار می‌کند که داوران حتماً به آن‌ها اشاره می‌کنند. در کنار آن، از ابزار بخواهید محدودیت‌های احتمالی را که ذکر نکرده‌اید فهرست کند.

    چکیده، ویرایش نهایی و آمادگی برای دفاع

    پس از تکمیل پنج فصل، چند کار نهایی باقی می‌ماند:

    چکیده‌ی فارسی و انگلیسی: چکیده باید هدف، روش، یافته‌های اصلی و نتیجه‌گیری را در حدود ۲۵۰ تا ۳۵۰ کلمه بیان کند. ابتدا خودتان پیش‌نویس بنویسید و سپس از هوش مصنوعی بخواهید بررسی کند آیا همه‌ی اجزا حضور دارند و آیا ادعایی فراتر از یافته‌ها وجود دارد. برای چکیده‌ی انگلیسی، ابزار می‌تواند در ویرایش زبانی بسیار مفید باشد.

    ویرایش نهایی: کل پایان‌نامه را از نظر یکدستی اصطلاحات، رعایت شیوه‌نامه، شماره‌گذاری جدول‌ها و شکل‌ها، ارجاع‌دهی درون‌متنی و فهرست منابع بازبینی کنید. هوش مصنوعی می‌تواند ناهماهنگی‌ها را پیدا کند؛ مثلاً اگر یک متغیر در فصل اول «تعهد سازمانی» و در فصل چهارم «وفاداری سازمانی» نامیده شده باشد. ویرایش فصل‌به‌فصل، کنترل بیشتری می‌دهد تا بارگذاری یک‌جای کل متن.

    آمادگی برای دفاع: یکی از بهترین کاربردهای هوش مصنوعی، شبیه‌سازی جلسه‌ی دفاع است. پرامپت پیشنهادی: «تو داور خارجی جلسه‌ی دفاع هستی. بر اساس این خلاصه‌ی پایان‌نامه، پانزده سؤال چالشی درباره‌ی مسئله، روش، یافته‌ها و محدودیت‌ها بپرس.» به سؤال‌ها بدون کمک ابزار پاسخ دهید و پاسخ‌ها را با استاد راهنما مرور کنید. همچنین ارائه‌ی بیست‌دقیقه‌ای خود را با اسلایدهای ساده و متکی به داده آماده کنید.

    پس از دفاع، قدم بعدی معمولاً استخراج مقاله است. راهنمای کامل این کار را در استخراج مقاله از پایان‌نامه آورده‌ایم و برای آشنایی با فرایند انتشار، صفحه‌ی انتشار مقاله را ببینید.

    پس از دفاع هم کار تمام نمی‌شود. اصلاحات پیشنهادی داوران را دقیق یادداشت کنید و با کمک فهرست‌بندی منظم، آن‌ها را یکی‌یکی اعمال کنید. هوش مصنوعی می‌تواند در دسته‌بندی اصلاحات و پیشنهاد ترتیب انجام آن‌ها کمک کند. همچنین در این مرحله، پروفایل پژوهشی خود را تکمیل کنید: یک شناسه‌ی ORCID بسازید، پروفایل Google Scholar راه‌اندازی کنید و اگر قصد اپلای دارید، رزومه‌ی آکادمیک خود را با عنوان پایان‌نامه و مقالات استخراج‌شده به‌روز کنید؛ صفحه‌ی رزومه دکتری نکات مفیدی در این زمینه دارد. برای آشنایی با جایگاه کلی هوش مصنوعی در پژوهش، صفحه‌ی هوش مصنوعی در پژوهش و رویدادهای هفته پژوهش را هم دنبال کنید.

    جمع‌بندی: نوشتن پایان‌نامه با هوش مصنوعی وقتی موفق است که ابزار در هر فصل نقش مناسب خودش را داشته باشد: در فصل اول منتقد استدلال، در فصل دوم دستیار سنتز (نه تولیدکننده‌ی منبع)، در فصل سوم بازبین فنی، در فصل چهارم مفسر خروجی (نه سازنده‌ی عدد) و در فصل پنجم هم‌فکر تبیین. شما نویسنده، تحلیلگر و مدافع پایان‌نامه هستید. اگر در هر مرحله به همراهی تخصصی نیاز داشتید، مشاوره پژوهشی ریسرچ اینتل، دوره مقاله‌نویسی با هوش مصنوعی و بانک پرامپت‌های پژوهشی در کنار شما هستند.

    برای آموزش‌ها و مشاوره‌های بیشتر پژوهشی به هوش پژوهشی سر بزنید.
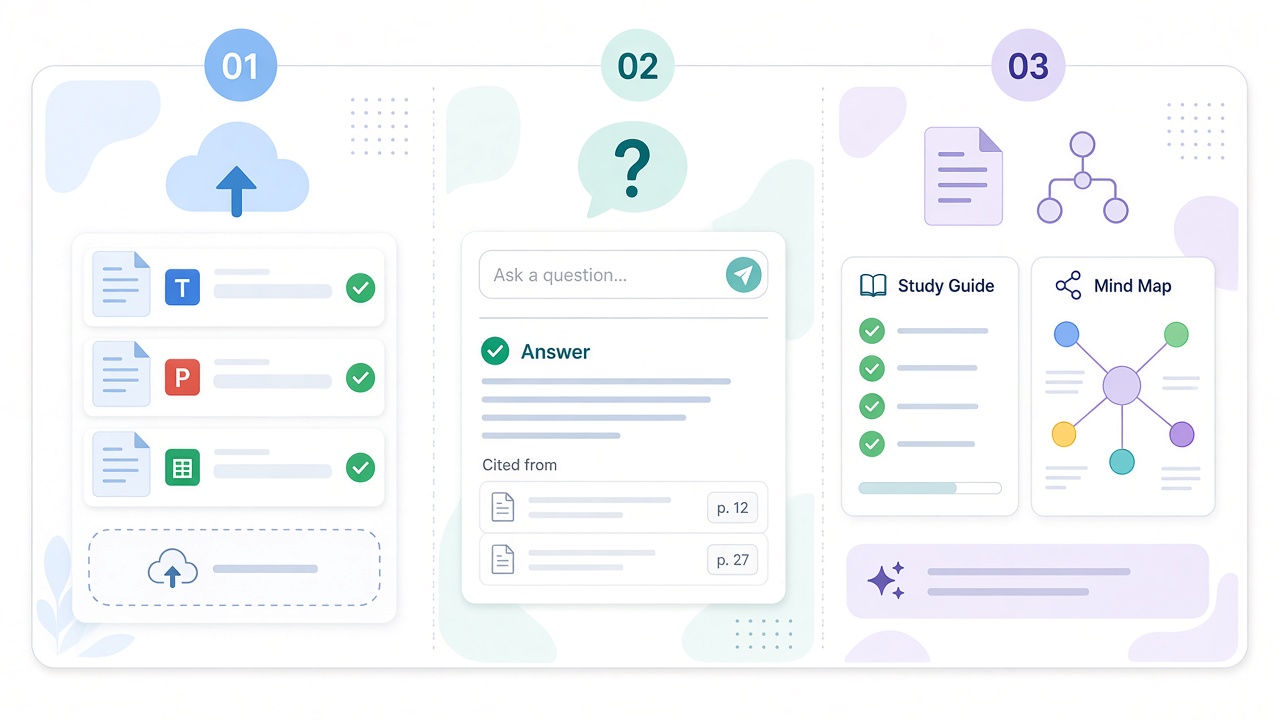
  • بهترین هوش مصنوعی برای پژوهش و مقاله‌نویسی (مقایسه ۱۴۰۵)

    بهترین هوش مصنوعی برای پژوهش و مقاله‌نویسی (مقایسه ۱۴۰۵)

    بهترین هوش مصنوعی برای پژوهش کدام است؟ این سؤالی است که تقریباً هر هفته از دانشجویان و پژوهشگران می‌شنویم. پاسخ کوتاه این است: «بستگی دارد». اما این پاسخ کوتاه به کار کسی نمی‌آید. در واقع، هیچ ابزار واحدی وجود ندارد که در همه‌ی مراحل پژوهش، از جست‌وجوی منابع تا تحلیل داده و ویرایش انگلیسی، بهترین باشد. هر ابزار در کاری مشخص قوی‌تر است و در کار دیگری ضعیف‌تر.

    در سال‌های اخیر، تعداد ابزارهای هوش مصنوعی پژوهشی به‌سرعت افزایش یافته است. از دستیارهای گفت‌وگومحور عمومی مثل ChatGPT، Claude، Gemini و Grok گرفته تا ابزارهای تخصصی مانند Elicit، Consensus، SciSpace، Scite، ResearchRabbit و NotebookLM. هر کدام ادعا می‌کنند که پژوهش را سریع‌تر و آسان‌تر می‌کنند. اما برای یک دانشجوی ارشد یا دکتری که وقت و بودجه‌ی محدودی دارد، سؤال واقعی این است: کدام ابزار برای کدام کار، با چه دقتی و با چه ریسکی؟

    در این مقاله، یک مقایسه‌ی کاربردی و به‌روز برای سال ۱۴۰۵ ارائه می‌دهیم. به‌جای فهرست کردن ده‌ها ابزار، ابتدا معیارهای انتخاب را توضیح می‌دهیم، سپس ابزارهای اصلی را بر اساس نوع کار دسته‌بندی و مقایسه می‌کنیم و در نهایت، یک جعبه‌ابزار پیشنهادی برای هر مرحله‌ی پژوهش و هر سطح تحصیلی معرفی می‌کنیم. هدف این است که پس از خواندن این مطلب، بدانید دقیقاً چه ابزاری را برای چه کاری باز کنید.

    قابلیت‌ها، قیمت‌ها و شرایط دسترسی ابزارهای هوش مصنوعی به‌سرعت تغییر می‌کنند. این مقایسه بر اساس کاربرد و منطق انتخاب نوشته شده است، نه جزئیات لحظه‌ای. پیش از تصمیم‌گیری، صفحه‌ی رسمی هر ابزار را بررسی کنید.

    پیش از شروع، یک نکته‌ی بنیادین را یادآوری کنیم: ابزار خوب، پژوهشگر خوب نمی‌سازد؛ بلکه پژوهشگر خوب را سریع‌تر و دقیق‌تر می‌کند. اگر مهارت‌های پایه‌ای مثل طرح سؤال پژوهش، خواندن انتقادی مقاله و استدلال علمی را نداشته باشید، هیچ ابزاری جای آن‌ها را پر نمی‌کند. برعکس، پژوهشگری که این مهارت‌ها را دارد، با کمک ابزارهای مناسب می‌تواند کاری را که قبلاً چند ماه طول می‌کشید، در چند هفته انجام دهد. پس این مقایسه را با این نگاه بخوانید که کدام ابزار به «توانمندتر شدن» شما کمک می‌کند، نه کدام ابزار «به‌جای» شما کار می‌کند.

    معیارهای انتخاب بهترین هوش مصنوعی برای پژوهش

    پیش از اینکه سراغ نام ابزارها برویم، باید بدانیم با چه معیاری آن‌ها را ارزیابی می‌کنیم. بسیاری از مقایسه‌هایی که در شبکه‌های اجتماعی می‌بینید، بر «جذابیت» یا «سرعت» تمرکز دارند؛ اما در پژوهش، معیارهای دیگری اهمیت بیشتری دارند. دقت علمی، قابلیت استناد، حفظ حریم خصوصی داده‌ها، دسترسی پایدار و هزینه‌ی معقول، پنج معیار کلیدی هستند که در این بخش آن‌ها را در سه دسته بررسی می‌کنیم.

    معیارهای انتخاب بهترین هوش مصنوعی برای پژوهش
    معیارهای انتخاب بهترین هوش مصنوعی برای پژوهش

    دقت، استناد و مقابله با توهم

    مهم‌ترین معیار در انتخاب ابزار پژوهشی، دقت است. مدل‌های زبانی بزرگ به‌طور ذاتی برای تولید متن روان طراحی شده‌اند، نه برای بیان حقیقت. به همین دلیل ممکن است با اطمینان کامل اطلاعاتی بگویند که نادرست است یا منبعی معرفی کنند که وجود ندارد. این پدیده را «توهم» یا Hallucination می‌نامند و در پژوهش، خطرناک‌ترین ضعف ابزارهای هوش مصنوعی است.

    ابزارها از این نظر به دو گروه کلی تقسیم می‌شوند:

    • ابزارهای مولد عمومی: مثل ChatGPT، Claude، Gemini و Grok در حالت پایه. این ابزارها از دانش درون مدل پاسخ می‌دهند و ممکن است منبع بسازند. البته بسیاری از آن‌ها اکنون قابلیت جست‌وجوی وب دارند که این خطر را کمتر می‌کند، اما از بین نمی‌برد.
    • ابزارهای مبتنی بر بازیابی (RAG): مثل Elicit، Consensus، SciSpace، Scite و NotebookLM. این ابزارها ابتدا مقالات یا اسناد واقعی را بازیابی می‌کنند و سپس پاسخ را بر اساس آن‌ها می‌سازند و لینک منبع را نشان می‌دهند.

    برای کارهایی که به استناد نیاز دارند، مانند نوشتن پیشینه یا یافتن شواهد برای یک ادعا، همیشه ابزارهای گروه دوم را ترجیح دهید. اما حتی در این ابزارها هم ممکن است خلاصه‌ی یک مقاله نادقیق باشد یا یافته‌ای از زمینه‌اش جدا شود. بنابراین قاعده‌ی کلی این است:

    هر ادعایی که در متن پژوهشی شما قرار می‌گیرد، باید به مقاله‌ای برسد که خودتان دست‌کم چکیده و بخش مرتبط آن را خوانده‌اید.

    یک آزمون ساده برای سنجش دقت هر ابزار این است که سؤالی بپرسید که پاسخ آن را در حوزه‌ی تخصصی خودتان دقیق می‌دانید. مثلاً بپرسید «مطالعات اصلی درباره‌ی رابطه‌ی X و Y در پنج سال اخیر چه یافته‌هایی داشته‌اند؟» و پاسخ را با دانش خودتان مقایسه کنید. این آزمون در ده دقیقه به شما نشان می‌دهد چقدر می‌توانید به یک ابزار اعتماد کنید.

    برای بررسی اصالت منابع پیشنهادی، Google Scholar و جست‌وجوی DOI در سایت Crossref ساده‌ترین روش‌ها هستند. اگر منبعی در هیچ‌کدام پیدا نشد، به احتمال زیاد ساختگی است.

    یک معیار فرعی اما مهم در همین دسته، شفافیت منبع است. ابزاری که فقط یک پاسخ کلی می‌دهد و نمی‌گوید از کجا آمده، حتی اگر درست باشد، برای پژوهش ارزش محدودی دارد؛ چون شما نمی‌توانید آن را در متن خود ارجاع دهید. ابزارهایی که لینک مستقیم به مقاله، شماره‌ی صفحه یا جمله‌ی دقیق منبع را نشان می‌دهند، بسیار ارزشمندترند. هنگام مقایسه، ببینید هر ابزار چقدر راحت به شما اجازه می‌دهد از پاسخ به منبع اصلی برسید و آن را بررسی کنید. هرچه این مسیر کوتاه‌تر باشد، ابزار برای کار پژوهشی مناسب‌تر است.

    حریم خصوصی، محرمانگی و دسترسی از ایران

    معیار دوم که اغلب نادیده گرفته می‌شود، حریم خصوصی است. وقتی پیش‌نویس مقاله، داده‌های پژوهشی یا متن پرسشنامه‌ها را در یک ابزار بارگذاری می‌کنید، این اطلاعات به سرورهای شرکت ارائه‌دهنده منتقل می‌شود. برخی ابزارها به‌طور پیش‌فرض از گفت‌وگوها برای آموزش مدل‌های بعدی استفاده می‌کنند، مگر اینکه این گزینه را غیرفعال کنید.

    چند پرسش که پیش از استفاده باید پاسخ دهید:

    1. آیا ابزار گزینه‌ای برای غیرفعال‌کردن استفاده از داده‌ها در آموزش مدل دارد؟
    2. فایل‌های بارگذاری‌شده چه مدت نگهداری می‌شوند؟
    3. آیا داده‌های من شامل اطلاعات هویتی شرکت‌کنندگان یا اطلاعات محرمانه‌ی سازمانی است؟
    4. آیا دانشگاه یا کمیته‌ی اخلاق، محدودیتی برای انتقال داده به سرویس‌های خارجی تعیین کرده است؟

    هرگز داده‌های خام شامل نام، کد ملی، شماره‌ی پرونده یا هر اطلاعات هویتی شرکت‌کنندگان را در ابزارهای عمومی وارد نکنید. این کار ممکن است با تعهدات اخلاقی پژوهش و رضایت‌نامه‌ای که شرکت‌کنندگان امضا کرده‌اند در تعارض باشد. پیش از هر تحلیل، داده‌ها را بی‌نام‌سازی کنید.

    موضوع دیگری که برای پژوهشگران ایرانی اهمیت عملی دارد، دسترسی پایدار است. برخی ابزارها برای کاربران ایرانی محدودیت دارند یا پرداخت اشتراک آن‌ها دشوار است. پیش از اینکه کل جریان کاری خود را روی یک ابزار بنا کنید، مطمئن شوید که دسترسی شما پایدار است و در میانه‌ی نگارش پایان‌نامه با قطع ناگهانی روبه‌رو نمی‌شوید. صفحه‌ی خرید اکانت هوش مصنوعی ریسرچ اینتل اطلاعاتی درباره‌ی گزینه‌های دسترسی ارائه می‌دهد. همچنین همیشه یک نسخه‌ی پشتیبان از یادداشت‌ها، ماتریس‌های مرور و پیش‌نویس‌ها را خارج از ابزار نگه دارید.

    در کنار این‌ها، سیاست‌های دانشگاه را هم در نظر بگیرید. برخی دانشگاه‌های داخلی و خارجی، فهرستی از ابزارهای مجاز یا توصیه‌شده منتشر کرده‌اند یا اشتراک سازمانی برخی ابزارها را در اختیار دانشجویان قرار می‌دهند. اگر دانشگاه شما چنین امکانی دارد، استفاده از آن معمولاً هم از نظر حریم خصوصی و هم از نظر هزینه به‌صرفه‌تر است. همچنین اگر قصد دارید داده‌های بیمارستانی یا سازمانی را تحلیل کنید، پیش از هر کاری با کمیته‌ی اخلاق یا واحد پژوهش آن سازمان هماهنگ کنید.

    هزینه، زبان فارسی و منحنی یادگیری

    معیار سوم، هزینه و بازده است. بیشتر ابزارها یک نسخه‌ی رایگان با محدودیت و یک نسخه‌ی پولی با امکانات بیشتر دارند. محدودیت‌های رایج نسخه‌های رایگان عبارت‌اند از: تعداد پیام یا جست‌وجوی محدود در روز، دسترسی به مدل‌های ضعیف‌تر، محدودیت در حجم یا تعداد فایل‌های بارگذاری‌شده و نبود امکان خروجی گرفتن.

    برای اینکه هزینه را بهینه کنید، از خودتان بپرسید کدام کار را بیشتر انجام می‌دهید. اگر بیشتر وقت شما صرف خواندن و خلاصه‌کردن مقاله می‌شود، اشتراک یک ابزار مبتنی بر منبع ارزشمندتر است. اگر بیشتر نگران ویرایش انگلیسی هستید، یک دستیار عمومی قوی یا ابزار ویرایش آکادمیک کفایت می‌کند. معمولاً لازم نیست هم‌زمان برای چند ابزار پولی هزینه کنید.

    پشتیبانی از زبان فارسی هم برای بسیاری از کاربران مهم است. دستیارهای عمومی بزرگ معمولاً فارسی را به‌خوبی می‌فهمند و تولید می‌کنند، هرچند کیفیت نگارش آکادمیک فارسی آن‌ها همیشه یکسان نیست و گاهی ساختارهای ترجمه‌ای یا واژه‌های نامأنوس به کار می‌برند. ابزارهای تخصصی جست‌وجوی مقاله اما عمدتاً روی مقالات انگلیسی‌زبان کار می‌کنند و پایگاه‌های فارسی مانند SID، Magiran و نورمگز را پوشش نمی‌دهند. بنابراین برای پیشینه‌ی داخلی، همچنان باید مستقیماً در پایگاه‌های داخلی جست‌وجو کنید.

    منحنی یادگیری آخرین معیار این دسته است. برخی ابزارها مثل Consensus بسیار ساده‌اند و در چند دقیقه می‌توان با آن‌ها کار کرد. برخی دیگر مثل Elicit یا ابزارهای نقشه‌ی استنادی، برای بهره‌برداری کامل نیاز به تمرین دارند. اگر زمان محدودی دارید، با یک یا دو ابزار شروع کنید و آن‌ها را عمیق یاد بگیرید، به‌جای اینکه ده ابزار را سطحی امتحان کنید.

    یک روش منطقی برای شروع: یک هفته فقط از یک دستیار عمومی و یک ابزار مبتنی بر منبع استفاده کنید و یادداشت کنید هر کدام در چه کارهایی وقت شما را صرفه‌جویی کرد و کجا خطا داشت. این تجربه‌ی شخصی، از هر مقایسه‌ی عمومی‌ای ارزشمندتر است.

    یک توصیه‌ی دیگر برای کاربران فارسی‌زبان: وقتی با ابزارهای انگلیسی‌محور کار می‌کنید، سؤال‌های خود را به انگلیسی و با اصطلاحات تخصصی دقیق بپرسید. کیفیت نتایج جست‌وجو و خلاصه‌ها در این حالت معمولاً به‌مراتب بهتر است. سپس اگر لازم بود، از یک دستیار عمومی بخواهید خلاصه را برای یادداشت‌برداری به فارسی برگرداند. این «دوزبانه کار کردن» یکی از مهارت‌های ارزشمند پژوهشگران ایرانی در عصر هوش مصنوعی است و به تقویت واژگان تخصصی انگلیسی شما هم کمک می‌کند.

    مقایسه‌ی ابزارهای هوش مصنوعی پژوهشی بر اساس کاربرد

    اکنون که معیارها روشن شد، ابزارها را در سه گروه اصلی مقایسه می‌کنیم: دستیارهای گفت‌وگومحور عمومی، ابزارهای جست‌وجو و مرور ادبیات، و ابزارهای نگارش، ویرایش و مدیریت منابع. این دسته‌بندی کمک می‌کند به‌جای مقایسه‌ی ابزارهایی که اصلاً برای یک کار ساخته نشده‌اند، هر ابزار را با رقبای واقعی‌اش بسنجید.

    دسته‌بندی ابزارها برای انتخاب بهترین هوش مصنوعی برای پژوهش
    دسته‌بندی ابزارها برای انتخاب بهترین هوش مصنوعی برای پژوهش

    دستیارهای عمومی: ChatGPT، Claude، Gemini و Grok

    دستیارهای گفت‌وگومحور عمومی، چاقوی سوئیسی پژوهشگران هستند. تقریباً هر کاری را تا حدی انجام می‌دهند: ایده‌پردازی، توضیح مفاهیم، نوشتن پیش‌نویس، ویرایش زبانی، کمک در کدنویسی تحلیل داده و شبیه‌سازی داور. تفاوت آن‌ها بیشتر در جزئیات است:

    • ChatGPT: پرکاربردترین دستیار با اکوسیستم گسترده؛ در ویرایش زبانی، توضیح مفاهیم آماری و کمک به تحلیل داده با قابلیت اجرای کد عملکرد خوبی دارد. نسخه‌های پیشرفته امکان بارگذاری فایل و جست‌وجوی وب دارند.
    • Claude: به‌خاطر پنجره‌ی متنی بلند و توانایی خوب در کار با اسناد طولانی، برای بازخورد بر فصل‌های کامل پایان‌نامه و ویرایش متن‌های بلند محبوب است. لحن نگارشی آن معمولاً طبیعی‌تر ارزیابی می‌شود.
    • Gemini: با اکوسیستم گوگل یکپارچه است و برای کاربرانی که با Google Docs و Drive کار می‌کنند راحت است. قابلیت‌های چندرسانه‌ای و جست‌وجوی وب آن نیز کاربردی است.
    • Grok: دستیاری با دسترسی به اطلاعات به‌روز وب و شبکه‌ی X که برای پیگیری بحث‌های تازه‌ی علمی و ایده‌پردازی سریع می‌تواند مفید باشد؛ مانند بقیه، ادعاها و منابع آن باید بررسی شود.
    کاربرد دستیار عمومی ابزار مبتنی بر منبع
    ایده‌پردازی و طوفان فکری بسیار مناسب محدود
    یافتن مقالات واقعی پرریسک بدون جست‌وجوی وب بسیار مناسب
    ویرایش زبانی بسیار مناسب محدود
    خلاصه‌ی PDF خودتان مناسب بسیار مناسب
    توضیح آزمون آماری مناسب با بررسی محدود

    نکته‌ی مهم این است که کیفیت این دستیارها بیش از هر چیز به کیفیت پرامپت بستگی دارد. تفاوت میان دو دستیار برتر، معمولاً کمتر از تفاوت میان یک پرامپت ضعیف و یک پرامپت قوی است. اگر می‌خواهید از هر دستیاری بیشترین بهره را ببرید، بانک پرامپت‌های پژوهشی ریسرچ اینتل نقطه‌ی شروع خوبی است.

    دستیارهای عمومی در «خلق دانش» ضعیف‌اند. نباید از آن‌ها انتظار داشته باشید که شکاف پژوهشی واقعی را کشف کنند، داده‌ی شما را بدون دیدن تفسیر کنند یا منابع قطعی معرفی کنند. کاربرد درست آن‌ها را در مقاله‌ی مقاله‌نویسی علمی با هوش مصنوعی شرح داده‌ایم.

    یک تمرین ساده برای انتخاب میان دستیارهای عمومی این است که یک کار واقعی از پژوهش خودتان را در دو یا سه دستیار هم‌زمان امتحان کنید. مثلاً یک پاراگراف از بیان مسئله را بدهید و بخواهید آن را نقد کنند. خروجی‌ها را کنار هم بگذارید و ببینید کدام نقد عمیق‌تر، دقیق‌تر و کاربردی‌تر است. این مقایسه‌ی شخصی در حوزه‌ی تخصصی شما، از هر رتبه‌بندی عمومی معتبرتر است، چون عملکرد ابزارها در رشته‌های مختلف یکسان نیست. نتیجه‌ی این آزمون را یادداشت کنید تا در ماه‌های بعد، با به‌روزرسانی مدل‌ها، دوباره مقایسه کنید.

    ابزارهای جست‌وجو و مرور ادبیات: Elicit، Consensus، SciSpace و دیگران

    این گروه، ابزارهایی هستند که مستقیماً با پایگاه‌های مقالات علمی کار می‌کنند و برای مرحله‌ی مرور ادبیات طراحی شده‌اند:

    • Elicit: برای پرسیدن سؤال پژوهشی و دریافت فهرستی از مقالات مرتبط با استخراج خودکار اطلاعاتی مثل روش، نمونه و یافته‌ها در قالب جدول. برای ساختن ماتریس مرور ادبیات بسیار کاربردی است.
    • Consensus: برای پاسخ‌های سریع و مبتنی بر شواهد به سؤالات بله/خیر یا سؤالات اثرگذاری. خلاصه‌ای از جهت کلی شواهد نشان می‌دهد و ابزار مناسبی برای شروع سریع است.
    • SciSpace: ترکیبی از جست‌وجو و «گفت‌وگو با PDF»؛ می‌توانید مقاله‌ای را باز کنید و درباره‌ی بخش‌های پیچیده‌ی آن، مثل فرمول‌ها یا جدول‌ها، سؤال بپرسید.
    • Scite: نشان می‌دهد یک مقاله در مطالعات بعدی چگونه ارجاع داده شده است؛ آیا یافته‌هایش تأیید شده، نقد شده یا فقط ذکر شده است. برای ارزیابی اعتبار ادعاها ارزشمند است.
    • ResearchRabbit و Connected Papers: نقشه‌ی بصری ارتباط مقالات را می‌سازند و برای کشف مقالات کلیدی و دیدن خوشه‌های پژوهشی یک حوزه مفیدند.
    • Perplexity: موتور پاسخ با ارجاع به منابع وب و حالت آکادمیک؛ برای جست‌وجوی سریع و یافتن نقطه‌ی شروع مناسب است.
    • NotebookLM: ابزار گوگل برای گفت‌وگو با اسنادی که خودتان بارگذاری می‌کنید؛ پاسخ‌ها فقط بر اساس همان منابع ساخته می‌شوند و به بخش دقیق منبع ارجاع می‌دهند.

    مقایسه‌ی دقیق‌تر سه ابزار اصلی این گروه را در مقاله‌ی مقایسه Elicit و Consensus و SciSpace آورده‌ایم و آموزش گام‌به‌گام NotebookLM را در NotebookLM برای پژوهش ببینید.

    یک محدودیت مهم این ابزارها، پوشش پایگاه داده است. بیشتر آن‌ها از پایگاه‌هایی مانند Semantic Scholar یا OpenAlex استفاده می‌کنند که هرچند گسترده‌اند، همه‌ی مقالات را پوشش نمی‌دهند و به متن کامل مقالات پولی دسترسی ندارند. بنابراین این ابزارها جایگزین جست‌وجوی نظام‌مند در Scopus، Web of Science یا PubMed نیستند، به‌ویژه اگر مرور نظام‌مند انجام می‌دهید که باید از استانداردهایی مثل PRISMA پیروی کند.

    یک جریان کاری ترکیبی که برای بسیاری از دانشجویان جواب داده است: با Consensus یا Perplexity یک تصویر کلی از حوزه به دست بیاورید، با Elicit مقالات کلیدی را پیدا و در جدول استخراج کنید، مقالات منتخب را در Zotero ذخیره کنید، با ResearchRabbit مقالات مرتبط جاافتاده را کشف کنید و در نهایت PDFهای اصلی را در NotebookLM یا SciSpace بارگذاری کنید تا با آن‌ها گفت‌وگو کنید. این زنجیره، هم سرعت دارد و هم دقت، چون در هر مرحله به منابع واقعی متکی است. اصول کلی مرور ادبیات را هم در صفحه‌ی مرور ادبیات ببینید.

    ابزارهای نگارش، ویرایش و مدیریت منابع

    گروه سوم، ابزارهایی هستند که به نگارش و سازمان‌دهی کمک می‌کنند:

    • Paperpal و Writefull: ابزارهای ویرایش زبانی تخصصی برای متون آکادمیک که روی مقالات علمی آموزش دیده‌اند و پیشنهادهایی متناسب با سبک نگارش علمی می‌دهند. برخی ناشران نیز ابزارهای مشابهی در فرایند ارسال خود دارند.
    • Grammarly: ابزار عمومی ویرایش گرامر و سبک که برای ویرایش اولیه مفید است، اما همیشه با سبک آکادمیک هماهنگ نیست.
    • Zotero و Mendeley: نرم‌افزارهای مدیریت منابع که هسته‌ی هر جریان کاری پژوهشی هستند. Zotero رایگان و متن‌باز است و افزونه‌های متعددی برای اتصال به ابزارهای هوش مصنوعی دارد.
    • ابزارهای تحلیل داده: دستیارهای عمومی با قابلیت اجرای کد می‌توانند در تحلیل‌های ساده و نوشتن کد R یا Python کمک کنند. برای تفسیر خروجی SPSS، راهنمای تحلیل SPSS با ChatGPT را ببینید.

    یک نکته درباره‌ی ابزارهای «تشخیص متن هوش مصنوعی»: این ابزارها دقت محدودی دارند و ممکن است متن نوشته‌شده توسط انسان را به اشتباه ماشینی تشخیص دهند، به‌ویژه برای نویسندگان غیرانگلیسی‌زبان. بهترین راه برای اطمینان، نه فریب دادن این ابزارها، بلکه نوشتن واقعی با صدای خودتان و اعلام شفاف استفاده از هوش مصنوعی است.

    ابزارهای «بازنویسی» یا «انسانی‌سازی متن» که وعده‌ی عبور از آشکارسازها را می‌دهند، با اصول صداقت علمی سازگار نیستند. استفاده از آن‌ها برای پنهان‌کردن متن ماشینی، می‌تواند به‌عنوان رفتار فریبکارانه تلقی شود. صفحه‌ی صداقت علمی را در این زمینه ببینید.

    در مورد ابزارهای تحلیل داده، یک هشدار ویژه لازم است. دستیارهای عمومی گاهی آزمون آماری نامناسب پیشنهاد می‌دهند یا پیش‌فرض‌های آزمون را نادیده می‌گیرند. همچنین ممکن است در محاسبات دستی خطا کنند. اگر از قابلیت اجرای کد استفاده می‌کنید، کد تولیدشده را بخوانید و نتایج را با نرم‌افزار اصلی تطبیق دهید. برای تحلیل‌های پیچیده مثل مدل‌سازی معادلات ساختاری یا تحلیل چندسطحی، همراهی یک متخصص آمار ضروری است؛ صفحه‌ی تحلیل آماری ریسرچ اینتل در این زمینه خدمات و راهنمایی ارائه می‌دهد.

    در نهایت، به یاد داشته باشید که ابزارهای این سه گروه رقیب هم نیستند، بلکه مکمل یکدیگرند. پژوهشگری که فقط از دستیار عمومی استفاده می‌کند، در خطر منابع جعلی است؛ پژوهشگری که فقط از ابزارهای جست‌وجو استفاده می‌کند، از کمک در نگارش و ویرایش محروم می‌ماند؛ و کسی که منابعش را در یک نرم‌افزار مدیریت مرجع سازمان‌دهی نمی‌کند، در پایان کار با فهرست منابعی آشفته روبه‌رو می‌شود. ترکیب متعادل این سه گروه، کلید یک جریان کاری پژوهشی کارآمد است.

    مطالعهٔ تکمیلی: اگر می‌خواهید این موضوع را عمیق‌تر و بر پایهٔ یک منبع معتبر دانشگاهی دنبال کنید، راهنماهای هوش مصنوعی در پژوهش دانشگاهی، تاریخچه هوش مصنوعی و آینده هوش مصنوعی در پژوهش را هم در ریسرچ اینتل بخوانید.

    انتخاب و ترکیب ابزارها برای هر مرحله و هر سطح

    حالا که ابزارها را شناختیم، سؤال عملی این است: چه ترکیبی برای من مناسب است؟ پاسخ به مرحله‌ی پژوهش، سطح تحصیلی و نیازهای شما بستگی دارد. در این بخش، یک جعبه‌ابزار مرحله‌به‌مرحله، پیشنهادهایی برای سطوح مختلف و اشتباهاتی که باید از آن‌ها پرهیز کنید را مرور می‌کنیم.

    جعبه‌ابزار پیشنهادی بهترین هوش مصنوعی برای پژوهش در هر مرحله
    جعبه‌ابزار پیشنهادی بهترین هوش مصنوعی برای پژوهش در هر مرحله

    پیش از انتخاب نهایی، یک «آزمایش دوهفته‌ای» را پیشنهاد می‌کنیم. در هفته‌ی اول، جریان کاری فعلی خود را بدون تغییر ادامه دهید و زمانی را که صرف هر کار می‌کنید یادداشت کنید: جست‌وجو، خواندن، یادداشت‌برداری، نوشتن و ویرایش. در هفته‌ی دوم، ابزارهای منتخب را وارد همین کارها کنید و دوباره زمان و کیفیت را ثبت کنید. مقایسه‌ی این دو هفته به شما نشان می‌دهد کدام ابزار واقعاً ارزش افزوده دارد و کدام فقط هیجان اولیه ایجاد کرده است.

    جعبه‌ابزار پیشنهادی برای هر مرحله‌ی پژوهش

    پژوهش را می‌توان به شش مرحله‌ی اصلی تقسیم کرد. برای هر مرحله، ترکیب پیشنهادی ما:

    1. ایده‌پردازی و انتخاب موضوع: یک دستیار عمومی برای طوفان فکری + Consensus یا Elicit برای سنجش سریع وضعیت ادبیات + Google Scholar برای تأیید.
    2. مرور ادبیات: Elicit یا SciSpace برای یافتن و استخراج + ResearchRabbit برای کشف مقالات مرتبط + Zotero برای مدیریت + NotebookLM برای گفت‌وگو با مجموعه‌ی PDFهای خودتان.
    3. طراحی روش: دستیار عمومی برای بررسی هم‌راستایی سؤال و روش + مشورت با استاد و متخصص آمار.
    4. تحلیل داده: نرم‌افزار آماری اصلی (SPSS، R، Stata) + دستیار عمومی برای فهم و تفسیر خروجی.
    5. نگارش: نوشتن پیش‌نویس توسط خودتان + دستیار عمومی برای بازخورد و ویرایش + ابزار ویرایش آکادمیک برای پرداخت نهایی.
    6. ارسال و داوری: دستیار عمومی برای شبیه‌سازی داور، نوشتن نامه‌ی همراه و ساختاردهی پاسخ به داوران.

    این ترکیب‌ها پیشنهادی هستند و بسته به رشته تغییر می‌کنند. برای مثال، پژوهشگران علوم پزشکی ممکن است از ابزارهای مرتبط با PubMed بیشتر استفاده کنند و پژوهشگران علوم انسانی از پایگاه‌های داخلی. اگر در حال نوشتن پایان‌نامه هستید، نحوه‌ی به‌کارگیری این ابزارها را در هر فصل در مقاله‌ی نوشتن پایان‌نامه با هوش مصنوعی توضیح داده‌ایم.

    توجه داشته باشید که در هر مرحله، ابزار جایگزین مهارت نیست. برای مثال، در مرحله‌ی پروپوزال، حتی بهترین ابزارها نمی‌توانند بدون شناخت شما از میدان پژوهش، یک مسئله‌ی واقعی و ارزشمند پیدا کنند. راهنمایی‌های بیشتر را در صفحه‌ی نگارش پروپوزال ببینید. در مرحله‌ی نگارش پایان‌نامه هم صفحه‌ی نگارش پایان‌نامه نکات تکمیلی دارد. نکته‌ی آخر این است که جعبه‌ابزار خود را هر شش ماه یک بار بازبینی کنید؛ ابزارهای جدید می‌آیند و برخی ابزارهای قدیمی تغییر یا تعطیل می‌شوند.

    پیشنهاد برای دانشجوی ارشد، دکتری و متقاضی اپلای

    دانشجوی کارشناسی ارشد: اولویت شما معمولاً نوشتن پروپوزال و پایان‌نامه با کیفیت قابل‌قبول در زمان محدود است. پیشنهاد ما: یک دستیار عمومی (نسخه‌ی رایگان یا پایه)، Zotero، NotebookLM (رایگان) و یکی از ابزارهای Elicit یا Consensus. این ترکیب تقریباً بدون هزینه یا با هزینه‌ی کم، بیشتر نیازهای شما را پوشش می‌دهد. برای شروع پروپوزال، راهنمای نوشتن پروپوزال با هوش مصنوعی را بخوانید.

    دانشجوی دکتری: شما با حجم بیشتری از ادبیات سروکار دارید، احتمالاً چند مقاله‌ی انگلیسی منتشر می‌کنید و نیاز به تحلیل عمیق‌تر دارید. سرمایه‌گذاری روی نسخه‌ی پیشرفته‌ی یک دستیار عمومی با پنجره‌ی متنی بلند و یک ابزار مرور ادبیات تخصصی معمولاً ارزشش را دارد. Scite هم برای ارزیابی اعتبار ادعاهای کلیدی در رساله مفید است. اگر نیاز به همراهی در طراحی این جریان کاری دارید، مشاوره پژوهشی کمک‌کننده است.

    متقاضی اپلای: برای نوشتن SOP، Research Proposal کوتاه، ایمیل به استاد و رزومه‌ی آکادمیک، یک دستیار عمومی قوی برای ویرایش انگلیسی و بازخورد مهم‌ترین ابزار است. اما مراقب باشید: کمیته‌های پذیرش با متن‌های قالبی و ماشینی آشنا هستند و متنی که صدای شخصی شما را نداشته باشد، اثر منفی دارد. برای تنظیم رزومه، صفحه‌ی رزومه دکتری را ببینید و حتماً حساب ORCID و پروفایل Google Scholar خود را به‌روز کنید.

    برای اپلای، ابتدا داستان پژوهشی خودتان را به زبان ساده و به فارسی برای خودتان بنویسید: چه چیزی شما را به این حوزه کشاند، چه کرده‌اید و چه می‌خواهید بکنید. سپس آن را خودتان به انگلیسی بنویسید و فقط برای ویرایش از هوش مصنوعی کمک بگیرید.

    پژوهشگران و اعضای هیئت علمی: برای کسانی که چند پروژه را هم‌زمان مدیریت می‌کنند، ابزارهای سازمان‌دهی و هشدار مقالات جدید اهمیت بیشتری دارند. تنظیم هشدار در Google Scholar، استفاده از ResearchRabbit برای دنبال کردن نویسندگان کلیدی و ساختن نوت‌بوک‌های جداگانه در NotebookLM برای هر پروژه، می‌تواند به مدیریت حجم بالای اطلاعات کمک کند. همچنین اگر دانشجو راهنمایی می‌کنید، داشتن یک سیاست روشن درباره‌ی استفاده از هوش مصنوعی برای دانشجویانتان، از سوءتفاهم‌های بعدی جلوگیری می‌کند.

    اشتباهات رایج، امنیت و استفاده‌ی مسئولانه

    در پایان، چند اشتباه رایج را مرور می‌کنیم که پژوهشگران در انتخاب و استفاده از ابزارهای هوش مصنوعی مرتکب می‌شوند:

    • جمع‌کردن ابزار به‌جای یادگیری: ثبت‌نام در ده ابزار و استفاده‌ی سطحی از همه، به‌جای تسلط بر دو یا سه ابزار.
    • اعتماد کامل به خلاصه‌ها: خواندن خلاصه‌ی هوش مصنوعی به‌جای مقاله‌ی اصلی و نقل نادرست یافته‌ها.
    • استفاده از دستیار عمومی برای یافتن منبع: بدون جست‌وجوی وب یا بررسی، که به منابع جعلی منجر می‌شود.
    • بی‌توجهی به حریم خصوصی: بارگذاری داده‌های حساس بدون بررسی تنظیمات.
    • عدم اعلام استفاده: نادیده گرفتن سیاست‌های مجلات و دانشگاه درباره‌ی شفافیت.
    • خرید اشتراک‌های غیرضروری: پرداخت برای امکاناتی که هرگز استفاده نمی‌شوند.

    از نظر اخلاقی، توصیه‌های نهادهایی مثل COPE و ICMJE روشن است: هوش مصنوعی نمی‌تواند نویسنده باشد، مسئولیت محتوا با انسان است و استفاده باید شفاف اعلام شود. نحوه‌ی عملی اعلام را در مقاله‌ی استفاده از ChatGPT در مقاله با نمونه‌متن آورده‌ایم.

    یک عادت مفید دیگر، نگهداری «دفترچه‌ی ابزار» است: یک فایل ساده که در آن ثبت می‌کنید از کدام ابزار، در چه تاریخی، برای چه کاری و با چه پرامپتی استفاده کرده‌اید. این دفترچه هم به شما کمک می‌کند جریان کاری مؤثر را تکرار کنید و هم زمانی که مجله یا دانشگاه از شما توضیح درباره‌ی استفاده از هوش مصنوعی خواست، پاسخی دقیق و مستند داشته باشید. پژوهشگرانی که این عادت را دارند، معمولاً در نوشتن بخش اعلام استفاده از ابزار هم مشکلی ندارند.

    هیچ ابزار هوش مصنوعی نمی‌تواند انتشار مقاله را تضمین کند. اگر سرویسی ادعا می‌کند با ابزار خاصی «پذیرش قطعی» در مجلات معتبر می‌گیرد، احتمال کلاهبرداری یا ارتباط با مجلات جعلی بالاست. برای شناخت این خطر، مقاله‌ی مجلات جعلی و لیست سیاه را بخوانید.

    یک جنبه‌ی دیگر امنیت، حفاظت از حساب‌های کاربری است. اگر یک حساب را با دیگران به اشتراک می‌گذارید، همه‌ی تاریخچه‌ی گفت‌وگوها، فایل‌های بارگذاری‌شده و پیش‌نویس‌های شما برای آن‌ها قابل‌مشاهده است. برای کارهای پژوهشی محرمانه، حساب شخصی با رمز قوی و تأیید دومرحله‌ای استفاده کنید. همچنین پیش از انتشار مقاله، نسخه‌ی کامل آن را در گفت‌وگوهایی که دیگران به آن دسترسی دارند وارد نکنید. پس از انتشار هم، برای آشنایی با مراحل پس از پذیرش و حقوق نشر، صفحه‌ی انتشار مقاله را ببینید.

    جمع‌بندی: پاسخ به سؤال «بهترین هوش مصنوعی برای پژوهش کدام است؟» یک نام واحد نیست، بلکه یک ترکیب هوشمندانه است: یک دستیار عمومی برای فکر کردن و نوشتن بهتر، یک ابزار مبتنی بر منبع برای یافتن و خواندن مقالات واقعی، یک ابزار مدیریت منابع برای نظم و یک ابزار گفت‌وگو با اسناد برای کار با PDFهای خودتان. معیار انتخاب را دقت، استناد، حریم خصوصی، دسترسی و هزینه قرار دهید و همیشه شما تصمیم‌گیرنده‌ی نهایی باشید. برای یادگیری عملی این ترکیب در کنار مربی، دوره مقاله‌نویسی با هوش مصنوعی و برنامه‌های هفته پژوهش را دنبال کنید و برای آشنایی گسترده‌تر با این حوزه، صفحه‌ی هوش مصنوعی در پژوهش را ببینید.

    برای آموزش‌ها و مشاوره‌های بیشتر پژوهشی به هوش پژوهشی سر بزنید.
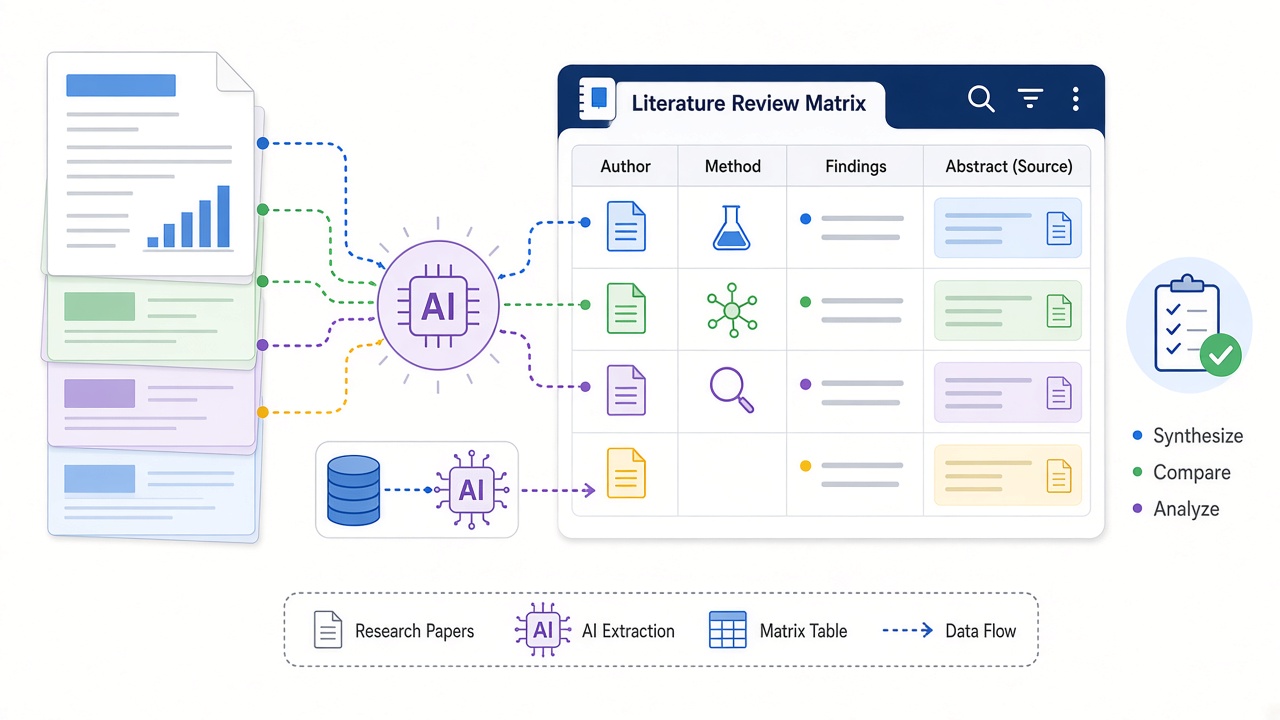
  • مقاله‌نویسی علمی با هوش مصنوعی؛ از ایده تا چکیده

    مقاله‌نویسی علمی با هوش مصنوعی؛ از ایده تا چکیده

    مقاله‌نویسی علمی با هوش مصنوعی دیگر یک موضوع حاشیه‌ای نیست؛ امروز بخش بزرگی از پژوهشگران، از دانشجوی ارشد تا استاد باتجربه، دست‌کم در یکی از مراحل نگارش مقاله از ابزارهای هوش مصنوعی کمک می‌گیرند. اما میان «کمک گرفتن» و «سپردن مقاله به ماشین» فاصله‌ای جدی وجود دارد؛ فاصله‌ای که می‌تواند تفاوت میان یک مقاله‌ی پذیرفته‌شده و یک مقاله‌ی ریجکت‌شده یا حتی پس‌گرفته‌شده (Retracted) باشد.

    بسیاری از دانشجویان ایرانی با یک چالش مشترک روبه‌رو هستند: داده‌ها و یافته‌های ارزشمندی دارند، اما تبدیل آن‌ها به یک مقاله‌ی منسجم، روان و مطابق با استانداردهای مجلات بین‌المللی برایشان دشوار است. نوشتن به زبان انگلیسی، رعایت ساختار استاندارد، نگارش چکیده‌ای که در ۲۵۰ کلمه کل پژوهش را منتقل کند و پاسخ دادن به نظر داوران، همه مهارت‌هایی هستند که زمان می‌برند. هوش مصنوعی می‌تواند این مسیر را هموارتر کند، به شرط آنکه نقشش را درست بشناسیم.

    در این راهنما، مسیر کامل نوشتن مقاله را از جرقه‌ی اولیه‌ی ایده تا نگارش چکیده و آماده‌سازی برای ارسال، مرحله‌به‌مرحله مرور می‌کنیم. برای هر مرحله توضیح می‌دهیم هوش مصنوعی چه کمکی می‌کند، کجا خطرناک است و چه پرامپت‌هایی جواب می‌دهد. تأکید ما در تمام این مسیر بر استفاده‌ی مسئولانه است: شما نویسنده و مسئول مقاله هستید و هوش مصنوعی ابزاری برای بهتر فکر کردن و بهتر نوشتن.

    اگر در حال استخراج مقاله از پایان‌نامه هستید، پیشنهاد می‌کنیم این مطلب را همراه با راهنمای استخراج مقاله از پایان‌نامه بخوانید. آن مقاله تمرکز بیشتری بر تبدیل فصل‌های پایان‌نامه به قالب IMRaD دارد.

    مبانی مقاله‌نویسی علمی با هوش مصنوعی

    پیش از هر چیز باید بدانیم مقاله‌ی علمی چه ویژگی‌هایی دارد، هوش مصنوعی در کدام بخش‌ها واقعاً مفید است و ناشران معتبر چه قوانینی برای استفاده از این ابزارها گذاشته‌اند. این سه موضوع، پایه‌ی تمام تصمیم‌هایی است که در مراحل بعدی می‌گیرید. اگر این مبانی را نادیده بگیرید، ممکن است مقاله‌ای بنویسید که از نظر زبانی بی‌نقص است اما از نظر علمی یا اخلاقی قابل‌دفاع نیست.

    ساختار IMRaD در مقاله‌نویسی علمی با هوش مصنوعی
    ساختار IMRaD در مقاله‌نویسی علمی با هوش مصنوعی

    ساختار مقاله‌ی علمی و قالب IMRaD

    بیشتر مقالات پژوهشی تجربی در علوم پزشکی، مهندسی، علوم پایه و بخش بزرگی از علوم انسانی از قالبی به نام IMRaD پیروی می‌کنند. این قالب مخفف چهار بخش اصلی است:

    • Introduction (مقدمه): چرا این پژوهش انجام شد؟ مسئله، شکاف و هدف.
    • Methods (روش): پژوهش چگونه انجام شد؟ طرح، نمونه، ابزار و تحلیل.
    • Results (نتایج): چه یافته‌هایی به دست آمد؟ بدون تفسیر.
    • and Discussion (بحث): یافته‌ها چه معنایی دارند؟ مقایسه با مطالعات قبلی، محدودیت‌ها و پیشنهادها.

    علاوه بر این چهار بخش، مقاله عنوان، چکیده، کلیدواژه‌ها، منابع و گاهی بخش‌هایی مثل «نتیجه‌گیری»، «تقدیر و تشکر»، «تعارض منافع» و «در دسترس بودن داده‌ها» دارد. هر مجله در بخش «راهنمای نویسندگان» (Guide for Authors) جزئیات دقیق را مشخص می‌کند.

    چرا شناخت این ساختار برای استفاده از هوش مصنوعی مهم است؟ چون وقتی از ابزار کمک می‌گیرید، باید دقیقاً بگویید روی کدام بخش و با چه کارکردی کار می‌کند. پرامپتی مثل «مقاله‌ام را بهتر کن» نتیجه‌ی مبهمی دارد؛ اما «بخش بحث من را بررسی کن و بگو آیا یافته‌ها با مطالعات قبلی مقایسه شده‌اند و آیا محدودیت‌ها ذکر شده‌اند» خروجی هدفمند و مفیدی می‌دهد.

    یک نکته‌ی مهم دیگر این است که ترتیب نوشتن با ترتیب خواندن یکی نیست. بسیاری از نویسندگان باتجربه ابتدا روش و نتایج را می‌نویسند، سپس بحث، بعد مقدمه و در آخر عنوان و چکیده. دلیلش این است که روش و نتایج «واقعیت‌های» پژوهش هستند و نوشتن آن‌ها ساده‌تر است، در حالی که مقدمه و بحث نیازمند چارچوب‌بندی هستند که بعد از روشن شدن یافته‌ها راحت‌تر انجام می‌شود. هوش مصنوعی می‌تواند در هر کدام از این مراحل همراه شما باشد.

    برای آشنایی بیشتر با الزامات نگارشی ناشران بزرگ، راهنمای نویسندگان Elsevier Author Hub منبع رایگان و بسیار کاربردی است.

    برای مقالات مروری، مطالعات موردی، مقالات نظری و یادداشت‌های کوتاه (Short Communication) ساختار ممکن است متفاوت باشد. مثلاً مقاله‌ی مرور نظام‌مند از قالب PRISMA پیروی می‌کند و بخش روش آن به راهبرد جست‌وجو، معیارهای ورود و ارزیابی کیفیت اختصاص دارد. مقاله‌ی کیفی هم معمولاً بخش «یافته‌ها» را با مضامین و نقل‌قول‌های مشارکت‌کنندگان ارائه می‌دهد. پیش از استفاده از هوش مصنوعی، نوع مقاله‌ی خود را دقیق مشخص کنید و همین را در پرامپت ذکر کنید تا ابزار ساختار درستی را مبنا قرار دهد.

    هوش مصنوعی در مقاله‌نویسی چه کاری خوب انجام می‌دهد و چه کاری نه؟

    برای استفاده‌ی هوشمندانه، باید نقاط قوت و ضعف ابزارها را بشناسیم. تجربه‌ی ما در کار با پژوهشگران نشان می‌دهد که هوش مصنوعی در این کارها عملکرد خوبی دارد:

    1. سازمان‌دهی ایده‌ها: تبدیل یادداشت‌های پراکنده به یک طرح کلی منطقی.
    2. ویرایش زبانی: اصلاح گرامر، روان‌سازی جملات و یکدست کردن اصطلاحات، به‌ویژه برای نویسندگانی که انگلیسی زبان اولشان نیست.
    3. خلاصه‌سازی: فشرده‌کردن متن‌های طولانی، مثلاً برای نوشتن چکیده یا Highlights.
    4. بازخورد ساختاری: شناسایی پاراگراف‌های نامنسجم، تکرارها و پرش‌های منطقی.
    5. شبیه‌سازی داور: طرح سؤال‌های انتقادی که داوران احتمالاً می‌پرسند.

    و در این کارها ضعیف یا حتی خطرناک است:

    • تولید منابع: احتمال ساختن ارجاعات جعلی بالاست.
    • تفسیر داده‌های شما: اگر داده را ندیده باشد، فقط حدس می‌زند.
    • ادعاهای علمی تازه: ممکن است با اطمینان جملاتی بگوید که درست نیستند.
    • دانش تخصصی به‌روز: اطلاعات مدل‌ها تا یک تاریخ مشخص است و ممکن است جدیدترین یافته‌ها را نداند.
    • قضاوت درباره‌ی اهمیت یافته‌ها: این کار نیازمند شناخت عمیق حوزه است.

    هوش مصنوعی ابزاری برای بهتر نوشتن چیزهایی است که می‌دانید، نه ابزاری برای نوشتن چیزهایی که نمی‌دانید.

    این تمایز در عمل بسیار تعیین‌کننده است. اگر بخشی از مقاله را نمی‌فهمید یا یافته‌ای را نمی‌توانید تفسیر کنید، هوش مصنوعی مشکل شما را حل نمی‌کند؛ فقط آن را پنهان می‌کند. و داوران معمولاً همین بخش‌های پنهان‌شده را پیدا می‌کنند. برای انتخاب ابزار مناسب هر کار، مقاله‌ی بهترین هوش مصنوعی برای پژوهش را ببینید.

    یک آزمون ساده برای اینکه بفهمید استفاده‌ی شما مسئولانه است یا نه: اگر فردا ابزار هوش مصنوعی در دسترس نبود، آیا می‌توانستید همین مقاله را، شاید با زمان بیشتر، خودتان بنویسید؟ اگر پاسخ مثبت است، ابزار در نقش دستیار بوده است. اگر پاسخ منفی است، یعنی بخشی از کار فکری را به ابزار سپرده‌اید و احتمالاً در پاسخ به داوران یا دفاع از مقاله دچار مشکل می‌شوید. این آزمون به‌ویژه برای دانشجویانی که اولین مقاله‌ی خود را می‌نویسند اهمیت دارد، چون مهارت‌های پایه‌ی نگارش علمی در همین مرحله شکل می‌گیرد.

    قوانین ناشران و اخلاق استفاده از هوش مصنوعی

    در دو سال اخیر، تقریباً همه‌ی ناشران بزرگ، سیاست مشخصی درباره‌ی هوش مصنوعی مولد منتشر کرده‌اند. هرچند جزئیات متفاوت است، چند اصل تقریباً مشترک وجود دارد:

    • هوش مصنوعی نویسنده نیست: هیچ ابزاری نمی‌تواند در فهرست نویسندگان قرار گیرد. مجله‌ی Nature و COPE صراحتاً این را اعلام کرده‌اند.
    • شفافیت الزامی است: استفاده از ابزار باید در بخش روش، تقدیر و تشکر یا یک بخش اختصاصی اعلام شود.
    • مسئولیت با نویسنده است: هر خطا، سرقت علمی یا ادعای نادرست، مسئولیتش با نویسندگان انسانی است.
    • تصاویر تولیدشده محدودیت دارند: بسیاری از ناشران استفاده از تصاویر تولیدشده با هوش مصنوعی را در مقاله ممنوع یا بسیار محدود کرده‌اند.
    • ویرایش زبانی معمولاً مجاز است: استفاده برای بهبود خوانایی و زبان، معمولاً پذیرفته است، اما گاهی همچنان باید اعلام شود.

    برخی مجلات تمایز میان «ویرایش زبانی» و «تولید محتوا» را دقیق تعریف کرده‌اند. پیش از ارسال، حتماً بخش سیاست هوش مصنوعی مجله‌ی هدف را بخوانید؛ چون قوانین از ناشری به ناشر دیگر فرق دارد و به‌طور مرتب به‌روز می‌شود.

    از نظر اخلاقی هم باید به یاد داشته باشید که داوری همتا (Peer Review) بر اعتماد بنا شده است. وقتی مقاله‌ای ارسال می‌کنید، به‌طور ضمنی اعلام می‌کنید که ایده‌ها، تحلیل‌ها و نتیجه‌گیری‌ها متعلق به شماست. استفاده‌ی پنهان از هوش مصنوعی برای تولید محتوا، این اعتماد را زیر سؤال می‌برد. جزئیات نحوه‌ی اعلام استفاده و نمونه‌متن‌های آماده را در مقاله‌ی استفاده از ChatGPT در مقاله آورده‌ایم. همچنین صفحه‌ی صداقت علمی ریسرچ اینتل اصول کلی را مرور کرده است.

    نکته‌ی آخر در این بخش، حریم خصوصی و محرمانگی است. مقاله‌ای که هنوز منتشر نشده، دارایی فکری شما و همکارانتان است. پیش از بارگذاری متن کامل در هر ابزار، تنظیمات استفاده از داده برای آموزش مدل را بررسی کنید و در صورت امکان آن را غیرفعال کنید. اگر داده‌های بیماران، مشارکت‌کنندگان یا اطلاعات حساس سازمانی دارید، فقط بخش‌های غیرحساس متن را وارد کنید. برخی نسخه‌های سازمانی ابزارها تضمین‌های بیشتری درباره‌ی محرمانگی دارند؛ صفحه‌ی خرید اکانت هوش مصنوعی گزینه‌های مختلف را معرفی کرده است.

    از ایده تا پیش‌نویس کامل مقاله

    حالا وارد مرحله‌ی عملی می‌شویم. در این بخش، فرایند تبدیل یک ایده یا مجموعه‌ای از داده‌ها به یک پیش‌نویس کامل مقاله را دنبال می‌کنیم. ابتدا ایده و انتخاب مجله، سپس مقدمه و مرور ادبیات، و در نهایت روش، نتایج و بحث. در هر مرحله نمونه پرامپت و توصیه‌های عملی ارائه می‌دهیم که می‌توانید مستقیماً در کار خودتان به کار ببرید.

    مراحل مقاله‌نویسی علمی با هوش مصنوعی از ایده تا پیش‌نویس
    مراحل مقاله‌نویسی علمی با هوش مصنوعی از ایده تا پیش‌نویس

    ایده، سؤال پژوهش و انتخاب مجله‌ی هدف

    هر مقاله‌ی خوب با یک «پیام اصلی» روشن شروع می‌شود؛ جمله‌ای که اگر خواننده فقط آن را به خاطر بسپارد، کافی است. پیش از نوشتن حتی یک پاراگراف، این جمله را برای خودتان بنویسید. برای مثال: «حمایت سازمانی ادراک‌شده، رابطه‌ی میان فشار کاری و فرسودگی شغلی پرستاران را تعدیل می‌کند.»

    هوش مصنوعی می‌تواند در شفاف‌سازی این پیام کمک کند. پرامپت نمونه:

    «این خلاصه‌ی یافته‌های پژوهش من است. سه نسخه‌ی مختلف از پیام اصلی مقاله را در یک جمله پیشنهاد بده و بگو هر نسخه برای چه نوع مجله‌ای (کاربردی، نظری، میان‌رشته‌ای) مناسب‌تر است.»

    پس از روشن شدن پیام اصلی، باید مجله‌ی هدف را انتخاب کنید. این کار را پیش از نوشتن انجام دهید، نه بعد از آن؛ چون ساختار، طول، سبک ارجاع‌دهی و حتی لحن مقاله به مجله بستگی دارد. معیارهای انتخاب مجله عبارت‌اند از:

    • هم‌خوانی موضوع مقاله با Aims and Scope مجله
    • نمایه شدن در پایگاه‌های معتبر مثل Scopus و Web of Science
    • زمان داوری و نرخ پذیرش
    • هزینه‌ی انتشار (APC) در مجلات دسترسی آزاد
    • نبودن در فهرست مجلات مشکوک یا جعلی

    درباره‌ی معیار آخر بسیار مراقب باشید. هر سال تعداد زیادی از پژوهشگران ایرانی گرفتار مجلات جعلی می‌شوند که وعده‌ی پذیرش سریع می‌دهند. نحوه‌ی تشخیص این مجلات را در مقاله‌ی مجلات جعلی و لیست سیاه به تفصیل شرح داده‌ایم.

    هوش مصنوعی می‌تواند فهرستی اولیه از مجلات مرتبط پیشنهاد دهد، اما این فهرست را حتماً با ابزارهایی مثل Elsevier Journal Finder، Springer Journal Suggester و سایت رسمی Scopus تطبیق دهید. مدل‌های زبانی گاهی نام مجلات را اشتباه می‌گویند یا مجلاتی را معرفی می‌کنند که از نمایه خارج شده‌اند.

    چند مقاله‌ی اخیر از مجله‌ی هدف را دانلود کنید و ساختار، طول بخش‌ها و لحن آن‌ها را بررسی کنید. می‌توانید این مقالات را به ابزاری مثل NotebookLM بدهید و بپرسید «الگوی مشترک مقدمه‌ها در این مقالات چیست؟» تا تصویر روشنی از انتظارات مجله پیدا کنید.

    یک کار مفید دیگر در این مرحله، نوشتن «طرح یک‌صفحه‌ای مقاله» است. در این طرح، برای هر بخش IMRaD دو یا سه جمله بنویسید: مقدمه چه شکافی را نشان می‌دهد، روش چه بود، یافته‌ی اصلی چیست و بحث چه پیامی دارد. سپس این طرح را به هوش مصنوعی بدهید و بخواهید منطق کلی را بررسی کند. اصلاح منطق در سطح یک صفحه بسیار آسان‌تر از اصلاح آن در یک مقاله‌ی هشت‌هزار کلمه‌ای است. این طرح همچنین مبنای خوبی برای گفت‌وگو با همکاران و استاد راهنما پیش از شروع نگارش کامل است.

    نوشتن مقدمه و مرور ادبیات با کمک هوش مصنوعی

    مقدمه‌ی مقاله باید خواننده را از یک زمینه‌ی کلی به مسئله‌ی مشخص و سپس به هدف پژوهش برساند. یک الگوی رایج و مؤثر برای مقدمه، مدل «قیف» یا مدل CARS (Create a Research Space) است که سه حرکت اصلی دارد:

    1. ایجاد قلمرو: نشان دادن اهمیت موضوع و مرور مختصر آنچه می‌دانیم.
    2. ایجاد جایگاه: نشان دادن شکاف، تناقض یا پرسش بی‌پاسخ.
    3. اشغال جایگاه: معرفی هدف، سؤالات و گاهی مشارکت اصلی پژوهش.

    هوش مصنوعی در ساختاردهی این سه حرکت بسیار مفید است. می‌توانید پیش‌نویس مقدمه‌ی خود را به ابزار بدهید و بخواهید آن را بر اساس مدل CARS تحلیل کند: «کدام جمله‌ها قلمرو را می‌سازند، کجا شکاف بیان شده و آیا هدف به‌وضوح به شکاف متصل است؟»

    اما برای محتوای مرور ادبیات، باید از منابع واقعی شروع کنید. جریان کاری پیشنهادی ما:

    • مقالات کلیدی را با جست‌وجو در Google Scholar، Scopus و ابزارهای مبتنی بر منبع مثل Elicit یا Consensus پیدا کنید.
    • مقالات را بخوانید و یادداشت‌برداری کنید؛ حداقل چکیده، روش و یافته‌های اصلی.
    • یادداشت‌ها را در یک ماتریس سازمان‌دهی کنید.
    • از هوش مصنوعی بخواهید الگوها و شکاف‌های موجود در ماتریس را شناسایی کند.
    • پیش‌نویس مرور را خودتان بنویسید و سپس برای انسجام و روانی از ابزار کمک بگیرید.

    ابزارهای مبتنی بر منبع در این مرحله ارزش زیادی دارند، چون پاسخ‌ها را به مقالات واقعی متصل می‌کنند. اگر می‌خواهید بدانید کدام ابزار برای کدام کار مناسب‌تر است، مقاله‌ی مقایسه Elicit و Consensus و SciSpace را بخوانید. برای کار با PDFهای خودتان نیز آموزش NotebookLM برای پژوهش راهگشاست.

    یک خطای رایج در مقدمه این است که نویسنده آن‌قدر به زمینه‌ی کلی می‌پردازد که شکاف و هدف در انتهای صفحه‌ی دوم گم می‌شوند. داوران و ویراستاران معمولاً مقدمه‌ی کوتاه و متمرکز را ترجیح می‌دهند. از هوش مصنوعی بخواهید پاراگراف‌هایی را که مستقیماً به شکاف ربط ندارند مشخص کند تا بتوانید آن‌ها را کوتاه یا حذف کنید.

    در مقالاتی که از پایان‌نامه استخراج می‌شوند، مرور ادبیات معمولاً باید به‌شدت فشرده شود. فصل دوم پایان‌نامه ممکن است پنجاه صفحه باشد، اما مقدمه‌ی مقاله اغلب از هزار تا هزار و پانصد کلمه فراتر نمی‌رود. هوش مصنوعی می‌تواند در این فشرده‌سازی کمک کند، به شرط اینکه شما مشخص کنید کدام مطالعات حتماً باید بمانند. برای یادگیری اصول مرور ادبیات اثربخش، صفحه‌ی مرور ادبیات ریسرچ اینتل را ببینید و اگر فصل‌های پایان‌نامه را هنوز می‌نویسید، راهنمای نگارش پایان‌نامه هم مفید است.

    نوشتن روش، نتایج و بحث

    بخش روش باید آن‌قدر دقیق باشد که پژوهشگر دیگری بتواند مطالعه‌ی شما را تکرار کند. هوش مصنوعی در این بخش می‌تواند بررسی کند آیا همه‌ی اجزای لازم ذکر شده‌اند: طرح پژوهش، جامعه و نمونه، روش نمونه‌گیری، معیارهای ورود و خروج، ابزارها و روایی و پایایی آن‌ها، روش گردآوری، ملاحظات اخلاقی و روش تحلیل. برای بسیاری از انواع مطالعه، چک‌لیست‌های استاندارد گزارش‌دهی مثل CONSORT، STROBE یا PRISMA وجود دارد. می‌توانید چک‌لیست مرتبط را به ابزار بدهید و بخواهید روش شما را با آن تطبیق دهد.

    بخش نتایج باید یافته‌ها را بدون تفسیر و به ترتیب سؤال‌ها یا فرضیه‌ها گزارش کند. اینجا دقت عددی حیاتی است. هوش مصنوعی می‌تواند در تبدیل جدول‌های خروجی نرم‌افزار آماری به متن گزارشی کمک کند، اما همه‌ی اعداد را خودتان با خروجی اصلی تطبیق دهید. اگر با SPSS کار می‌کنید، راهنمای تحلیل SPSS با ChatGPT نحوه‌ی گزارش‌دهی درست را شرح داده است.

    هرگز از هوش مصنوعی نخواهید داده بسازد، نتایج را «بهتر» کند یا مقدار p را تغییر دهد. جعل و دست‌کاری داده از جدی‌ترین تخلفات پژوهشی است و می‌تواند به پس‌گرفتن مقاله و پیامدهای حرفه‌ای جدی منجر شود.

    بخش بحث جایی است که ارزش علمی مقاله آشکار می‌شود. ساختار پیشنهادی برای بحث:

    1. خلاصه‌ی کوتاه یافته‌ی اصلی در پاسخ به سؤال پژوهش
    2. مقایسه‌ی یافته‌ها با مطالعات قبلی؛ هم‌سو و ناهم‌سو
    3. تبیین نظری یافته‌ها و دلایل احتمالی تفاوت‌ها
    4. پیامدهای نظری و کاربردی
    5. محدودیت‌ها
    6. پیشنهادهای پژوهش آینده

    هوش مصنوعی در بحث می‌تواند تبیین‌های جایگزین پیشنهاد دهد: «یافته‌ی من این است که متغیر X اثر معناداری نداشت، در حالی که دو مطالعه‌ی قبلی اثر مثبت گزارش کرده بودند. چه تبیین‌های نظری و روش‌شناختی ممکن است برای این تفاوت وجود داشته باشد؟» سپس شما باید تبیین‌ها را با ادبیات واقعی بسنجید و فقط موارد قابل‌دفاع را نگه دارید.

    یک نکته‌ی کمتر گفته‌شده: بخش محدودیت‌ها را صادقانه بنویسید. داوران به محدودیت‌های اعلام‌شده احترام می‌گذارند، اما محدودیت‌های پنهان‌شده را با شدت بیشتری نقد می‌کنند. هوش مصنوعی می‌تواند محدودیت‌های بالقوه‌ی طرح شما را فهرست کند تا چیزی از قلم نیفتد.

    برای جدول‌ها و شکل‌ها هم دقت ویژه داشته باشید. هر جدول باید بدون خواندن متن قابل‌فهم باشد: عنوان گویا، واحدها، توضیح اختصارات و یادداشت‌های لازم. هوش مصنوعی می‌تواند پیشنهاد دهد کدام یافته‌ها بهتر است در جدول و کدام در شکل ارائه شوند، اما خود شکل‌ها باید از داده‌های واقعی و با نرم‌افزارهای آماری یا ترسیمی ساخته شوند. اگر در انتخاب یا اجرای آزمون‌های آماری تردید دارید، پیش از نوشتن نتایج با یک متخصص مشورت کنید؛ صفحه‌ی تحلیل آماری در این زمینه راهنمایی می‌کند.

    مطالعهٔ تکمیلی: اگر می‌خواهید این موضوع را عمیق‌تر و بر پایهٔ یک منبع معتبر دانشگاهی دنبال کنید، راهنماهای ویرایش مقاله با هوش مصنوعی، همکاری انسان و هوش مصنوعی و اخلاق هوش مصنوعی در پژوهش را هم در ریسرچ اینتل بخوانید.

    عنوان، چکیده، بازبینی و آماده‌سازی برای ارسال

    پس از آماده شدن پیش‌نویس کامل، نوبت به بخش‌هایی می‌رسد که بیشترین دیده‌شدن را دارند: عنوان و چکیده. این دو بخش تعیین می‌کنند که آیا ویراستار مقاله را برای داوری می‌فرستد و آیا خوانندگان آن را پیدا می‌کنند و می‌خوانند. سپس ویرایش زبانی، بازبینی نهایی و آماده‌سازی نامه‌ی همراه را مرور می‌کنیم.

    نگارش عنوان و چکیده در مقاله‌نویسی علمی با هوش مصنوعی
    نگارش عنوان و چکیده در مقاله‌نویسی علمی با هوش مصنوعی

    نوشتن چکیده و عنوان مؤثر

    چکیده، خلاصه‌ی مستقل کل مقاله است و معمولاً بین ۱۵۰ تا ۳۰۰ کلمه طول دارد. بسیاری از مجلات چکیده‌ی ساختاریافته با بخش‌های Background، Methods، Results و Conclusion می‌خواهند. حتی اگر مجله چکیده‌ی ساختاریافته نخواهد، رعایت همین ترتیب منطقی در یک پاراگراف واحد توصیه می‌شود.

    چون چکیده باید پس از نوشتن کل مقاله تهیه شود، هوش مصنوعی اینجا یکی از مفیدترین کاربردهایش را دارد. اما باز هم توصیه می‌کنیم ابتدا خودتان یک نسخه‌ی خام بنویسید. سپس از این پرامپت استفاده کنید:

    «این پیش‌نویس چکیده‌ی من است و این متن کامل بخش نتایج. بررسی کن آیا چکیده همه‌ی یافته‌های اصلی را با اعداد کلیدی گزارش کرده، آیا ادعایی فراتر از نتایج دارد و آیا در محدوده‌ی ۲۵۰ کلمه است. سپس نسخه‌ی ویرایش‌شده را بده و تغییرات را توضیح بده.»

    چند اصل مهم برای چکیده:

    • ادعایی در چکیده نیاورید که در متن مقاله نیست.
    • اعداد کلیدی (اندازه‌ی نمونه، اندازه‌ی اثر، سطح معناداری) را ذکر کنید.
    • از اختصارات تعریف‌نشده و ارجاع به منابع پرهیز کنید.
    • جمله‌ی پایانی باید پیامد اصلی را روشن بیان کند.

    برای عنوان، هدف این است که دقیق، کوتاه و قابل‌جست‌وجو باشد. عنوان خوب معمولاً متغیرهای اصلی، جامعه و گاهی روش را در بر دارد. از هوش مصنوعی بخواهید ده عنوان پیشنهادی در سه سبک بدهد: توصیفی، اعلانی (که یافته را بیان می‌کند) و پرسشی. سپس بر اساس سبک مجله‌ی هدف، یکی را انتخاب و تنظیم کنید.

    کلیدواژه‌ها را هم فراموش نکنید. کلیدواژه‌ها باید تکمیل‌کننده‌ی عنوان باشند، نه تکرار آن. می‌توانید از اصطلاحنامه‌هایی مثل MeSH در علوم پزشکی استفاده کنید و از هوش مصنوعی بخواهید مترادف‌های رایج در ادبیات را پیشنهاد دهد.

    یک خطای رایج دیگر، «چکیده‌ی تبلیغاتی» است: چکیده‌ای پر از صفت‌های بزرگ مثل «نوآورانه» و «جامع» اما خالی از اعداد و یافته‌های مشخص. ویراستاران مجلات معتبر این نوع چکیده را به‌سرعت تشخیص می‌دهند. هوش مصنوعی گاهی به‌طور پیش‌فرض همین لحن را تولید می‌کند، پس در پرامپت بنویسید: «از صفت‌های اغراق‌آمیز پرهیز کن و به‌جای آن داده‌ی مشخص بیاور.» همچنین Highlights یا نکات برجسته را، اگر مجله بخواهد، در سه تا پنج جمله‌ی کوتاه و هر کدام زیر ۸۵ کاراکتر بنویسید.

    ویرایش زبانی و نگارش انگلیسی آکادمیک

    برای نویسندگانی که زبان مادری‌شان انگلیسی نیست، ویرایش زبانی یکی از بزرگ‌ترین موانع انتشار است. هوش مصنوعی در این زمینه انقلابی واقعی ایجاد کرده و می‌تواند متنی را که قبلاً به ویراستار حرفه‌ای نیاز داشت، به سطح قابل‌قبولی برساند. اما چند نکته را باید رعایت کنید:

    • محتوا را تغییر ندهد: در پرامپت صراحتاً بگویید «فقط زبان را اصلاح کن و معنای علمی را تغییر نده.»
    • اصطلاحات تخصصی را حفظ کند: گاهی ابزار یک اصطلاح تخصصی را با مترادف عمومی جایگزین می‌کند که در حوزه‌ی شما معنای دیگری دارد.
    • لحن را یکدست کند: از ابزار بخواهید زمان افعال را در هر بخش یکدست کند (مثلاً گذشته برای روش و نتایج).
    • تغییرات را نشان دهد: درخواست کنید تغییرات را به‌صورت فهرست یا با علامت‌گذاری نشان دهد تا بتوانید هر مورد را بررسی کنید.

    یک تکنیک مفید، ویرایش پاراگراف‌به‌پاراگراف است. وقتی کل مقاله را یک‌جا وارد می‌کنید، ابزار ممکن است بخش‌هایی را خلاصه کند یا جزئیات را حذف کند. ویرایش تدریجی، کنترل بیشتری به شما می‌دهد.

    ترجمه‌ی ماشینی کامل یک مقاله‌ی فارسی به انگلیسی معمولاً نتیجه‌ی خوبی نمی‌دهد. بهتر است متن را مستقیماً به انگلیسی بنویسید، حتی اگر ساده و ناهموار باشد، و سپس آن را با هوش مصنوعی ویرایش کنید. این روش متنی طبیعی‌تر و دقیق‌تر تولید می‌کند و مهارت نوشتن شما را هم تقویت می‌کند.

    اگر می‌خواهید این مهارت‌ها را به‌صورت ساختاریافته یاد بگیرید، دوره مقاله‌نویسی با هوش مصنوعی ریسرچ اینتل تمرین‌های عملی برای هر بخش مقاله دارد. همچنین بانک پرامپت‌های پژوهشی مجموعه‌ای از پرامپت‌های آزموده‌شده برای ویرایش آکادمیک را ارائه می‌کند.

    در پایان ویرایش زبانی، متن را یک بار با صدای بلند بخوانید یا از ابزار تبدیل متن به گفتار استفاده کنید. گوش انسان ناهمواری‌ها و جملات طولانی را بهتر از چشم تشخیص می‌دهد. اگر بودجه دارید، برای مقالات مهم، ویرایش نهایی توسط یک ویراستار انسانی متخصص حوزه همچنان ارزش افزوده‌ی قابل‌توجهی دارد؛ هوش مصنوعی این کار را ارزان‌تر و سریع‌تر می‌کند اما همیشه جایگزین کامل آن نیست. همچنین اگر مقاله را برای اپلای و تقویت پرونده‌ی پژوهشی می‌نویسید، هماهنگی آن با رزومه را از یاد نبرید؛ صفحه‌ی رزومه دکتری نکات مفیدی دارد.

    بازبینی نهایی، نامه‌ی همراه و ارسال مقاله

    پیش از ارسال، مقاله را چند بار از زوایای مختلف بازبینی کنید. یک چک‌لیست پیشنهادی:

    • آیا عنوان، چکیده و نتیجه‌گیری با هم سازگارند؟
    • آیا همه‌ی اعداد در متن، جدول‌ها و چکیده یکسان هستند؟
    • آیا همه‌ی منابع واقعی‌اند، در متن ارجاع داده شده‌اند و با سبک مجله (مثلاً APA) تنظیم شده‌اند؟
    • آیا جدول‌ها و شکل‌ها شماره‌گذاری و در متن به آن‌ها ارجاع داده شده است؟
    • آیا بخش‌های الزامی مجله (تعارض منافع، تأمین مالی، در دسترس بودن داده، اعلام استفاده از هوش مصنوعی) اضافه شده‌اند؟
    • آیا همه‌ی نویسندگان نسخه‌ی نهایی را دیده و تأیید کرده‌اند؟
    • آیا شناسه‌ی ORCID همه‌ی نویسندگان ثبت شده است؟

    هوش مصنوعی می‌تواند در این مرحله نقش «داور شبیه‌سازی‌شده» را بازی کند. پرامپت پیشنهادی: «تو داور یک مجله‌ی معتبر در حوزه‌ی X هستی. این مقاله را بخوان و یک گزارش داوری با نقاط قوت، ضعف‌های اصلی و ضعف‌های جزئی بنویس.» این گزارش را جدی بگیرید و پیش از ارسال، مهم‌ترین ضعف‌ها را برطرف کنید. البته توجه داشته باشید که اگر مقاله محرمانه است یا داده‌های حساس دارد، بارگذاری آن در ابزارهای عمومی باید با احتیاط و با بررسی تنظیمات حریم خصوصی انجام شود.

    نامه‌ی همراه (Cover Letter) فرصتی است تا به ویراستار بگویید چرا مقاله‌ی شما برای مجله‌ی او مناسب است. نامه‌ی خوب کوتاه است و شامل این موارد می‌شود: عنوان مقاله، پیام اصلی در یک یا دو جمله، دلیل تناسب با مجله، تأیید اینکه مقاله جای دیگری در حال بررسی نیست و اعلام تعارض منافع. هوش مصنوعی می‌تواند ساختار نامه را پیشنهاد دهد، اما دلیل تناسب با مجله را باید خودتان و بر اساس شناخت واقعی از مجله بنویسید.

    پس از ارسال، احتمالاً با نظر داوران روبه‌رو می‌شوید. هوش مصنوعی می‌تواند در دسته‌بندی نظرات، پیشنهاد ساختار پاسخ و ویرایش لحن نامه‌ی پاسخ به داوران کمک کند. اما محتوای پاسخ، یعنی اینکه کدام نقد را می‌پذیرید و چطور مقاله را اصلاح می‌کنید، تصمیم علمی شماست. برای آشنایی با کل فرایند ارسال و پیگیری، صفحه‌ی انتشار مقاله را ببینید.

    هیچ ابزار یا خدماتی نمی‌تواند پذیرش مقاله را تضمین کند. کیفیت علمی، تناسب با مجله و پاسخ‌گویی دقیق به داوران، عوامل اصلی پذیرش هستند. هر جایی که «پذیرش تضمینی» وعده می‌دهد، باید با تردید جدی بررسی شود.

    یک توصیه‌ی نهایی برای پس از ارسال: مقاله را در یک پوشه‌ی منظم با همه‌ی نسخه‌ها، فایل‌های داده، خروجی‌های تحلیل و فایل ثبت استفاده از هوش مصنوعی بایگانی کنید. اگر داور یا ویراستار درباره‌ی داده‌ها یا روش سؤالی پرسید، یا اگر مجله بعدها برای بررسی صحت داده‌ها درخواستی داشت، این بایگانی بسیار کارگشا خواهد بود. پژوهشگری که مستندات منظمی دارد، در برابر هر پرسشی آسوده‌تر پاسخ می‌دهد و اعتبار حرفه‌ای خود را بهتر حفظ می‌کند. همچنین اگر مقاله در مرحله‌ی اول ریجکت شد، ناامید نشوید؛ نظر داوران را دقیق بخوانید، مقاله را بهبود دهید و برای مجله‌ی مناسب‌تری ارسال کنید. بسیاری از مقالات موفق، پیش از پذیرش دست‌کم یک بار رد شده‌اند. اگر پس از ریجکت به ارزیابی دوباره‌ی مقاله نیاز داشتید، ثبت جزئیات بازخوردها در یک جدول و مرور آن با هم‌نویسندگان، مسیر اصلاح را روشن‌تر می‌کند.

    جمع‌بندی: مقاله‌نویسی علمی با هوش مصنوعی وقتی ارزشمند است که ابزار در خدمت فکر شما باشد، نه جایگزین آن. از هوش مصنوعی برای سازمان‌دهی ایده‌ها، ساختاردهی مقدمه، بررسی کامل بودن روش، روان‌سازی زبان، نوشتن پیش‌نویس چکیده و شبیه‌سازی داوری استفاده کنید؛ اما منابع، داده‌ها، تفسیرها و تصمیم‌های علمی را خودتان مدیریت کنید و استفاده از ابزار را شفاف اعلام کنید. اگر هنوز در مرحله‌ی طراحی پژوهش هستید، راهنمای نوشتن پروپوزال با هوش مصنوعی را بخوانید و اگر به همراهی تخصصی در نگارش یا داوری داخلی مقاله نیاز دارید، مشاوره پژوهشی ریسرچ اینتل در کنار شماست. برای آشنایی گسترده‌تر با این حوزه هم صفحه‌ی هوش مصنوعی در پژوهش و برنامه‌های هفته پژوهش را دنبال کنید.

    برای آموزش‌ها و مشاوره‌های بیشتر پژوهشی به هوش پژوهشی سر بزنید.
  • نوشتن پروپوزال با هوش مصنوعی؛ راهنمای گام‌به‌گام

    نوشتن پروپوزال با هوش مصنوعی؛ راهنمای گام‌به‌گام

    نوشتن پروپوزال با هوش مصنوعی امروز به یکی از پرسش‌های اصلی دانشجویان کارشناسی ارشد و دکتری تبدیل شده است. بسیاری از دانشجویان ماه‌ها روی انتخاب موضوع، بیان مسئله و طراحی روش تحقیق گیر می‌کنند و حالا ابزارهایی مثل ChatGPT، Claude، Gemini و ابزارهای تخصصی مرور ادبیات این وعده را می‌دهند که این مسیر را کوتاه‌تر کنند. اما سؤال مهم این است: هوش مصنوعی دقیقاً کجای کار به ما کمک می‌کند و کجا باید خودمان تصمیم بگیریم؟

    در این راهنما، به‌جای وعده‌های اغراق‌آمیز، یک مسیر عملی و اخلاقی را مرور می‌کنیم. یاد می‌گیرید چطور از هوش مصنوعی برای ایده‌پردازی، سازمان‌دهی منابع، نگارش پیش‌نویس و بازبینی استفاده کنید، بدون اینکه اصالت علمی کارتان زیر سؤال برود. هدف این است که شما نویسنده‌ی اصلی پروپوزال بمانید و هوش مصنوعی نقش یک دستیار پژوهشی هوشمند را بازی کند.

    این مقاله بخشی از مجموعه‌ی آموزشی هوش پژوهشی در ریسرچ اینتل است. اگر می‌خواهید کل مسیر پژوهش را از پروپوزال تا انتشار مقاله یاد بگیرید، دوره مقاله‌نویسی با هوش مصنوعی نقطه‌ی شروع خوبی است.

    چرا این موضوع اهمیت دارد؟ چون پروپوزال اولین سندی است که کیفیت ذهن پژوهشی شما را نشان می‌دهد. استاد راهنما، داوران و اعضای شورای تحصیلات تکمیلی از روی همین چند صفحه قضاوت می‌کنند که آیا مسئله را درست فهمیده‌اید، آیا ادبیات حوزه را می‌شناسید و آیا روش شما به نتیجه‌ی قابل‌اتکا می‌رسد. اگر این سند با کمک ابزار نوشته شود اما شما نتوانید از آن دفاع کنید، عملاً زمانی را که صرفه‌جویی کرده‌اید در جلسه‌ی دفاع از دست می‌دهید.

    در ادامه، مطالب در سه بخش اصلی سازمان‌دهی شده‌اند. بخش اول به چیستی پروپوزال و جایگاه هوش مصنوعی می‌پردازد. بخش دوم مراحل عملی را گام‌به‌گام شرح می‌دهد. و بخش سوم درباره‌ی بازبینی، پرامپت‌ها، خطاهای رایج و آمادگی برای دفاع است. می‌توانید مقاله را به ترتیب بخوانید یا مستقیم به بخشی بروید که اکنون درگیر آن هستید.

    پروپوزال چیست و هوش مصنوعی کجای آن کمک می‌کند؟

    پیش از اینکه سراغ ابزارها برویم، باید تصویر روشنی از خود پروپوزال داشته باشیم. پروپوزال یک سند استدلالی است؛ یعنی شما در آن ثابت می‌کنید که یک مسئله‌ی واقعی وجود دارد، پژوهش‌های قبلی آن را کامل حل نکرده‌اند و شما روشی معتبر برای پاسخ دادن به آن دارید. هوش مصنوعی می‌تواند در ساختن این استدلال کمک کند، اما نمی‌تواند جای فکر شما را بگیرد.

    ساختار پروپوزال و نقش دستیار در نوشتن پروپوزال با هوش مصنوعی
    ساختار پروپوزال و نقش دستیار در نوشتن پروپوزال با هوش مصنوعی

    اجزای اصلی یک پروپوزال استاندارد

    ساختار پروپوزال در دانشگاه‌های مختلف کمی متفاوت است، اما تقریباً همه‌ی فرم‌های پروپوزال در ایران و خارج از کشور این بخش‌ها را دارند:

    • عنوان: کوتاه، دقیق و دربردارنده‌ی متغیرها یا پدیده‌ی اصلی.
    • بیان مسئله: توضیح شکاف پژوهشی و اهمیت حل آن.
    • اهمیت و ضرورت تحقیق: چرا این پژوهش اکنون و در این زمینه لازم است.
    • پیشینه‌ی پژوهش: مرور انتقادی مطالعات داخلی و خارجی.
    • اهداف، سؤالات و فرضیه‌ها: هسته‌ی منطقی پژوهش.
    • روش تحقیق: جامعه، نمونه، ابزار، روش گردآوری و تحلیل داده.
    • جدول زمان‌بندی و منابع: برنامه‌ی اجرایی و فهرست مراجع.

    هر کدام از این بخش‌ها نوع متفاوتی از کمک را از هوش مصنوعی می‌طلبد. برای مثال، در بیان مسئله، هوش مصنوعی می‌تواند به شما کمک کند منطق استدلال را مرتب کنید؛ اما در پیشینه، خطر ساختن منابع جعلی جدی است و باید بسیار محتاط باشید.

    نکته‌ی مهم دیگر این است که پروپوزال یک «قرارداد علمی» میان شما، استاد راهنما و دانشگاه است. هرچه در پروپوزال تعهد بدهید، باید در پایان‌نامه انجام دهید. بنابراین اگر هوش مصنوعی روشی پیشنهاد کرد که شما توان اجرای آن را ندارید، آن پیشنهاد هرچقدر هم جذاب باشد، برای شما مناسب نیست.

    اگر هنوز با ساختار کلی آشنا نیستید، پیشنهاد می‌کنیم صفحه‌ی خدمات و آموزش نگارش پروپوزال را هم ببینید تا نمونه‌ی فرم‌ها و الزامات رایج را بشناسید.

    یک توصیه‌ی عملی دیگر: پیش از شروع نوشتن، فرم پروپوزال دانشگاه خود را دانلود کنید و عناوین آن را عیناً در یک سند جداگانه کپی کنید. سپس زیر هر عنوان، با چند جمله‌ی کوتاه و حتی شکسته بنویسید که فکر می‌کنید آنجا چه باید بیاید. این «اسکلت ذهنی» بعداً بهترین ورودی برای هوش مصنوعی است، چون ابزار به‌جای حدس زدن، روی ایده‌های واقعی شما کار می‌کند. دانشجویانی که با این اسکلت شروع می‌کنند، معمولاً در نصف زمان به پیش‌نویس قابل‌قبول می‌رسند.
    همچنین توجه کنید که برخی دانشگاه‌ها بخش‌هایی مثل «نوآوری پژوهش»، «کاربران نتایج» یا «جنبه‌ی کاربردی» را هم در فرم دارند. این بخش‌ها اغلب نادیده گرفته می‌شوند، در حالی که داوران به آن‌ها توجه زیادی دارند. هوش مصنوعی می‌تواند به شما کمک کند برای این بخش‌ها ذی‌نفعان واقعی پژوهش را فهرست کنید، اما مصداق‌ها باید از زمینه‌ی واقعی کار شما بیایند.

    نقش واقعی هوش مصنوعی: دستیار، نه نویسنده

    یکی از بزرگ‌ترین سوءبرداشت‌ها درباره‌ی نوشتن پروپوزال با هوش مصنوعی این است که فکر کنیم کافی است موضوع را به ChatGPT بدهیم و یک پروپوزال کامل تحویل بگیریم. خروجی چنین کاری معمولاً متنی روان، کلی و بی‌روح است که هر داور باتجربه‌ای در چند دقیقه متوجه سطحی بودن آن می‌شود.

    نقش درست هوش مصنوعی را می‌توان در چهار کارکرد خلاصه کرد:

    1. هم‌فکری و طوفان فکری: پیشنهاد زاویه‌های مختلف برای یک موضوع، طرح پرسش‌های انتقادی و شناسایی متغیرهای احتمالی.
    2. سازمان‌دهی: تبدیل یادداشت‌های پراکنده‌ی شما به یک طرح منطقی و پیشنهاد ترتیب بخش‌ها.
    3. بازخورد: نقد پیش‌نویس شما از نگاه یک داور، یافتن ابهام‌ها و تناقض‌ها.
    4. ویرایش زبانی: روان‌سازی جملات، یکدست کردن اصطلاحات و ترجمه‌ی دقیق‌تر عبارات تخصصی.

    در همه‌ی این کارکردها، محتوای علمی از شما می‌آید: مسئله‌ای که در میدان دیده‌اید، مقالاتی که واقعاً خوانده‌اید و روشی که با استاد راهنما توافق کرده‌اید. هوش مصنوعی فقط به این محتوا شکل بهتر می‌دهد.

    قاعده‌ی طلایی: هر ادعای علمی در پروپوزال باید به منبعی برسد که خودتان دیده و خوانده‌اید، نه به جمله‌ای که هوش مصنوعی گفته است.

    برای آشنایی بیشتر با جایگاه این ابزارها در کل چرخه‌ی پژوهش، صفحه‌ی هوش مصنوعی در پژوهش را ببینید. همچنین در مقاله‌ی بهترین هوش مصنوعی برای پژوهش ابزارهای مختلف را بر اساس نوع کار مقایسه کرده‌ایم.

    برای روشن‌تر شدن تفاوت، دو سناریو را مقایسه کنید. در سناریوی اول، دانشجو موضوع را به ابزار می‌دهد، متن کامل بیان مسئله را می‌گیرد و آن را با کمی تغییر در فرم قرار می‌دهد. در سناریوی دوم، دانشجو ابتدا ده مقاله‌ی کلیدی را می‌خواند، یادداشت‌برداری می‌کند، پیش‌نویس ناقص خود را می‌نویسد و سپس از ابزار می‌خواهد ضعف‌های استدلال را نشان دهد و جملات را روان کند. هر دو از هوش مصنوعی استفاده کرده‌اند، اما فقط در سناریوی دوم پروپوزال واقعاً متعلق به دانشجوست و در جلسه‌ی دفاع هم قابل‌دفاع است.

    مرزهای اخلاقی و قوانین دانشگاه‌ها

    استفاده از هوش مصنوعی در پروپوزال، اگر شفاف و مسئولانه باشد، تخلف محسوب نمی‌شود. اما مرز میان «استفاده‌ی کمکی» و «سپردن کار به ماشین» باید روشن باشد. بسیاری از دانشگاه‌ها و ناشران بین‌المللی اکنون سیاست مشخصی درباره‌ی هوش مصنوعی مولد دارند.

    برای مثال، کمیته‌ی اخلاق نشر (COPE) صراحتاً اعلام کرده است که ابزارهای هوش مصنوعی نمی‌توانند نویسنده محسوب شوند، چون نمی‌توانند مسئولیت محتوا را بپذیرند. توصیه‌نامه‌ی ICMJE نیز از نویسندگان می‌خواهد نحوه‌ی استفاده از این ابزارها را شفاف اعلام کنند. هرچند این اسناد بیشتر برای مقاله نوشته شده‌اند، منطق آن‌ها برای پروپوزال هم صادق است.

    چند اصل عملی که پیشنهاد می‌کنیم رعایت کنید:

    • پیش از شروع، آیین‌نامه‌ی دانشگاه یا دانشکده‌ی خود را درباره‌ی هوش مصنوعی بخوانید.
    • با استاد راهنما درباره‌ی میزان و نوع استفاده صحبت کنید و توافق کنید.
    • داده‌های محرمانه، اطلاعات شرکت‌کنندگان یا ایده‌های منتشرنشده‌ی دیگران را در ابزارهای عمومی وارد نکنید.
    • یک «دفترچه‌ی استفاده از هوش مصنوعی» داشته باشید و پرامپت‌ها و خروجی‌های مهم را ثبت کنید.
    • در صورت لزوم، در بخش روش یا پیوست، استفاده از ابزار را اعلام کنید.

    وارد کردن متن کامل پرسشنامه‌ها، داده‌های خام یا اطلاعات هویتی شرکت‌کنندگان در چت‌بات‌های عمومی ممکن است با اصول محرمانگی و کدهای اخلاق پژوهش در تعارض باشد. پیش از هر بارگذاری، تنظیمات حریم خصوصی ابزار را بررسی کنید.

    برای جزئیات بیشتر درباره‌ی نحوه‌ی اعلام استفاده از این ابزارها، مقاله‌ی استفاده از ChatGPT در مقاله را بخوانید و صفحه‌ی صداقت علمی و اخلاق پژوهش را هم از دست ندهید.

    به یاد داشته باشید که اخلاق پژوهش فقط درباره‌ی پرهیز از سرقت علمی نیست؛ شفافیت، احترام به حقوق شرکت‌کنندگان و صداقت در گزارش محدودیت‌ها هم بخشی از آن است. هوش مصنوعی اگر درست به کار رود، می‌تواند به شما در رعایت همین اصول کمک کند؛ برای مثال با یادآوری اینکه فرم رضایت آگاهانه را پیوست کنید یا محدودیت‌های تعمیم‌پذیری را در روش تحقیق ذکر کنید.

    گام‌به‌گام نوشتن پروپوزال با هوش مصنوعی

    حالا که چارچوب اخلاقی روشن شد، وارد بخش عملی می‌شویم. در این بخش، فرایند نوشتن پروپوزال با هوش مصنوعی را در سه گام اصلی مرور می‌کنیم: از ایده تا بیان مسئله، از جست‌وجوی منابع تا پیشینه، و از سؤالات پژوهش تا طراحی روش. در هر گام می‌گوییم چه کاری را به ابزار بسپارید و چه کاری را حتماً خودتان انجام دهید.

    مراحل نوشتن پروپوزال با هوش مصنوعی از ایده تا روش تحقیق
    مراحل نوشتن پروپوزال با هوش مصنوعی از ایده تا روش تحقیق

    گام اول: انتخاب موضوع و نگارش بیان مسئله

    انتخاب موضوع، سخت‌ترین و مهم‌ترین تصمیم پژوهشی شماست. هوش مصنوعی در این مرحله می‌تواند یک هم‌فکر خوب باشد، به شرطی که ورودی کافی به آن بدهید. به‌جای اینکه بنویسید «یک موضوع پایان‌نامه در مدیریت بده»، اطلاعات زمینه‌ای را ارائه کنید: رشته، گرایش، علاقه‌های شما، دسترسی‌تان به داده، محدودیت زمانی و روش‌هایی که به آن‌ها مسلط هستید.

    یک پرامپت نمونه برای این مرحله:

    «من دانشجوی کارشناسی ارشد مدیریت منابع انسانی هستم، به موضوع فرسودگی شغلی پرستاران علاقه دارم و به دو بیمارستان دولتی دسترسی دارم. با روش پیمایشی و تحلیل رگرسیون آشنا هستم. پنج زاویه‌ی پژوهشی پیشنهاد بده و برای هر کدام توضیح بده چه شکافی ممکن است وجود داشته باشد. منبع نساز؛ فقط ایده و پرسش بده.»

    توجه کنید که در انتهای پرامپت صراحتاً گفته‌ایم منبع نسازد. این کار احتمال تولید ارجاعات خیالی را کم می‌کند. سپس هر ایده را خودتان در Google Scholar و پایگاه‌های داخلی بررسی کنید تا ببینید آیا واقعاً شکافی وجود دارد یا موضوع اشباع شده است.

    برای نوشتن بیان مسئله، یک ساختار سه‌مرحله‌ای پیشنهاد می‌کنیم که هوش مصنوعی می‌تواند در مرتب‌کردن آن کمک کند:

    1. وضعیت موجود: شواهد و آمار درباره‌ی اهمیت پدیده (از منابع واقعی).
    2. شکاف: آنچه پژوهش‌های قبلی نگفته‌اند یا متناقض گفته‌اند.
    3. پیامد: اگر این شکاف پر نشود چه اتفاقی می‌افتد و پژوهش شما چه کمکی می‌کند.

    ابتدا پیش‌نویس خام بیان مسئله را خودتان با همین سه بخش بنویسید، حتی اگر ناقص و ناهموار باشد. سپس از هوش مصنوعی بخواهید آن را نقد کند: «این بیان مسئله را از دید یک داور سخت‌گیر بررسی کن و بگو کجا استدلال ضعیف است.» این روش، هم اصالت متن را حفظ می‌کند و هم کیفیت آن را بالا می‌برد.

    بیان مسئله‌ی خوب معمولاً بین ۶۰۰ تا ۱۲۰۰ کلمه است و با یک جمله‌ی روشن درباره‌ی «مسئله‌ی اصلی» تمام می‌شود. از هوش مصنوعی بخواهید سه نسخه‌ی مختلف از این جمله‌ی پایانی پیشنهاد دهد و شما بهترین را انتخاب و بازنویسی کنید.

    یک نکته‌ی دیگر در انتخاب موضوع، توجه به اولویت‌های پژوهشی دانشگاه و سازمان‌های حامی است. بسیاری از دانشگاه‌ها فهرستی از اولویت‌های پژوهشی منتشر می‌کنند و پروپوزال‌هایی که با این اولویت‌ها هم‌راستا باشند، شانس بیشتری برای تصویب یا حتی دریافت حمایت مالی دارند. می‌توانید فهرست اولویت‌ها را به هوش مصنوعی بدهید و بخواهید ارتباط ایده‌های شما را با آن‌ها تحلیل کند. همچنین معیار «FINER» را به یاد داشته باشید: موضوع باید امکان‌پذیر (Feasible)، جالب (Interesting)، نو (Novel)، اخلاقی (Ethical) و مرتبط (Relevant) باشد. از هوش مصنوعی بخواهید هر ایده را با این پنج معیار امتیازدهی کند و دلیل هر امتیاز را بنویسد؛ سپس خودتان این امتیازها را با واقعیت دسترسی و زمانتان مقایسه کنید.

    گام دوم: جست‌وجوی منابع و نگارش پیشینه‌ی پژوهش

    پیشینه‌ی پژوهش جایی است که بیشترین خطا در استفاده از هوش مصنوعی رخ می‌دهد. مدل‌های زبانی عمومی ممکن است مقالاتی با عنوان، نویسنده و سال کاملاً معقول تولید کنند که اصلاً وجود ندارند. این پدیده که به آن «توهم» یا Hallucination می‌گویند، می‌تواند اعتبار کل پروپوزال شما را از بین ببرد.

    راه درست این است که برای پیدا کردن منابع از ابزارهای مبتنی بر پایگاه‌های داده‌ی واقعی استفاده کنید. ابزارهایی مثل Elicit، Consensus و SciSpace مقالات را از پایگاه‌هایی مانند Semantic Scholar بازیابی می‌کنند و لینک مقاله‌ی اصلی را نشان می‌دهند. مقایسه‌ی دقیق این سه ابزار را در مقاله‌ی مقایسه Elicit و Consensus و SciSpace آورده‌ایم.

    یک جریان کاری پیشنهادی برای پیشینه:

    • با کلیدواژه‌های اصلی در Google Scholar، Scopus یا پایگاه‌های داخلی مثل SID و Magiran جست‌وجو کنید.
    • از ابزارهایی مثل Elicit برای یافتن مقالات مرتبط‌تر و استخراج سریع روش و یافته‌ها کمک بگیرید.
    • PDF مقالات کلیدی را دانلود کنید و در ابزاری مثل NotebookLM بارگذاری کنید تا بتوانید با منابع خودتان گفت‌وگو کنید.
    • یک ماتریس مرور ادبیات بسازید: نویسنده، سال، هدف، روش، نمونه، یافته‌ی اصلی، محدودیت.
    • بر اساس ماتریس، الگوها، تناقض‌ها و شکاف‌ها را شناسایی کنید.

    نکته‌ی کلیدی این است که پیشینه نباید فهرستی از خلاصه‌ها باشد. داوران دنبال «سنتز» هستند؛ یعنی می‌خواهند ببینند شما مطالعات را با هم مقایسه کرده‌اید و به یک نتیجه‌ی انتقادی رسیده‌اید. هوش مصنوعی می‌تواند در یافتن الگوها در ماتریس شما کمک کند، اما داوری نهایی باید از خودتان باشد.

    اگر می‌خواهید با NotebookLM کار کنید، آموزش کامل آن را در مقاله‌ی NotebookLM برای پژوهش ببینید. برای یادگیری اصولی مرور ادبیات هم صفحه‌ی مرور ادبیات را پیشنهاد می‌کنیم.

    هرگز ارجاعی را که هوش مصنوعی عمومی پیشنهاد داده، بدون یافتن نسخه‌ی اصلی مقاله و بررسی DOI آن در فهرست منابع نگذارید. یک منبع جعلی کافی است تا داور به کل پروپوزال بی‌اعتماد شود.

    برای مدیریت منابع هم از همان ابتدا یک نرم‌افزار مدیریت مرجع مثل Zotero یا Mendeley به کار بگیرید. این ابزارها فهرست منابع را به‌صورت خودکار با سبک‌های مختلف تنظیم می‌کنند و خطر اشتباه در ارجاع‌دهی را کم می‌کنند. ترکیب یک ابزار مدیریت مرجع با ابزارهای هوش مصنوعی مبتنی بر منبع، یکی از کارآمدترین جریان‌های کاری برای نوشتن پیشینه است. حتی می‌توانید یادداشت‌های خود را در Zotero ذخیره کنید و بعداً همان یادداشت‌ها را برای سنتز به ابزار بدهید.

    گام سوم: اهداف، سؤالات، فرضیه‌ها و روش تحقیق

    پس از مشخص شدن شکاف پژوهشی، نوبت به تدوین اهداف و سؤالات می‌رسد. این بخش باید با بیان مسئله هم‌راستا باشد؛ یعنی هر سؤال پژوهشی باید مستقیماً به بخشی از شکاف پاسخ دهد. هوش مصنوعی در بررسی همین هم‌راستایی بسیار مفید است.

    پرامپت نمونه:

    «این بیان مسئله، هدف کلی و سه سؤال پژوهشی من است. بررسی کن آیا هر سؤال به شکاف مطرح‌شده پاسخ می‌دهد، آیا سؤال‌ها قابل‌سنجش هستند و آیا میان هدف و سؤال‌ها ناسازگاری وجود دارد. پیشنهادهای اصلاحی را با دلیل بنویس.»

    برای فرضیه‌ها، دقت کنید که فرضیه باید جهت‌دار یا بی‌جهت، قابل‌آزمون و مبتنی بر چارچوب نظری باشد. هوش مصنوعی می‌تواند نسخه‌های مختلف فرمول‌بندی را پیشنهاد دهد، اما مبنای نظری فرضیه باید از پیشینه‌ای بیاید که خودتان نوشته‌اید.

    در بخش روش تحقیق، هوش مصنوعی می‌تواند به این پرسش‌ها پاسخ اولیه بدهد:

    • برای این نوع سؤال، چه طرح پژوهشی (پیمایشی، آزمایشی، کیفی، ترکیبی) مناسب‌تر است؟
    • حجم نمونه را با چه روشی می‌توان برآورد کرد (فرمول کوکران، G*Power و…)؟
    • برای سنجش متغیرها چه پرسشنامه‌های استانداردی وجود دارد؟
    • چه آزمون‌های آماری با نوع داده و سؤال‌ها سازگار است؟

    اما توجه کنید که پاسخ‌های هوش مصنوعی درباره‌ی پرسشنامه‌ها و روایی و پایایی آن‌ها باید حتماً با منبع اصلی تطبیق داده شود. گاهی مدل‌ها ضریب آلفای کرونباخ یا تعداد گویه‌ها را اشتباه می‌گویند. برای انتخاب آزمون آماری هم بهتر است با یک مشاور آمار یا استاد مشورت کنید؛ صفحه‌ی تحلیل آماری ریسرچ اینتل در این زمینه راهنمای مفیدی است و در مقاله‌ی تحلیل SPSS با ChatGPT هم نشان داده‌ایم بعدها چطور خروجی‌ها را تفسیر کنید.

    یکی از کارهای ارزشمندی که هوش مصنوعی در این مرحله انجام می‌دهد، ساختن «جدول هم‌راستایی» است: ستونی برای هدف، ستونی برای سؤال، ستونی برای فرضیه، ستونی برای متغیر و ستونی برای آزمون آماری. این جدول به شما و استاد راهنما کمک می‌کند در یک نگاه ببینید آیا طرح پژوهش منسجم است یا نه.

    در نهایت، بخش جدول زمان‌بندی را دست‌کم نگیرید. از هوش مصنوعی بخواهید با توجه به مراحل پژوهش شما (مرور ادبیات، طراحی ابزار، گردآوری داده، تحلیل، نگارش) یک برنامه‌ی زمانی واقع‌بینانه پیشنهاد دهد و سپس آن را با تقویم آموزشی دانشگاه و زمان‌های در دسترس خودتان تطبیق دهید. یک جدول زمان‌بندی واقع‌بینانه نشان می‌دهد که شما ابعاد اجرایی پژوهش را جدی گرفته‌اید و این برای داوران نشانه‌ی پختگی پژوهشی است. همچنین برای هر مرحله، یک «حاشیه‌ی اطمینان» زمانی در نظر بگیرید، چون گردآوری داده تقریباً همیشه بیش از برنامه طول می‌کشد.

    مطالعهٔ تکمیلی: اگر می‌خواهید این موضوع را عمیق‌تر و بر پایهٔ یک منبع معتبر دانشگاهی دنبال کنید، راهنماهای طراحی پژوهش با هوش مصنوعی، اخلاق هوش مصنوعی در پژوهش و هوش مصنوعی در پژوهش دانشگاهی را هم در ریسرچ اینتل بخوانید.

    بازبینی، اعتبارسنجی و آماده‌سازی برای دفاع

    نوشتن پیش‌نویس فقط نیمی از کار است. نیمه‌ی دوم، بازبینی دقیق، کنترل منابع، رفع خطاهای رایج و آماده شدن برای جلسه‌ی دفاع از پروپوزال است. در این بخش، پرامپت‌های آماده، اشتباهات پرتکرار و یک چک‌لیست نهایی را با هم مرور می‌کنیم.

    چک‌لیست بازبینی پس از نوشتن پروپوزال با هوش مصنوعی
    چک‌لیست بازبینی پس از نوشتن پروپوزال با هوش مصنوعی

    پرامپت‌های کاربردی برای هر بخش پروپوزال

    کیفیت خروجی هوش مصنوعی مستقیماً به کیفیت پرامپت شما بستگی دارد. پرامپت خوب چهار جزء دارد: نقش، زمینه، وظیفه و قالب خروجی. در ادامه چند پرامپت آزموده‌شده را می‌بینید که می‌توانید آن‌ها را بر اساس رشته‌ی خود تنظیم کنید:

    • برای عنوان: «نقش تو یک استاد راهنمای باتجربه است. این عنوان پروپوزال من است. پنج نسخه‌ی کوتاه‌تر و دقیق‌تر پیشنهاد بده که متغیرها، جامعه و روش در آن مشخص باشد.»
    • برای اهمیت و ضرورت: «این پاراگراف اهمیت تحقیق من است. بگو کدام جمله‌ها کلی و شعاری هستند و چطور می‌توانم آن‌ها را با شواهد مشخص جایگزین کنم.»
    • برای پیشینه: «این ماتریس مرور ادبیات من است. الگوهای مشترک، تناقض‌ها و شکاف‌های روش‌شناختی را شناسایی کن. هیچ منبع جدیدی اضافه نکن.»
    • برای روش: «با توجه به این سؤال‌ها و نوع داده‌ها، نقاط ضعف احتمالی روش من را از نگاه یک داور بگو.»
    • برای ویرایش: «این متن را از نظر نگارشی ویرایش کن، اصطلاحات را یکدست کن، اما محتوا و ادعاها را تغییر نده.»

    پرامپت‌های بیشتر و دسته‌بندی‌شده برای هر مرحله‌ی پژوهش را در بانک پرامپت‌های پژوهشی ریسرچ اینتل پیدا می‌کنید. این پرامپت‌ها با رویکرد استفاده‌ی مسئولانه طراحی شده‌اند.

    یک نکته‌ی کاربردی دیگر: مکالمه را در یک رشته‌ی واحد ادامه دهید تا مدل زمینه‌ی پژوهش شما را به خاطر بسپارد، اما هر از گاهی یک خلاصه‌ی به‌روز از پروژه به آن بدهید. مدل‌ها در گفت‌وگوهای طولانی ممکن است جزئیات اولیه را فراموش کنند یا با هم قاطی کنند.

    اگر به نسخه‌ی پیشرفته‌ی ابزارها نیاز دارید، مثلاً برای بارگذاری فایل‌های بلند یا استفاده از مدل‌های قوی‌تر، صفحه‌ی خرید اکانت هوش مصنوعی گزینه‌های موجود را معرفی کرده است. البته برای بیشتر مراحل پروپوزال، نسخه‌های رایگان هم کافی هستند.

    یک روش مؤثر دیگر، ساختن یک «پرامپت مادر» است: یک متن نیم‌صفحه‌ای که رشته، موضوع، سؤالات، روش و سبک نگارشی موردنظر شما را خلاصه می‌کند. هر بار که گفت‌وگوی جدیدی شروع می‌کنید، ابتدا این متن را وارد کنید تا ابزار با زمینه‌ی کامل کار کند. این کار هم کیفیت پاسخ‌ها را بالا می‌برد و هم یکدستی لحن را در بخش‌های مختلف پروپوزال حفظ می‌کند. همچنین از ابزار بخواهید در پایان هر پاسخ، فرض‌هایی را که درباره‌ی پژوهش شما کرده فهرست کند تا اگر جایی اشتباه برداشت کرده، زود متوجه شوید.

    خطاهای رایج در نوشتن پروپوزال با هوش مصنوعی

    در تجربه‌ی مشاوره با صدها دانشجو، چند خطا را بارها دیده‌ایم که می‌تواند پروپوزال را در جلسه‌ی شورای گروه رد کند:

    1. متن کلی و بدون زمینه: هوش مصنوعی وقتی اطلاعات کافی نداشته باشد، جملاتی کلی می‌نویسد که درباره‌ی هر کشوری و هر سازمانی صدق می‌کند. داور فوراً متوجه می‌شود.
    2. ارجاعات جعلی یا نادرست: همان‌طور که گفتیم، این خطرناک‌ترین خطاست.
    3. ناهماهنگی میان بخش‌ها: وقتی هر بخش را جدا از هوش مصنوعی بگیرید، ممکن است متغیرها در بیان مسئله با فرضیه‌ها یکی نباشند.
    4. روش غیرقابل‌اجرا: پیشنهاد روش‌های پیچیده که شما امکان اجرای آن را ندارید.
    5. لحن غیرعلمی یا اغراق‌آمیز: عباراتی مثل «انقلابی»، «بی‌نظیر» یا «برای اولین بار در جهان» که هوش مصنوعی گاهی به کار می‌برد.
    6. کپی مستقیم خروجی: که هم احتمال شناسایی شدن در نرم‌افزارهای تشخیص متن ماشینی را بالا می‌برد و هم با اخلاق پژوهش سازگار نیست.

    برای جلوگیری از این خطاها، یک روش ساده پیشنهاد می‌کنیم: هر خروجی هوش مصنوعی را «مواد خام» بدانید، نه «متن نهایی». آن را بخوانید، با منابع تطبیق دهید، با لحن خودتان بازنویسی کنید و فقط بخش‌هایی را نگه دارید که واقعاً از آن‌ها دفاع می‌کنید.

    یادتان باشد که در جلسه‌ی دفاع از پروپوزال، از شما درباره‌ی دلیل انتخاب هر روش، هر متغیر و هر منبع سؤال می‌شود. اگر بخشی را خودتان نفهمیده‌اید، دفاع از آن تقریباً غیرممکن است.

    در ادامه‌ی مسیر، وقتی پروپوزال تصویب شد، می‌توانید از همین رویکرد برای نوشتن فصل‌های پایان‌نامه استفاده کنید. راهنمای کامل آن را در مقاله‌ی نوشتن پایان‌نامه با هوش مصنوعی آورده‌ایم.

    خطای دیگری که کمتر به آن توجه می‌شود، «وابستگی بیش از حد» است. برخی دانشجویان آن‌قدر به هوش مصنوعی تکیه می‌کنند که مهارت نوشتن و استدلال خودشان رشد نمی‌کند. این مسئله در مراحل بعدی، یعنی نوشتن پایان‌نامه و مقاله، مشکل‌ساز می‌شود. پیشنهاد ما این است که دست‌کم یک پیش‌نویس کامل از هر بخش را بدون کمک ابزار بنویسید و فقط برای بازبینی و بهبود از آن استفاده کنید. این تمرین در کوتاه‌مدت کمی وقت‌گیر است، اما در بلندمدت شما را به پژوهشگری مستقل تبدیل می‌کند.

    همچنین مراقب «یکدستی بیش از حد» متن باشید. متن‌هایی که تماماً با هوش مصنوعی صیقل داده می‌شوند، اغلب جملات هم‌طول، واژگان تکراری و ساختارهای قالبی دارند. خواندن متن با صدای بلند و حذف عبارات کلیشه‌ای، کمک می‌کند لحن طبیعی و شخصی شما حفظ شود.

    چک‌لیست نهایی و آمادگی برای جلسه‌ی دفاع

    پیش از ارسال پروپوزال برای استاد راهنما یا شورای تحصیلات تکمیلی، این چک‌لیست را مرور کنید:

    • آیا عنوان، بیان مسئله، اهداف، سؤالات و فرضیه‌ها کاملاً هم‌راستا هستند؟
    • آیا همه‌ی منابع واقعی هستند، DOI یا لینک معتبر دارند و با سبک ارجاع‌دهی دانشگاه (مثلاً APA) تنظیم شده‌اند؟
    • آیا پیشینه سنتز انتقادی دارد یا فقط فهرستی از خلاصه‌هاست؟
    • آیا روش تحقیق با منابع، زمان و مهارت‌های شما قابل‌اجراست؟
    • آیا ملاحظات اخلاقی (رضایت آگاهانه، محرمانگی، کد اخلاق) ذکر شده است؟
    • آیا متن را با صدای خودتان بازنویسی کرده‌اید و می‌توانید از هر جمله دفاع کنید؟
    • آیا نحوه‌ی استفاده از هوش مصنوعی را با استاد راهنما هماهنگ و در صورت لزوم اعلام کرده‌اید؟

    برای آمادگی دفاع، یک تمرین مفید این است که از هوش مصنوعی بخواهید نقش داور را بازی کند: «تو عضو شورای گروه هستی. ده سؤال چالشی درباره‌ی این پروپوزال بپرس.» سپس به سؤال‌ها بدون کمک ابزار پاسخ دهید و پاسخ‌هایتان را با استاد راهنما مرور کنید. این تمرین اعتمادبه‌نفس شما را در جلسه بسیار بالا می‌برد.

    همچنین یک ارائه‌ی کوتاه ده‌دقیقه‌ای آماده کنید که شامل مسئله، شکاف، سؤالات، روش و زمان‌بندی باشد. هوش مصنوعی می‌تواند در خلاصه‌سازی محتوا برای اسلایدها کمک کند، اما اسلایدها باید ساده، خوانا و متکی به داده‌های واقعی باشند.

    اگر برای اپلای خارج از کشور پروپوزال می‌نویسید، معمولاً با یک «Research Proposal» دو تا پنج صفحه‌ای سروکار دارید که ساختار فشرده‌تری دارد. در این حالت، هماهنگی پروپوزال با رزومه و سوابق پژوهشی شما اهمیت زیادی دارد؛ صفحه‌ی رزومه دکتری در این زمینه کمک‌کننده است.

    یک نکته‌ی پایانی درباره‌ی بازخورد استاد راهنما: وقتی استاد پیشنهاد اصلاحی می‌دهد، آن را به‌صورت دقیق یادداشت کنید و اگر لازم بود، از هوش مصنوعی برای فهم بهتر منظور او کمک بگیرید؛ مثلاً بپرسید «منظور از تقویت چارچوب نظری در این بیان مسئله چیست و چه گزینه‌هایی دارم؟» اما تصمیم نهایی درباره‌ی نحوه‌ی اعمال اصلاحات باید با هماهنگی خود استاد گرفته شود. این تعامل سه‌جانبه میان شما، استاد و ابزار، بهترین نتیجه را به همراه دارد.

    نسخه‌های مختلف پروپوزال را هم با نام و تاریخ ذخیره کنید. این کار به شما اجازه می‌دهد تغییرات را پیگیری کنید و اگر استاد خواست به نسخه‌ی قبلی برگردید، کارتان راحت باشد. در کنار آن، فایل پرامپت‌ها و خروجی‌های مهم را هم نگه دارید تا در صورت نیاز بتوانید نحوه‌ی استفاده از هوش مصنوعی را شفاف توضیح دهید.

    جمع‌بندی: نوشتن پروپوزال با هوش مصنوعی وقتی موفق است که شما فرمان را در دست داشته باشید. از ابزار برای ایده‌پردازی، سازمان‌دهی، نقد و ویرایش استفاده کنید؛ منابع را خودتان پیدا و بررسی کنید؛ و هر جمله را با صدای خودتان بازنویسی کنید. اگر به همراهی تخصصی نیاز دارید، مشاوره پژوهشی ریسرچ اینتل و برنامه‌ی هفته پژوهش فرصت‌های خوبی برای یادگیری عملی هستند. پس از تصویب پروپوزال، قدم بعدی شما نوشتن مقاله است؛ راهنمای مقاله‌نویسی علمی با هوش مصنوعی را برای ادامه‌ی مسیر بخوانید و برای مراحل نهایی، صفحه‌ی انتشار مقاله و راهنمای PRISMA برای مرورهای نظام‌مند را در نظر داشته باشید.