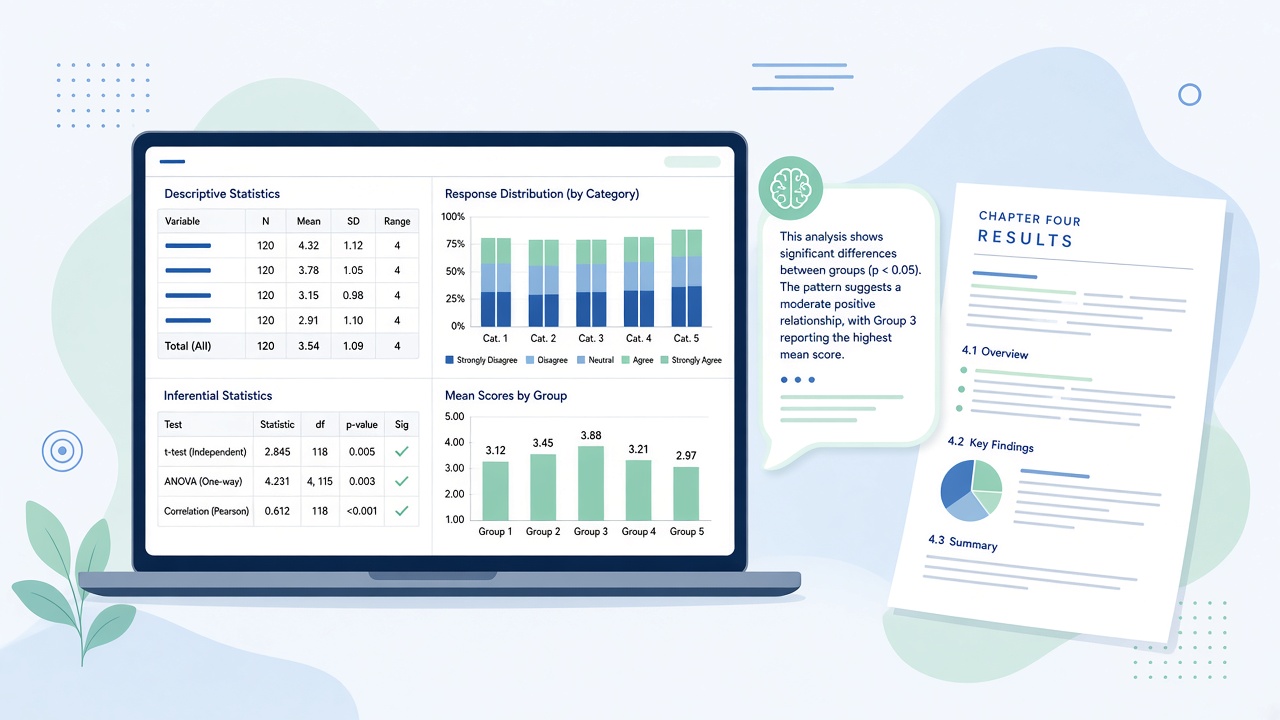
تحلیل SPSS با ChatGPT یکی از پرجستوجوترین موضوعات میان دانشجویان کارشناسی ارشد و دکتری است، بهویژه وقتی به فصل چهارم پایاننامه میرسند. دادهها جمع شده، در SPSS وارد شده و آزمونها اجرا شدهاند؛ اما حالا با صفحهای پر از جدول، عدد و اصطلاحاتی مثل Sig.، Beta، Levene و Durbin-Watson روبهرو هستید و نمیدانید کدام عدد را گزارش کنید، چگونه تفسیر کنید و چطور آن را به متنی علمی و منسجم تبدیل کنید.
ChatGPT و ابزارهای مشابه میتوانند در این مرحله کمک بزرگی باشند. آنها میتوانند معنای هر جدول را توضیح دهند، بگویند کدام مقادیر مهماند، پیشفرضهای آزمون را یادآوری کنند و به شما کمک کنند گزارش را مطابق سبک APA بنویسید. اما همین ابزارها، اگر نادرست استفاده شوند، میتوانند اعداد را اشتباه بازنویسی کنند، آزمون نامناسب پیشنهاد دهند یا تفسیری فراتر از دادهها ارائه کنند. و از همه مهمتر: هرگز نباید برای ساختن یا تغییر نتایج به کار روند.
در این راهنما، ابتدا میگوییم ChatGPT در تحلیل آماری چه کاری میتواند و چه کاری نمیتواند انجام دهد، چگونه خروجی را آماده و بینامسازی کنید و ساختار استاندارد فصل چهارم چیست. سپس تفسیر رایجترین خروجیهای SPSS را با مثال مرور میکنیم: آمار توصیفی، نرمال بودن، پایایی، همبستگی، آزمون t، تحلیل واریانس و رگرسیون. در نهایت، نحوهی نگارش متن فصل چهارم به سبک APA، پرامپتهای آماده و خطاهای رایج و اخلاقی را بررسی میکنیم.
ChatGPT جایگزین نرمافزار آماری، استاد راهنما یا مشاور آمار نیست. انتخاب آزمون، اجرای تحلیل و تصمیمگیری دربارهی نتایج باید بر اساس طرح پژوهش و با نظارت متخصص انجام شود. نقش ابزار، کمک به «فهم» و «نگارش» است.
چرا فصل چهارم برای بسیاری از دانشجویان اینقدر دشوار است؟ دلیل اصلی این است که آموزش آمار در بسیاری از دورهها بیشتر بر «اجرای آزمون» تمرکز دارد تا «تفسیر و گزارش». دانشجو یاد میگیرد در کدام منو کلیک کند، اما وقتی خروجی را میبیند، نمیداند کدام عدد اهمیت دارد و چگونه آن را به زبان علمی بیان کند. ChatGPT میتواند دقیقاً همین فاصله را پر کند: نقش یک معلم صبور را بازی کند که هر جدول را بارها و به زبان ساده توضیح میدهد تا خودتان به فهم برسید. اگر با این نگاه از ابزار استفاده کنید، نهتنها فصل چهارم را بهتر مینویسید، بلکه در جلسهی دفاع هم با اطمینان بیشتری به سؤالات آماری پاسخ میدهید.
پیش از شروع: نقش ChatGPT، آمادهسازی خروجی و ساختار فصل چهارم
پیش از اینکه اولین جدول خروجی را به ChatGPT بدهید، سه موضوع را روشن کنید: انتظارات واقعبینانه از ابزار، نحوهی آمادهسازی و بینامسازی خروجیها و ساختار کلی فصلی که قرار است بنویسید. این آمادگی، کیفیت کمک ابزار را چند برابر میکند و از خطاهای پرهزینه جلوگیری میکند.
ChatGPT در تحلیل آماری چه میکند و چه نمیکند؟
برای استفادهی درست، باید بدانیم ابزار در کجا قوی و در کجا ضعیف است.
کارهایی که ChatGPT بهخوبی انجام میدهد:
- توضیح معنای هر ستون و ردیف جدولهای خروجی SPSS به زبان ساده
- یادآوری پیشفرضهای هر آزمون و نحوهی بررسی آنها
- پیشنهاد اینکه کدام مقادیر باید در متن گزارش شوند
- کمک در نوشتن جملههای گزارش آماری مطابق سبک APA
- توضیح تفاوت مفاهیمی مثل معناداری آماری و اندازهی اثر
- کمک در نوشتن Syntax یا راهنمایی در منوهای SPSS
- بررسی سازگاری میان فرضیه، آزمون و نتیجهگیری
کارهایی که ChatGPT نباید انجام دهد یا در آنها ضعیف است:
- محاسبهی دستی آمارهها: مدلهای زبانی در محاسبات عددی خطا میکنند؛ محاسبه را به SPSS بسپارید.
- انتخاب قطعی آزمون بدون شناخت طرح پژوهش: ممکن است آزمونی پیشنهاد دهد که با نوع داده یا طرح شما سازگار نیست.
- تفسیر علّی از دادههای همبستگی: گاهی زبان علّی به کار میبرد که با طرح شما سازگار نیست.
- ساختن یا «بهتر کردن» نتایج: این کار جعل داده است و تخلف جدی پژوهشی محسوب میشود.
قاعدهی کلیدی: اعداد از SPSS میآیند، تفسیر از دانش شما و استاد، و ChatGPT فقط به فهم و نگارش کمک میکند.
اگر از نسخههایی از ChatGPT استفاده میکنید که قابلیت اجرای کد و تحلیل داده دارند، ممکن است وسوسه شوید تحلیل را مستقیماً در خود ابزار انجام دهید. این کار برای بررسیهای اکتشافی یا تطبیق نتایج میتواند مفید باشد، اما برای پایاننامه معمولاً باید تحلیل اصلی را در نرمافزار مورد تأیید گروه (مانند SPSS) انجام دهید و خروجی آن را مستند کنید.
یک توصیهی مهم دیگر: پیش از کمک گرفتن از ChatGPT، راهنمای رسمی نرمافزار را هم در نظر داشته باشید. مستندات رسمی IBM SPSS Statistics توضیح دقیق هر رویه، گزینهها و جدولهای خروجی را ارائه میدهد. اگر توضیح ChatGPT دربارهی یک ستون یا گزینه با مستندات رسمی تفاوت داشت، مستندات رسمی معتبر است. همچنین نسخهی SPSS را که استفاده میکنید در پرامپت ذکر کنید، چون برخی جدولها و گزینهها در نسخههای مختلف تفاوت دارند.
آمادهسازی خروجی و بینامسازی دادهها
برای اینکه ChatGPT خروجی را درست تفسیر کند، باید آن را در قالب مناسب به ابزار بدهید. سه روش رایج:
- کپی متنی جدول: در Output Viewer روی جدول کلیک راست کنید، آن را کپی کنید و در پنجرهی گفتوگو بچسبانید. معمولاً ساختار جدول تا حد زیادی حفظ میشود.
- خروجی گرفتن: از منوی Export، خروجی را به Word، Excel یا PDF تبدیل کنید و جدولهای موردنظر را جدا کنید.
- تصویر جدول: در ابزارهایی که تصویر را میپذیرند، میتوانید تصویر جدول را بارگذاری کنید. اما دقت کنید که خواندن اعداد از تصویر ممکن است خطا داشته باشد؛ اعداد کلیدی را دوباره بررسی کنید.
بینامسازی: هرگز فایل دادهی خام (.sav) شامل اطلاعات هویتی شرکتکنندگان را در ابزارهای عمومی بارگذاری نکنید. جدولهای خروجی آماری معمولاً اطلاعات هویتی ندارند و برای تفسیر کافیاند. اگر لازم است دادهی خام را بارگذاری کنید، ابتدا همهی متغیرهای هویتی (نام، شمارهی تماس، کد ملی، شمارهی پرونده) را حذف کنید و مطمئن شوید رضایتنامهی شرکتکنندگان و ضوابط کمیتهی اخلاق چنین پردازشی را منع نکرده است.
زمینه دادن: پیش از ارسال جدول، زمینهی پژوهش را به ابزار بدهید. یک پرامپت زمینهای نمونه:
«من دانشجوی کارشناسی ارشد روانشناسی هستم. پژوهش من رابطهی حمایت اجتماعی ادراکشده و تابآوری با سلامت روان در دانشجویان را بررسی میکند. طرح پژوهش مقطعی-همبستگی است، حجم نمونه ۲۸۰ نفر و ابزارها پرسشنامههای استاندارد با طیف لیکرت است. فرضیهها اینها هستند: […]. در ادامه جدولهای خروجی SPSS را میفرستم. لطفاً هر جدول را توضیح بده، مقادیری را که باید گزارش کنم مشخص کن و هیچ عددی را تغییر نده.»
یک فایل «جدولهای منتخب» بسازید که فقط جدولهای لازم برای فصل چهارم را داشته باشد. خروجیهای SPSS معمولاً جدولهای زیادی دارند که همهی آنها گزارش نمیشوند. از ChatGPT بپرسید کدام جدولها برای هر آزمون معمولاً گزارش میشوند.
نکتهی مربوط به حریم خصوصی حساب کاربری: اگر از حساب مشترک با دیگران استفاده میکنید، تاریخچهی گفتوگوها و جدولهای شما برای آنها قابلمشاهده است. برای کار روی پایاننامه، حساب شخصی با رمز قوی و در صورت امکان تأیید دومرحلهای را ترجیح دهید. صفحهی خرید اکانت هوش مصنوعی گزینههای مختلف دسترسی را معرفی کرده است. همچنین در تنظیمات ابزار، اگر گزینهای برای جلوگیری از استفادهی گفتوگوها در آموزش مدل وجود دارد، آن را فعال کنید.
ساختار استاندارد فصل چهارم
فصل چهارم پایاننامههای کمی معمولاً این ساختار را دارد:
- مقدمهی کوتاه: یادآوری هدف فصل و ترتیب ارائهی یافتهها.
- ویژگیهای جمعیتشناختی: جنسیت، سن، تحصیلات و سایر ویژگیهای نمونه، معمولاً با فراوانی و درصد.
- آمار توصیفی متغیرهای اصلی: میانگین، انحراف معیار، کمینه، بیشینه، چولگی و کشیدگی.
- بررسی پیشفرضها: نرمال بودن، همگنی واریانس، نبود همخطی و غیره، بسته به آزمونها.
- پایایی ابزارها: ضرایب آلفای کرونباخ در نمونهی پژوهش (گاهی در فصل سوم گزارش میشود).
- آزمون فرضیهها: هر فرضیه به ترتیب، با جدول و متن تفسیری.
- جمعبندی: خلاصهی نتایج آزمون فرضیهها، معمولاً در یک جدول.
ChatGPT میتواند به شما کمک کند این ساختار را با فرضیههای خودتان تطبیق دهید و ترتیب منطقی ارائه را پیشنهاد کند. برای آشنایی با ارتباط این فصل با سایر فصلها، راهنمای نوشتن پایاننامه با هوش مصنوعی را ببینید.
یک نکتهی ساختاری مهم این است که فصل چهارم باید دقیقاً به ترتیب فرضیهها یا سؤالاتی باشد که در فصل اول آمدهاند. اگر فرضیهها در فصل اول یک ترتیب دارند و در فصل چهارم ترتیب دیگری، داوران سردرگم میشوند. همچنین عنوان هر بخش از آزمون فرضیهها را با متن خود فرضیه شروع کنید تا خواننده بداند کدام فرضیه در حال بررسی است. ChatGPT میتواند فهرست فرضیههای فصل اول و عنوانهای فصل چهارم را مقایسه کند و هر ناهماهنگی را گزارش دهد. اگر در نگارش فصلهای دیگر هم به راهنمایی نیاز دارید، صفحهی نگارش پایاننامه را ببینید.
تفسیر رایجترین خروجیهای SPSS با کمک ChatGPT
در این بخش، رایجترین آزمونهایی را که در پایاننامههای ایرانی به کار میروند مرور میکنیم و برای هر کدام توضیح میدهیم کدام مقادیر مهماند، چگونه تفسیر میشوند و چه پرامپتی برای کمک گرفتن از ChatGPT مناسب است. این بخش جایگزین منابع آماری نیست، اما راهنمای عملی خوبی برای خواندن خروجیهاست.
آمار توصیفی، نرمال بودن و پایایی
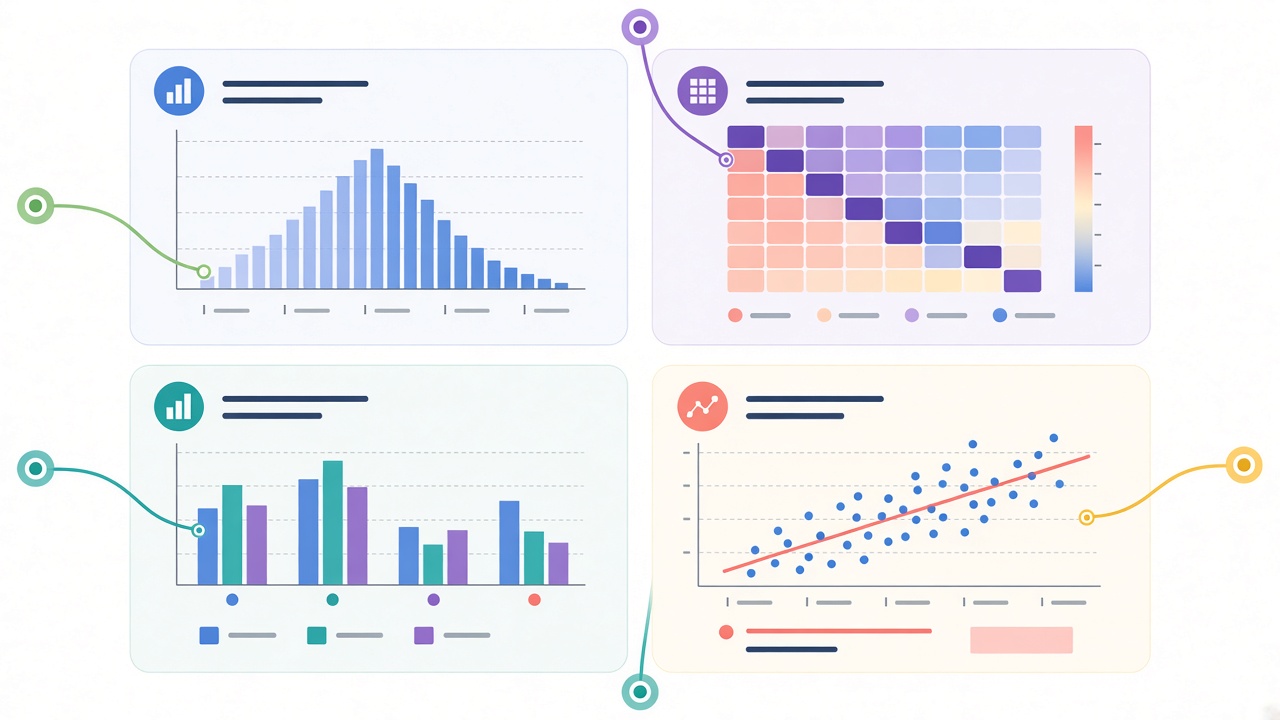
آمار توصیفی (Descriptives): جدول Descriptive Statistics مقادیر N، کمینه، بیشینه، میانگین و انحراف معیار را نشان میدهد. اگر چولگی (Skewness) و کشیدگی (Kurtosis) را هم درخواست کرده باشید، این مقادیر هم نمایش داده میشوند. در گزارش، معمولاً میانگین و انحراف معیار هر متغیر را با دو رقم اعشار میآورید.
نرمال بودن: برای بررسی نرمال بودن، دانشجویان معمولاً از آزمونهای کولموگروف-اسمیرنوف (K-S) و شاپیرو-ویلک (Shapiro-Wilk) استفاده میکنند. در جدول Tests of Normality، اگر مقدار Sig. بیشتر از ۰٫۰۵ باشد، فرض نرمال بودن رد نمیشود. اما چند نکتهی مهم:
- در نمونههای بزرگ (مثلاً بیش از ۲۰۰ نفر)، این آزمونها حتی به انحرافهای جزئی از نرمال بودن حساساند و ممکن است معنادار شوند.
- به همین دلیل، بسیاری از پژوهشگران در کنار آزمونها، به مقادیر چولگی و کشیدگی و نمودارهای Q-Q و هیستوگرام هم توجه میکنند. برخی منابع، دامنهای مثل ±۲ برای چولگی و کشیدگی را قابلقبول میدانند، هرچند معیارها در منابع مختلف متفاوت است.
پایایی (Reliability): در جدول Reliability Statistics، ضریب آلفای کرونباخ نمایش داده میشود. مقدار ۰٫۷۰ یا بیشتر معمولاً قابلقبول تلقی میشود، هرچند این معیار هم مطلق نیست و به تعداد گویهها و ماهیت سازه بستگی دارد. جدول Item-Total Statistics نشان میدهد اگر هر گویه حذف شود، آلفا چه تغییری میکند.
پرامپت پیشنهادی: «این جدول Tests of Normality و Descriptives متغیرهای من است و حجم نمونه ۲۸۰ است. توضیح بده آیا با توجه به حجم نمونه، آزمونها، چولگی و کشیدگی، میتوانم فرض نرمال بودن را پذیرفتنی بدانم و چگونه این را در متن گزارش کنم. منابع آماری که این معیارها را پیشنهاد کردهاند را نام نبر؛ خودم پیدا میکنم.»
حذف گویهها برای افزایش آلفای کرونباخ یا حذف شرکتکنندگان برای «نرمال کردن» دادهها، بدون توجیه روششناختی و گزارش شفاف، میتواند دستکاری داده محسوب شود. هر تغییری در دادهها باید با استاد راهنما هماهنگ و در متن گزارش شود.
ویژگیهای جمعیتشناختی: برای متغیرهای جمعیتشناختی مثل جنسیت، تحصیلات یا وضعیت تأهل، جدول Frequencies شامل فراوانی، درصد، درصد معتبر و درصد تجمعی است. در گزارش، معمولاً فقط فراوانی و درصد معتبر کافی است. برای سن، اگر بهصورت پیوسته سنجیده شده، میانگین و انحراف معیار گزارش میشود. ChatGPT میتواند چند جدول فراوانی را در یک جدول ترکیبی جمعیتشناختی خلاصه کند و یک پاراگراف توصیفی کوتاه برای آن پیشنهاد دهد؛ اما درصدها را دوباره با خروجی تطبیق دهید، چون گرد کردن ممکن است مجموع را از ۱۰۰ دور کند.
همبستگی، آزمون t و تحلیل واریانس
همبستگی پیرسون (Correlations): در جدول Correlations، برای هر جفت متغیر، ضریب همبستگی (r)، مقدار Sig. و N نمایش داده میشود. ضریب بین ۱- و ۱+ است؛ علامت جهت رابطه و قدر مطلق شدت آن را نشان میدهد. اگر دادهها نرمال نباشند یا متغیرها رتبهای باشند، همبستگی اسپیرمن جایگزین رایج است.
نکتهی مهم در تفسیر: همبستگی به معنای علیت نیست. ChatGPT گاهی در بازنویسی، جملهای مثل «حمایت اجتماعی باعث افزایش سلامت روان میشود» مینویسد که برای یک طرح همبستگی نادرست است. زبان درست: «بین حمایت اجتماعی و سلامت روان رابطهی مثبت و معنادار مشاهده شد.»
آزمون t مستقل (Independent Samples t-test): برای مقایسهی میانگین دو گروه مستقل، مثلاً زنان و مردان. خروجی دو جدول دارد: Group Statistics (میانگین و انحراف معیار هر گروه) و Independent Samples Test. در جدول دوم، ابتدا به آزمون لوین (Levene’s Test) نگاه کنید:
- اگر Sig. لوین بیشتر از ۰٫۰۵ باشد، فرض برابری واریانسها برقرار است و از ردیف اول (Equal variances assumed) استفاده کنید.
- اگر کمتر از ۰٫۰۵ باشد، از ردیف دوم (Equal variances not assumed) استفاده کنید.
سپس مقدار t، درجهی آزادی (df) و Sig. (2-tailed) را گزارش کنید. نسخههای جدیدتر SPSS اندازهی اثر (مانند d کوهن) را هم ارائه میدهند که گزارش آن توصیه میشود.
تحلیل واریانس یکطرفه (One-Way ANOVA): برای مقایسهی میانگین سه گروه یا بیشتر. جدول ANOVA مقادیر F، df بینگروهی و درونگروهی و Sig. را نشان میدهد. اگر F معنادار بود، برای فهمیدن اینکه کدام گروهها با هم تفاوت دارند، به آزمونهای تعقیبی (Post Hoc) مانند توکی (Tukey) یا شفه (Scheffe) نیاز دارید. پیشفرض همگنی واریانسها را هم با آزمون لوین بررسی کنید؛ اگر برقرار نبود، آزمونهایی مثل Welch و تعقیبی Games-Howell جایگزینهای رایج هستند.
پرامپت پیشنهادی: «این خروجی آزمون t مستقل برای مقایسهی سلامت روان در دانشجویان دختر و پسر است. توضیح بده از کدام ردیف باید استفاده کنم، نتیجه چیست و یک جملهی گزارش به سبک APA با همین اعداد بنویس. هیچ عددی را گرد یا تغییر نده.»
آزمون t وابسته (Paired Samples t-test): اگر یک گروه را در دو زمان (مثلاً پیشآزمون و پسآزمون) مقایسه میکنید، از این آزمون استفاده میشود. خروجی شامل Paired Samples Statistics، Paired Samples Correlations و Paired Samples Test است. در جدول آخر، میانگین تفاوتها، t، df و Sig. گزارش میشوند.
آزمون خیدو (Chi-Square): برای بررسی رابطهی دو متغیر اسمی، مثلاً جنسیت و انتخاب رشته. در جدول Chi-Square Tests، مقدار Pearson Chi-Square، df و Sig. را گزارش کنید. به یادداشت زیر جدول هم توجه کنید که نشان میدهد چند خانه فراوانی مورد انتظار کمتر از ۵ دارند؛ اگر این نسبت زیاد باشد، آزمون دقیق فیشر یا ادغام طبقات ممکن است لازم باشد. برای اندازهی اثر، ضریب فی یا V کرامر رایج است.
آزمونهای ناپارامتریک: اگر پیشفرضهای آزمونهای پارامتریک برقرار نباشد، جایگزینهای رایج عبارتاند از: من-ویتنی U بهجای t مستقل، ویلکاکسون بهجای t وابسته و کروسکال-والیس بهجای ANOVA یکطرفه. ChatGPT میتواند توضیح دهد چه زمانی این جایگزینها مناسباند، اما تصمیم نهایی را با استاد راهنما بگیرید.
رگرسیون، میانجی و تعدیلگر
رگرسیون خطی چندگانه (Linear Regression): یکی از پرکاربردترین تحلیلها در پایاننامههاست. خروجی شامل چند جدول کلیدی است:
- Model Summary: ضریب همبستگی چندگانه (R)، ضریب تعیین (R²) که نشان میدهد چه درصدی از واریانس متغیر وابسته توسط پیشبینها تبیین میشود، R² تعدیلشده و آمارهی دوربین-واتسون (Durbin-Watson) برای بررسی استقلال خطاها (مقادیر نزدیک به ۲ معمولاً مطلوب تلقی میشوند).
- ANOVA: معناداری کل مدل رگرسیون با آمارهی F.
- Coefficients: برای هر پیشبین، ضریب غیراستاندارد (B)، خطای استاندارد، ضریب استاندارد (Beta)، مقدار t و Sig. اگر آمارههای همخطی را درخواست کرده باشید، Tolerance و VIF هم نمایش داده میشوند؛ VIF بالا (معیارهایی مثل بیش از ۵ یا ۱۰ در منابع مختلف) نشانهی همخطی است.
در تفسیر، Beta برای مقایسهی سهم نسبی پیشبینها مفید است، چون استاندارد شده است. B برای تفسیر در واحد اصلی متغیرها به کار میرود.
میانجی و تعدیلگر: بسیاری از پایاننامهها نقش متغیر میانجی (Mediator) یا تعدیلگر (Moderator) را بررسی میکنند. در SPSS، این تحلیلها معمولاً با افزونهی PROCESS انجام میشوند. خروجی PROCESS شامل اثر مستقیم، اثر غیرمستقیم و فاصلهی اطمینان بوتاسترپ است. قاعدهی کلی: اگر فاصلهی اطمینان اثر غیرمستقیم (BootLLCI تا BootULCI) شامل صفر نباشد، اثر میانجی معنادار تلقی میشود.
ChatGPT میتواند در فهم این خروجیهای پیچیده بسیار کمک کند، اما برای تحلیلهای پیشرفتهتر مثل مدلیابی معادلات ساختاری (SEM) با AMOS یا SmartPLS، همراهی متخصص آمار ضروری است. صفحهی تحلیل آماری ریسرچ اینتل در این زمینه خدمات و راهنمایی ارائه میدهد.
برای هر جدول رگرسیون، از ChatGPT بخواهید یک «چکلیست پیشفرضها» بدهد: خطی بودن، استقلال خطاها، همسانی واریانس خطاها، نرمال بودن باقیماندهها و نبود همخطی. سپس بررسی کنید کدام را در خروجی خود دارید و کدام را باید اجرا کنید.
تحلیلهای مبتنی بر طرحهای آزمایشی: اگر پژوهش شما نیمهآزمایشی با پیشآزمون و پسآزمون و گروه کنترل است، تحلیل کوواریانس (ANCOVA) یکی از روشهای رایج است. در این تحلیل، پیشفرضهای اضافی مثل همگنی شیبهای رگرسیون باید بررسی شوند. ChatGPT میتواند این پیشفرضها و نحوهی بررسی آنها در SPSS را توضیح دهد و جدول Tests of Between-Subjects Effects را تفسیر کند، شامل مجذور اتای جزئی (Partial Eta Squared) بهعنوان اندازهی اثر. برای طرحهای پیچیدهتر مثل اندازهگیری مکرر، مشورت با متخصص آمار را جدی بگیرید.
مطالعهٔ تکمیلی: اگر میخواهید این موضوع را عمیقتر و بر پایهٔ یک منبع معتبر دانشگاهی دنبال کنید، راهنماهای تحلیل داده با هوش مصنوعی، طراحی پژوهش با هوش مصنوعی و آموزش هوش مصنوعی برای دانشجویان را هم در ریسرچ اینتل بخوانید.
نگارش فصل چهارم و کنترل کیفیت
پس از فهم خروجیها، نوبت به تبدیل آنها به متن علمی فصل چهارم میرسد. در این بخش، نحوهی نگارش گزارش آماری به سبک APA را با نمونه مرور میکنیم، پرامپتهای آمادهی هر مرحله را ارائه میدهیم و خطاهای رایج و ملاحظات اخلاقی را بررسی میکنیم.
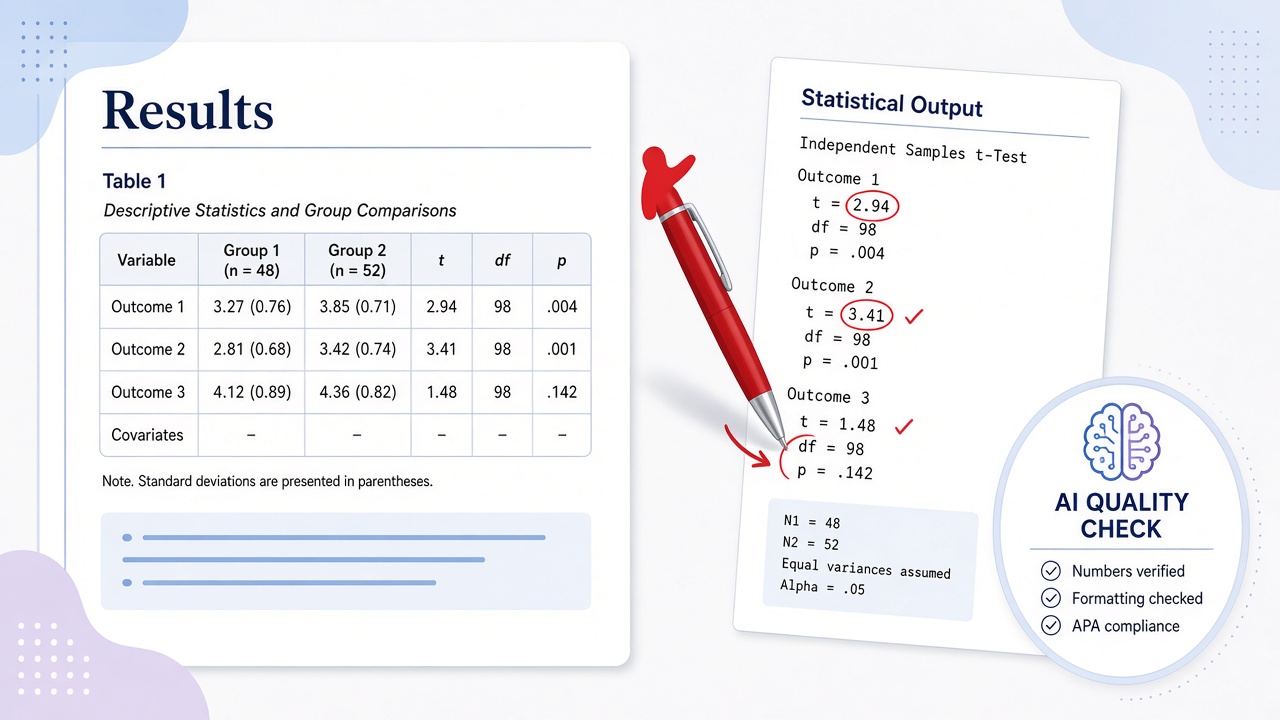
پیش از نوشتن، یک قاعدهی کلی را در نظر بگیرید: متن فصل چهارم نباید تکرار کامل جدولها باشد. جدول همهی اعداد را نشان میدهد و متن باید مهمترین یافتهها را برجسته کند و خواننده را به جدول ارجاع دهد. در تحلیل SPSS با ChatGPT، میتوانید از ابزار بخواهید از هر جدول، فقط یک یا دو جملهی کلیدی برای متن پیشنهاد دهد؛ سپس شما تصمیم بگیرید کدام جزئیات باید در متن بیاید و کدام فقط در جدول بماند. این تعادل، فصل چهارم را خواناتر و حرفهایتر میکند و همان چیزی است که داوران مجلات هم هنگام انتشار مقاله انتظار دارند.
نوشتن متن گزارش به سبک APA
سبک APA پرکاربردترین سبک گزارش آماری در علوم انسانی، اجتماعی و رفتاری است. اصول کلیدی:
- نماد آمارهها (مانند t، F، r، p، M، SD) بهصورت ایتالیک نوشته میشوند.
- مقدار p معمولاً بهصورت دقیق (مثلاً p = .032) گزارش میشود و برای مقادیر بسیار کوچک، p < .001.
- اعداد معمولاً با دو رقم اعشار گزارش میشوند، بهجز مقدار p که ممکن است سه رقم داشته باشد.
- در نسخهی انگلیسی، برای مقادیری که نمیتوانند بیشتر از ۱ باشند (مانند r و p)، صفر پیش از ممیز نوشته نمیشود.
- گزارش اندازهی اثر در کنار معناداری توصیه میشود.
نمونهی گزارش همبستگی:
«نتایج ضریب همبستگی پیرسون نشان داد که بین حمایت اجتماعی ادراکشده و سلامت روان، رابطهی مثبت و معناداری وجود دارد (r = .42, p < .001). بنابراین فرضیهی اول پژوهش تأیید شد.»
نمونهی گزارش آزمون t:
«نتایج آزمون t مستقل نشان داد که میانگین تابآوری دانشجویان پسر (M = 68.45, SD = 9.12) بهطور معناداری بیشتر از دانشجویان دختر (M = 64.20, SD = 10.35) است، t(278) = 3.62, p < .001, d = 0.44.»
نمونهی گزارش رگرسیون:
«نتایج تحلیل رگرسیون چندگانه نشان داد که مدل در کل معنادار است، F(2, 277) = 45.80, p < .001، و حمایت اجتماعی و تابآوری در مجموع ۲۵ درصد از واریانس سلامت روان را تبیین میکنند (R² = .25). تابآوری (β = .38, p < .001) نسبت به حمایت اجتماعی (β = .21, p = .002) سهم بیشتری در پیشبینی سلامت روان داشت.»
اعداد نمونههای بالا فرضی و فقط برای نشان دادن قالب هستند. در پایاننامهی خود، فقط اعداد واقعی خروجی SPSS را گزارش کنید و هر عدد را دو بار با خروجی تطبیق دهید.
برای جدولها هم APA قالب مشخصی دارد: شماره و عنوان جدول بالای آن، خطوط افقی محدود و بدون خطوط عمودی، و یادداشتهای توضیحی زیر جدول. ChatGPT میتواند جدول خروجی را به قالب APA تبدیل کند، اما پس از تبدیل، همهی اعداد را دوباره با خروجی اصلی مقایسه کنید.
نوشتن به فارسی و رعایت قالب: در پایاننامههای فارسی، معمولاً متن گزارش به فارسی است اما نمادها و اعداد آماری بهصورت لاتین داخل پرانتز میآیند. یکدستی این قالب در کل فصل اهمیت دارد. همچنین شیوهنامهی دانشگاه شما ممکن است دربارهی تعداد ارقام اعشار، استفاده از اعداد فارسی یا لاتین در جدولها و نحوهی شمارهگذاری جدولها قواعد خاصی داشته باشد. پیش از نگارش، شیوهنامه را به ChatGPT بدهید و بخواهید چکلیستی از قواعد قالببندی فصل چهارم استخراج کند. این کار در مرحلهی ویرایش نهایی، زمان زیادی را صرفهجویی میکند.
پرامپتهای آماده برای فصل چهارم
این پرامپتها را بر اساس پژوهش خود تنظیم و استفاده کنید:
- انتخاب آزمون: «طرح پژوهش من […] است، متغیر مستقل […] با سطح سنجش […] و متغیر وابسته […] با سطح سنجش […]. چه آزمونهایی ممکن است مناسب باشند و پیشفرضهای هر کدام چیست؟ تصمیم نهایی را با استاد راهنما میگیرم.»
- تفسیر جدول: «این جدول خروجی SPSS است. هر ستون را توضیح بده، مقادیر کلیدی برای گزارش را مشخص کن و بگو نتیجه با فرضیهی من چه نسبتی دارد. هیچ عددی را تغییر نده.»
- نوشتن گزارش: «با همین اعداد و بدون هیچ تغییری، یک پاراگراف گزارش به فارسی و با قالب APA برای فرضیهی دوم بنویس.»
- جدول APA: «این جدول را به قالب جدول APA تبدیل کن؛ عنوان پیشنهادی و یادداشت زیر جدول را هم بنویس.»
- بررسی سازگاری: «این متن فصل چهارم من است و این جدولهای خروجی. بررسی کن آیا همهی اعداد متن با جدولها یکسان است و اگر مغایرتی هست، فهرست کن.»
- زبان مناسب: «این پاراگراف را بررسی کن و هر جا زبان علّی برای یافتههای همبستگی به کار رفته، جایگزین مناسب پیشنهاد بده.»
- جمعبندی: «بر اساس نتایج آزمون فرضیهها، یک جدول خلاصه با ستونهای فرضیه، آزمون، آماره، p و نتیجه (تأیید/رد) بساز.»
پرامپت «بررسی سازگاری» یکی از ارزشمندترینهاست؛ چون خطاهای انتقال عدد از خروجی به متن بسیار رایج است و داوران به آنها حساساند. پرامپتهای بیشتر را در بانک پرامپتهای پژوهشی ریسرچ اینتل ببینید.
از فصل چهارم به فصل پنجم: یکی از کاربردهای ارزشمند دیگر ChatGPT، کمک به گذار از گزارش یافتهها به بحث است. پس از اتمام فصل چهارم، جدول خلاصهی نتایج را به ابزار بدهید و بپرسید: «برای هر یافته، چه سؤالاتی باید در فصل پنجم به آنها پاسخ دهم؟» پاسخ معمولاً شامل مقایسه با مطالعات قبلی، تبیین نظری و پیامدهاست. یادتان باشد که فصل چهارم فقط گزارش است و تفسیر در فصل پنجم انجام میشود؛ ChatGPT گاهی در متن فصل چهارم جملات تفسیری اضافه میکند که باید آنها را به فصل پنجم منتقل کنید.
خطاهای رایج و ملاحظات اخلاقی
خطاهای رایج فنی:
- گزارش ردیف اشتباه در آزمون t: بیتوجهی به نتیجهی آزمون لوین.
- نادیده گرفتن آزمون تعقیبی: گزارش ANOVA معنادار بدون مشخص کردن تفاوت گروهها.
- خلط B و Beta: استفاده از ضریب غیراستاندارد برای مقایسهی سهم پیشبینها.
- تفسیر علّی از دادههای همبستگی.
- نادیده گرفتن پیشفرضها: اجرای آزمون پارامتریک بدون بررسی نرمال بودن یا همگنی واریانس.
- گزارش ناقص: ذکر فقط «معنادار بود» بدون آماره، درجهی آزادی و مقدار p.
- گرد کردن یا جابهجایی اعداد در بازنویسی توسط ابزار.
ملاحظات اخلاقی: فراتر از خطاهای فنی، برخی رفتارها در تحلیل داده، تخلف پژوهشی محسوب میشوند:
- جعل داده (Fabrication): ساختن داده یا نتایجی که وجود ندارند.
- تحریف داده (Falsification): تغییر اعداد، حذف دادههای نامطلوب بدون توجیه یا گزارش انتخابی.
- p-hacking: اجرای آزمونهای متعدد، تغییر متغیرها یا حذف شرکتکنندگان تا زمانی که نتیجه «معنادار» شود، بدون گزارش شفاف این فرایند.
- HARKing: نوشتن فرضیه پس از دیدن نتایج و ارائهی آن بهعنوان فرضیهی از پیش تعیینشده.
این رفتارها در رهنمودهای اخلاق نشر مانند COPE و ICMJE بهعنوان تخلف جدی شناخته میشوند و میتوانند به ابطال مدرک یا پسگرفتن مقاله منجر شوند. اگر ChatGPT یا هر کس دیگری پیشنهادی در این جهت داد، آن را رد کنید. اصول کلی را در صفحهی صداقت علمی ببینید.
اعلام استفاده: اگر از ChatGPT برای فهم خروجی یا ویرایش متن فصل چهارم استفاده کردهاید، با استاد راهنما هماهنگ کنید و در صورت لزوم اعلام کنید. اگر قصد دارید از این فصل مقاله استخراج کنید، قواعد مجلات را در استفاده از ChatGPT در مقاله و نحوهی تبدیل فصل به بخش نتایج مقاله را در استخراج مقاله از پایاننامه ببینید.
آمادگی برای دفاع: در جلسهی دفاع، داوران معمولاً دربارهی دلیل انتخاب آزمون، بررسی پیشفرضها، معنای اندازهی اثر و محدودیتهای تحلیل سؤال میپرسند. از ChatGPT بخواهید بر اساس فصل چهارم شما، ده سؤال آماری محتمل داوران را طرح کند. سپس بدون کمک ابزار به آنها پاسخ دهید و پاسخها را با استاد یا مشاور آمار مرور کنید. این تمرین، مهمترین تضمین برای این است که شما واقعاً تحلیل خود را فهمیدهاید. اگر هنوز در مرحلهی طراحی روش هستید و میخواهید از ابتدا تحلیل مناسبی پیشبینی کنید، راهنمای نوشتن پروپوزال با هوش مصنوعی و صفحهی نگارش پروپوزال را ببینید. برای آشنایی گستردهتر با کاربردهای هوش مصنوعی در پژوهش هم صفحهی هوش مصنوعی در پژوهش و رویدادهای هفته پژوهش را دنبال کنید.
جمعبندی: تحلیل SPSS با ChatGPT وقتی ارزشمند است که ابزار نقش «مفسر و ویراستار» داشته باشد، نه «تحلیلگر» یا «سازندهی عدد». خروجی را با زمینهی کامل و بدون اطلاعات هویتی به ابزار بدهید، معنای هر جدول و مقادیر کلیدی را بفهمید، گزارش را خودتان و مطابق APA بنویسید و هر عدد را با خروجی اصلی تطبیق دهید. انتخاب آزمون و تصمیمگیری دربارهی نتایج را با استاد راهنما و در صورت نیاز مشاور آمار انجام دهید. برای یادگیری عملیتر، دوره مقالهنویسی با هوش مصنوعی و مشاوره پژوهشی ریسرچ اینتل در کنار شماست و برای انتخاب ابزار مناسب، بهترین هوش مصنوعی برای پژوهش را بخوانید.
برای آموزشها و مشاورههای بیشتر پژوهشی به هوش پژوهشی سر بزنید.