هوش مصنوعی در پژوهش دانشگاهی دیگر یک موضوع آیندهنگرانه یا سرگرمی برای علاقهمندان فناوری نیست؛ امروز دانشجوی کارشناسی ارشد در تبریز، دانشجوی دکتری در مشهد و عضو هیئت علمی در تهران، همگی به شکلی با ابزارهایی مثل ChatGPT، Claude یا Gemini سروکار دارند. پرسش اصلی دیگر این نیست که «آیا از هوش مصنوعی استفاده کنیم؟» بلکه این است که «چطور از آن استفاده کنیم که کیفیت علمی، اصالت و اعتبار کارمان آسیب نبیند؟»
این مقاله بر پایهٔ ایدههای فصل ۱ کتاب Using AI in Academic Writing and Research (Springer, 2025) نوشته شده است؛ کتابی که الدار هابر، داریوش یمیلنیاک، آرتور کوراسینسکی و الکساندرا پشگالینسکا آن را بهعنوان راهنمایی متوازن برای پژوهشگران، استادان و مدیران دانشگاهی تألیف کردهاند. ما در اینجا فصل را ترجمه نمیکنیم؛ بلکه ایدههای محوری آن را با زبان خودمان توضیح میدهیم و با مثالها، پرامپتها و چکلیستهایی متناسب با فضای دانشگاههای ایران گسترش میدهیم.
این نوشته نخستین قسمت از یک مجموعهٔ دهقسمتی در ریسرچ اینتل است که هر قسمت آن به یکی از فصلهای این کتاب میپردازد. اگر تازه با موضوع آشنا میشوید، از همینجا شروع کنید و سپس سراغ تاریخچه هوش مصنوعی بروید.
ایدهٔ اصلی فصل نخست کتاب ساده اما مهم است: ابزارهای مولد فقط کارهای تکراری را خودکار نمیکنند، بلکه ماهیت پژوهش، نوشتن، تدریس و حتی شیوهٔ ادارهی دانشگاه را تغییر میدهند. وقتی یک ابزار میتواند در چند ثانیه پیشنویس یک بند، خلاصهٔ ده مقاله یا کد تحلیل داده تولید کند، مرز میان «کمک گرفتن» و «واگذار کردن» کمرنگ میشود. اینجاست که پژوهشگر باید هم فهم فنی داشته باشد و هم قضاوت اخلاقی.
در ادامه، مطالب را در سه بخش اصلی میخوانید. ابتدا میبینیم هوش مصنوعی مولد چیست و چگونه کار میکند. سپس کاربردهای واقعی آن را در چرخهٔ پژوهش مرور میکنیم. و در بخش سوم، چارچوبی عملی برای استفادهٔ مسئولانه ارائه میدهیم. در پایان هم به پرسشهای متداول پاسخ دادهایم و فهرست منابع معتبر را آوردهایم.
هوش مصنوعی مولد چیست و چرا دانشگاه را دگرگون میکند؟
برای استفادهٔ درست از هر ابزار، باید منطق کار آن را بفهمیم. بسیاری از خطاهایی که دانشجویان در کار با چتباتها مرتکب میشوند، از یک تصور نادرست شروع میشود: اینکه این ابزارها «پایگاه دادهٔ دانش» یا «موتور جستوجو» هستند. در واقع آنها مدلهایی هستند که زبان تولید میکنند و این تفاوت، پیامدهای مهمی برای پژوهش دارد.
از خودکارسازی تا دگرگونی شیوهٔ تولید دانش
نسلهای پیشین فناوری در دانشگاه، بیشتر کارهای جانبی را ساده میکردند. نرمافزارهای مدیریت منابع، فهرستنویسی را آسان کردند؛ نرمافزارهای آماری، محاسبات دستی را حذف کردند؛ و موتورهای جستوجو، دسترسی به مقالات را سریعتر کردند. اما در همهٔ این موارد، «فکر کردن» و «نوشتن» همچنان کار انسان بود.
هوش مصنوعی مولد این تقسیم کار را به هم زده است. اکنون ابزاری در اختیار داریم که میتواند:
- برای یک مسئلهٔ پژوهشی، ده زاویهٔ متفاوت پیشنهاد دهد؛
- یک متن پیچیدهٔ روششناختی را به زبان ساده توضیح دهد؛
- پیشنویس اولیهٔ چکیده یا نامهٔ پوششی بنویسد؛
- کد پایتون یا R برای پاکسازی داده تولید کند؛
- نقش یک داور سختگیر را بازی کند و نقاط ضعف استدلال را نشان دهد.
نویسندگان کتاب تأکید میکنند که این تغییر صرفاً افزایش سرعت نیست؛ بلکه پرسشهایی بنیادین دربارهٔ اصالت، مالکیت فکری، نقش نویسنده و معیارهای ارزیابی پیش میکشد. اگر بخشی از استدلال مقاله را ابزار پیشنهاد داده باشد، سهم نویسنده چیست؟ اگر دانشجو تکلیفی را با کمک ابزار نوشته باشد، استاد دقیقاً چه چیزی را ارزیابی میکند؟
برای دانشجوی ایرانی، این دگرگونی یک فرصت مضاعف هم هست. بسیاری از ما با مانع زبان انگلیسی، دسترسی محدود به منابع و کمبود راهنمایی تخصصی روبهرو هستیم. ابزارهای مولد میتوانند بخشی از این فاصله را کم کنند؛ به شرط آنکه آنها را بهعنوان دستیار فکری ببینیم، نه جایگزین فکر.
این دگرگونی در سطح نهاد دانشگاه هم دیده میشود. کتاب یادآوری میکند که مخاطب بحث فقط دانشجو نیست؛ استادان، مدیران گروه، معاونتهای پژوهشی و سردبیران نشریات هم باید تصمیم بگیرند که با این ابزارها چه کنند. در بسیاری از دانشگاههای ایران هنوز آییننامهٔ روشنی دربارهٔ استفاده از هوش مصنوعی وجود ندارد و همین خلأ باعث میشود رفتار استادان بسیار متفاوت باشد: یکی هر نوع استفاده را ممنوع میداند و دیگری آن را تشویق میکند.
در چنین شرایطی، بهترین راهبرد برای دانشجو «گفتوگوی پیشگیرانه» است. پیش از شروع پروپوزال یا پایاننامه، با استاد راهنما صریحاً صحبت کنید: از چه ابزارهایی استفاده میکنید، برای چه کارهایی، و چگونه آن را مستند میکنید. این گفتوگو هم از سوءتفاهمهای بعدی جلوگیری میکند و هم نشان میدهد که شما با رویکردی مسئولانه کار میکنید.
یک نکتهٔ دیگر هم ارزش توجه دارد: سرعت تغییر. کتابهای درسی روش تحقیق معمولاً هر چند سال یکبار بهروز میشوند، اما ابزارهای مولد هر چند ماه یکبار قابلیت تازهای پیدا میکنند. بنابراین پژوهشگر امروز به جای حفظ کردن دستورالعملهای یک ابزار خاص، باید «سواد هوش مصنوعی» پیدا کند؛ یعنی توانایی فهم، ارزیابی و بهکارگیری انتقادی هر ابزار تازهای که از راه میرسد.
مدلهای اصلی: GPT، Claude، Gemini، Llama و DeepSeek
کتاب به چند خانوادهٔ اصلی از مدلهای زبانی اشاره میکند که هرکدام ویژگیهای خود را دارند. شناخت کلی آنها کمک میکند ابزار مناسب را برای کار مناسب انتخاب کنید:
| خانوادهٔ مدل | شرکت سازنده | نقطهٔ قوت رایج در کار پژوهشی | نکتهٔ احتیاط |
|---|---|---|---|
| GPT (ChatGPT) | OpenAI | تنوع کاربرد، تحلیل فایل و داده، اکوسیستم گسترده | احتمال ساختن ارجاع در حالت بدون جستوجو |
| Claude | Anthropic | متنهای طولانی، نوشتار روان و ساختارمند | نیاز به بررسی واقعیتها و آمار |
| Gemini | پیوند با خدمات گوگل و ورودیهای چندرسانهای | تفاوت کیفیت میان نسخهها | |
| Llama | Meta | مدل باز، امکان اجرای محلی برای دادههای حساس | نیاز به دانش فنی برای راهاندازی |
| DeepSeek | DeepSeek | استدلال گامبهگام و هزینهٔ کمتر | توجه به سیاست حریم خصوصی دادهها |
نکتهٔ مهم این است که فهرست ابزارها بهسرعت تغییر میکند. نسخهای که امروز بهترین است، ممکن است شش ماه بعد جای خود را به رقیبی بدهد. به همین دلیل، بهجای وابستگی به یک ابزار خاص، بهتر است اصول کار با مدلهای زبانی را یاد بگیرید. برای مقایسهٔ بهروز ابزارها، راهنمای بهترین هوش مصنوعی برای پژوهش را ببینید.
در کنار این مدلهای عمومی، ابزارهای تخصصیتری هم وجود دارند که روی پایگاههای مقالات علمی ساخته شدهاند و پاسخهایشان را به مقالههای واقعی ارجاع میدهند. معرفی سه نمونهٔ مهم آنها را در مقالهٔ ابزارهای هوش مصنوعی پژوهش: Elicit، Consensus و SciSpace آوردهایم.
هوش مصنوعی چگونه «فکر» میکند؟ سازوکار تولید زبان
مدلهای زبانی بزرگ بر پایهٔ معماری ترنسفورمر ساخته شدهاند؛ معماریای که در سال ۲۰۱۷ در مقالهٔ مشهور Attention Is All You Need معرفی شد. بدون ورود به جزئیات ریاضی، میتوان کار آنها را در چند گام خلاصه کرد:
- توکنسازی: متن ورودی به قطعههای کوچک (کلمه یا بخشی از کلمه) شکسته میشود.
- نمایش عددی: هر توکن به برداری از اعداد تبدیل میشود که معنای تقریبی آن را در فضای ریاضی نشان میدهد.
- سازوکار توجه: مدل بررسی میکند کدام بخشهای متن برای فهم هر توکن مهمترند.
- پیشبینی: مدل محتملترین توکن بعدی را انتخاب میکند و این کار را بارها تکرار میکند تا پاسخ کامل شود.
دو مفهوم فنی دیگر هم برای کاربر دانشگاهی مهماند. اولی «پنجرهٔ زمینه» (Context Window) است؛ یعنی حجم متنی که مدل میتواند در یک گفتوگو همزمان در نظر بگیرد. اگر یک فصل کامل پایاننامه را وارد کنید و پنجرهٔ زمینه کوچک باشد، مدل بخشهای ابتدایی را «فراموش» میکند و پاسخهایش ناسازگار میشود. راهکار عملی این است که متنهای طولانی را بخشبخش وارد کنید و در هر مرحله خلاصهای از بخشهای قبلی را یادآوری کنید.
مفهوم دوم «تصادفی بودن» خروجی است. مدلها در انتخاب واژهٔ بعدی همیشه محتملترین گزینه را برنمیدارند و درجهای از تنوع دارند. به همین دلیل اگر یک پرسش را دو بار بپرسید، ممکن است دو پاسخ متفاوت بگیرید. این ویژگی برای طوفان فکری مفید است، اما برای کارهایی که به ثبات نیاز دارند (مثل کدگذاری دادههای کیفی) باید با دستورالعملهای دقیق، مثالهای مشخص و بازبینی انسانی کنترل شود.
مفهوم سوم «آموزش تکمیلی» است. مدلهای امروزی پس از آموزش اولیه روی حجم عظیمی از متن، با بازخورد انسانی تنظیم میشوند تا پاسخهایشان مفیدتر و ایمنتر شود. این تنظیم باعث میشود مدلها مؤدب و همراه به نظر برسند و گاهی تمایل داشته باشند با کاربر موافقت کنند. پس اگر از مدل بپرسید «آیا استدلال من درست است؟»، احتمال دارد پاسخ مثبت بگیرید؛ بهتر است بپرسید «سه ضعف جدی این استدلال چیست؟»
نتیجهٔ این فرایند، متنی است که از نظر زبانی بسیار طبیعی و قانعکننده به نظر میرسد. اما باید به خاطر داشته باشیم که مدل بر اساس الگوهای آماری زبان پاسخ میدهد، نه بر اساس بررسی حقیقت. به همین دلیل ممکن است با اطمینان کامل، مقالهای را که هرگز منتشر نشده یا آماری را که وجود ندارد، نقل کند. این پدیده را «توهم» (Hallucination) مینامند.
هرگز خروجی یک چتبات را بهعنوان منبع علمی نقل نکنید. هر ادعا، عدد یا ارجاعی را که از هوش مصنوعی میگیرید، باید در منبع اصلی (مقاله، کتاب یا پایگاه داده) پیدا و بررسی کنید.
درک این سازوکار، رفتار ما را هم تغییر میدهد. وقتی بدانیم مدل «پیشبینیکنندهٔ متن» است، طبیعی است که برای کارهای زبانی (بازنویسی، خلاصهسازی، ساختاردهی، طوفان فکری) به آن تکیه کنیم و برای کارهای مبتنی بر واقعیت (نقل آمار، ارجاع، تاریخ رویدادها) آن را با منابع معتبر کنترل کنیم. همچنین میفهمیم چرا کیفیت پرسش ما اهمیت دارد: هرچه زمینهٔ بیشتری بدهیم، پیشبینی مدل به نیاز ما نزدیکتر میشود.
کاربردهای هوش مصنوعی در پژوهش دانشگاهی؛ از ایده تا داوری
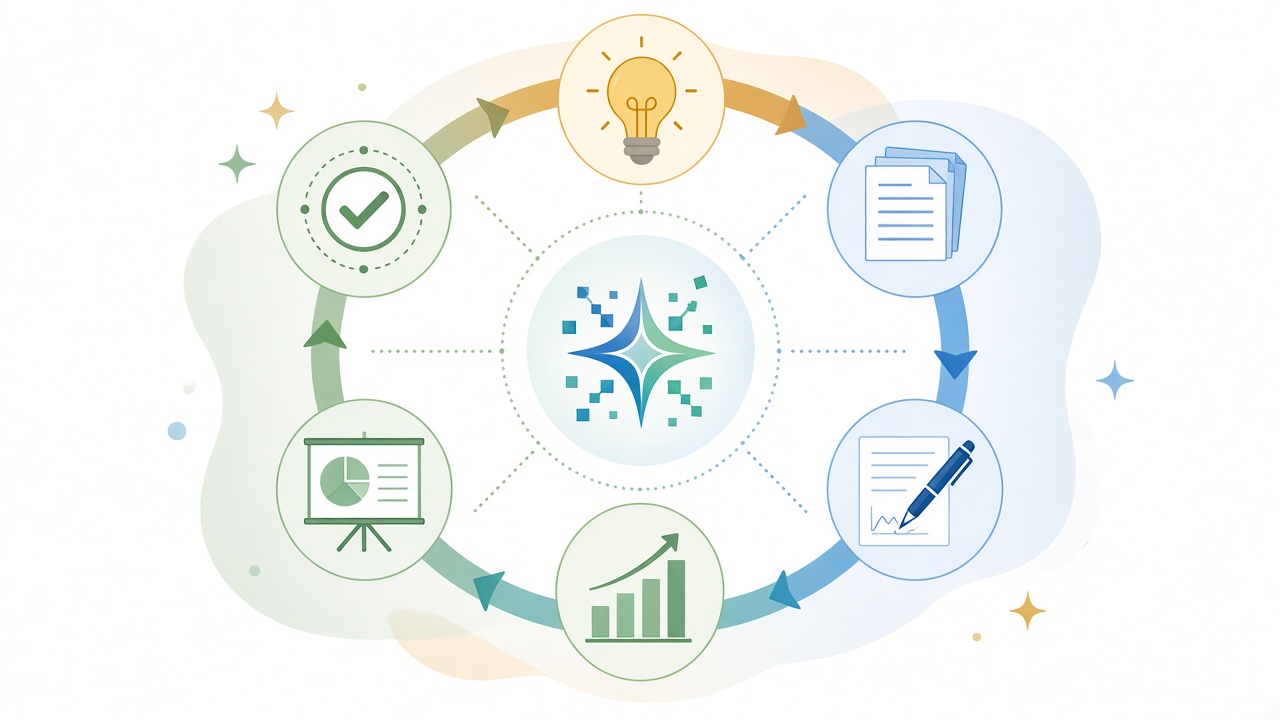
حالا که سازوکار کلی را میشناسیم، بیایید ببینیم هوش مصنوعی در پژوهش دانشگاهی دقیقاً کجا به کار میآید. کتاب در فصلهای بعدی هرکدام از این حوزهها را به تفصیل بررسی میکند؛ ما در اینجا نمایی کلی میدهیم و برای هر بخش به مقالهٔ تخصصی همین مجموعه پیوند میدهیم.
پژوهش، ایدهپردازی و مرور ادبیات
مرحلهٔ آغازین پژوهش معمولاً پرتنشترین بخش آن است. دانشجو باید موضوعی پیدا کند که هم تازه باشد، هم قابلاجرا، و هم مورد تأیید استاد راهنما. هوش مصنوعی در این مرحله میتواند به شکلهای زیر کمک کند:
- ایدهپردازی: پیشنهاد زاویههای تازه برای یک موضوع کلی و نشان دادن پیوندهای میانرشتهای.
- مرور سریع ادبیات: خلاصهسازی چکیدههایی که خودتان جمعآوری کردهاید و دستهبندی آنها بر اساس روش یا یافته.
- صورتبندی فرضیه: تبدیل یک شکاف پژوهشی به چند فرضیهٔ قابلآزمون.
- راهنمایی روششناختی: معرفی گزینههای طراحی پژوهش و مزایا و معایب هرکدام.
یک پرامپت نمونه برای این مرحله:
«من دانشجوی دکتری مدیریت آموزشی هستم و به موضوع “فرسودگی شغلی معلمان پس از آموزش مجازی” علاقه دارم. پنج زاویهٔ پژوهشی متفاوت پیشنهاد بده، برای هرکدام یک سؤال پژوهش و نوع طراحی مناسب (کمی، کیفی یا آمیخته) بنویس و بگو کدام زاویه احتمالاً کمتر پژوهش شده است. ارجاع نساز؛ فقط ایده بده.»
پس از دریافت پاسخ، کار اصلی شما شروع میشود. هر زاویهٔ پیشنهادی را با سه پرسش محک بزنید: آیا دادهٔ لازم برای این پژوهش در دسترس من است؟ آیا در بازهٔ زمانی دورهام قابلاجراست؟ و آیا استاد راهنمای من در این زمینه تخصص دارد؟ زاویهای که از هر سه آزمون عبور کند، ارزش جستوجوی جدی در پایگاههای علمی را دارد. ابزار در اینجا فقط فهرست گزینهها را گستردهتر کرده؛ انتخاب و توجیه همچنان کار شماست.
جملهٔ آخر این پرامپت مهم است. وقتی صراحتاً بخواهید ارجاع ساخته نشود، احتمال اینکه مدل منبع خیالی تولید کند کمتر میشود. جزئیات کامل این مرحله را در مقالهٔ طراحی پژوهش با هوش مصنوعی آوردهایم و اگر نیاز به همراهی تخصصی در مرور منابع دارید، صفحهٔ هوش مصنوعی در پژوهش را ببینید.
نگارش، ویرایش و انتشار مقاله
نوشتن، بخشی از پژوهش است که بیشترین استفاده از ابزارهای مولد در آن رخ میدهد. کتاب نشان میدهد که هوش مصنوعی در کل چرخهٔ نگارش حضور دارد: از غلبه بر «ترس از صفحهٔ سفید» تا ساختاردهی استدلال، ویرایش زبانی، قالببندی ارجاعها و آمادهسازی نامهٔ پوششی.
برای پژوهشگر ایرانی که مقاله را به انگلیسی مینویسد، این ابزارها بهویژه در سه زمینه ارزشمندند:
- روانی زبان: اصلاح ساختارهای ترجمهای و جملههای طولانی که از فارسی به انگلیسی منتقل شدهاند.
- انسجام متن: پیشنهاد جملههای انتقالی میان بندها و بخشها.
- داوری شبیهسازیشده: دریافت نقد از دید یک داور فرضی پیش از ارسال به مجله.
یک الگوی کاری ساده که بسیاری از پژوهشگران موفق به کار میبرند، «نوشتن با دست خود، صیقل با ابزار» است. ابتدا پیشنویس هر بخش را، حتی اگر ناپخته و پر از اشکال زبانی باشد، خودتان بنویسید. سپس از ابزار بخواهید فقط روانی و دستور زبان را اصلاح کند و تغییراتش را فهرست کند. در نهایت تغییرات را یکییکی بپذیرید یا رد کنید. این روش هم ایدهها را مال شما نگه میدارد و هم یادگیری زبان علمی انگلیسی را تقویت میکند، چون هر اصلاح را آگاهانه میبینید.
همچنین میتوانید از ابزار بخواهید پیش از ویرایش، ساختار استدلال شما را نقد کند: «بند به بند بگو ادعای اصلی هر بند چیست و آیا شواهد کافی برای آن آوردهام یا نه.» این نوع بازخورد ساختاری اغلب ارزشمندتر از اصلاح واژههاست، زیرا ضعفهایی را نشان میدهد که داور مجله هم به آنها اشاره خواهد کرد.
اما همینجا خطر هم بیشتر است. ارجاعهای ساختگی، از دست رفتن «صدای علمی» نویسنده و متنهای یکنواخت و کلیشهای، از مشکلات رایج هستند. مقالهٔ ویرایش مقاله با هوش مصنوعی این چالشها را با جزئیات بررسی میکند و راهنمای قدیمیتر ما دربارهٔ استفاده از ChatGPT در مقاله هم نکات تکمیلی دارد.
پیش از ارسال مقاله، سیاست مجلهٔ هدف دربارهٔ هوش مصنوعی را بخوانید. بسیاری از ناشران، مانند Nature، اجازهٔ ذکر هوش مصنوعی بهعنوان نویسنده را نمیدهند و اعلام استفاده در بخش روش یا تقدیر را الزامی میدانند.
تحلیل داده، ارائه، آموزش و امور اداری
کاربرد هوش مصنوعی در پژوهش دانشگاهی به نوشتن محدود نمیشود. چند حوزهٔ دیگر که کتاب به آنها میپردازد:
- مدیریت و تحلیل داده: پاکسازی دادههای پرسشنامه، یکپارچهسازی منابع داده، تحلیل اکتشافی و تولید کد. جزئیات در تحلیل داده با هوش مصنوعی.
- ارائه و انتقال دانش: ساخت اسلاید برای دفاع یا همایش، سادهسازی مفاهیم فنی برای مخاطب عمومی و تولید نسخههای مختلف یک ارائه برای مخاطبان متفاوت. جزئیات در ساخت پاورپوینت با هوش مصنوعی.
- آموزش: طراحی طرح درس، تولید سؤال امتحانی و روبریک ارزیابی.
- امور اداری: خلاصهسازی ایمیلها، نوشتن پیشنویس گزارشها و صورتجلسهها.
- داوری و ارزیابی: کمک به ساختاردهی نظر داوری؛ البته با محدودیتهای جدی دربارهٔ محرمانگی.
دربارهٔ داوری، احتیاط بیشتری لازم است. کتاب در فصلهای بعدی توضیح میدهد که بارگذاری مقالهٔ داورینشده در یک ابزار عمومی، ممکن است محرمانگی فرایند داوری را نقض کند. بسیاری از ناشران و نهادهای تأمین مالی صراحتاً این کار را ممنوع کردهاند. اما داور میتواند از ابزار برای کارهای بیخطرتر کمک بگیرد؛ مثلاً ساختاردهی یادداشتهای خودش یا روانتر کردن متن نظر داوری، بدون وارد کردن محتوای مقاله.
جدول زیر خلاصهای از سطح ریسک کاربردهای رایج است:
| کاربرد | سطح ریسک | شرط استفادهٔ امن |
|---|---|---|
| طوفان فکری و ایدهپردازی | کم | ارزیابی انتقادی ایدهها |
| ویرایش زبانی متن خودتان | کم تا متوسط | حفظ معنا و اعلام استفاده |
| خلاصهسازی مقالات | متوسط | خواندن مقالهٔ اصلی برای بخشهای کلیدی |
| پیشنهاد ارجاع | زیاد | تطبیق تکتک ارجاعها با منبع اصلی |
| تحلیل آماری | زیاد | اجرای تحلیل در نرمافزار و بررسی متخصص |
| داوری مقالهٔ دیگران | بسیار زیاد | عدم بارگذاری متن محرمانه |
نکتهٔ مشترک همهٔ این کاربردها این است که بهترین نتیجه از همکاری به دست میآید، نه واگذاری. ابزار، پیشنویس میدهد؛ انسان، داوری میکند، اصلاح میکند و مسئولیت را میپذیرد.
یک مثال ملموس: فرض کنید عضو هیئت علمی هستید و باید برای درس «روش تحقیق» یک تمرین طراحی کنید. میتوانید از ابزار بخواهید سه سناریوی پژوهشی واقعینما بسازد که دانشجو باید برای هرکدام طرح نمونهگیری مناسب پیشنهاد دهد. سپس خودتان سناریوها را بازبینی کنید، با بافت ایران تطبیق دهید و معیار نمرهدهی را تنظیم کنید. در این حالت ابزار ساعتها در وقت شما صرفهجویی کرده، اما کیفیت آموزشی را خودتان تضمین کردهاید.
استفاده مسئولانه: چارچوبی عملی برای پژوهشگر ایرانی
کتاب از همان فصل نخست روشن میکند که هدفش نه تبلیغ ابزارهاست و نه هراسافکنی. رویکرد آن «متوازن» است: فرصتها را جدی میگیرد و خطرها را هم. در این بخش، این رویکرد را به یک چارچوب عملی برای دانشجو و پژوهشگر ایرانی تبدیل میکنیم.
محدودیتها: توهم، سوگیری و دانش کهنه
پیش از هر استفاده، باید محدودیتهای ابزار را بشناسیم. مهمترین آنها عبارتاند از:
- توهم (ساختن اطلاعات): تولید ارجاع، آمار یا نقلقولی که وجود ندارد.
- سوگیری: بازتولید سوگیریهای موجود در دادههای آموزشی؛ مثلاً برجستهکردن پژوهشهای غربی و انگلیسیزبان و کمدیدهشدن پژوهشهای بومی.
- دانش کهنه یا ناقص: مدلها تا تاریخ مشخصی آموزش دیدهاند و ممکن است از تحولات اخیر حوزهٔ شما بیخبر باشند.
- تحلیل سطحی: خلاصههایی که ظرافتهای روششناختی یا بحثهای نظری را حذف میکنند.
- خطای کمی: اشتباه در محاسبه یا تفسیر آماری، چون مدلهای زبانی ذاتاً ماشین حساب نیستند.
برای دانشجوی ایرانی یک محدودیت دیگر هم وجود دارد: کیفیت پاسخ به فارسی معمولاً پایینتر از انگلیسی است، بهویژه در اصطلاحات تخصصی. یک راهکار ساده این است که پرسشهای فنی را به انگلیسی بپرسید و سپس خروجی را خودتان به فارسی بازنویسی کنید؛ یا دستکم معادل انگلیسی اصطلاحات کلیدی را در پرامپت بیاورید.
برای سنجش این محدودیتها در حوزهٔ خودتان، یک «آزمون سهمرحلهای» پیشنهاد میکنیم. در مرحلهٔ اول، از ابزار بخواهید پنج مقالهٔ مهم حوزهٔ شما را با مشخصات کامل معرفی کند. در مرحلهٔ دوم، تکتک آنها را در پایگاههای علمی جستوجو کنید و ببینید چند مورد واقعاً وجود دارند و مشخصاتشان درست است. در مرحلهٔ سوم، از ابزار بخواهید یافتهٔ اصلی یکی از مقالههایی را که خودتان خوب میشناسید خلاصه کند و دقت آن را بسنجید.
نتیجهٔ این آزمون معمولاً برای دانشجویان آموزنده است. بسیاری متوجه میشوند که حتی وقتی نام نویسندگان واقعی است، عنوان یا سال مقاله ساختگی است؛ یا خلاصهها جهت یافته را برعکس گزارش کردهاند. این تجربهٔ شخصی، بهتر از هر هشداری، عادت راستیآزمایی را در شما تثبیت میکند.
دادههای خام پژوهش، اطلاعات هویتی شرکتکنندگان، متن مقالهٔ داورینشدهٔ دیگران و پروپوزالهای محرمانه را در ابزارهای عمومی وارد نکنید. این کار ممکن است با اصول محرمانگی و کدهای اخلاق پژوهش در تعارض باشد.
اصول شفافیت، اعلام استفاده و حفظ صدای علمی
پس از شناخت محدودیتها، نوبت قواعد رفتاری است. نهادهای معتبری مانند COPE و یونسکو در این زمینه رهنمود منتشر کردهاند. خلاصهٔ عملی آنها را میتوان در پنج اصل گفت:
- مسئولیت با انسان است: هوش مصنوعی نمیتواند نویسنده باشد، چون نمیتواند مسئولیت محتوا را بپذیرد.
- شفافیت: نوع ابزار، نسخه و نحوهٔ استفاده را در بخش روش، تقدیر یا یادداشت مخصوص اعلام کنید.
- راستیآزمایی: هر واقعیت، عدد و ارجاع را با منبع اصلی تطبیق دهید.
- حفظ صدای علمی: متن نهایی باید استدلال، سبک و دیدگاه شما را منعکس کند.
- پیروی از قوانین محلی: آییننامهٔ دانشگاه، دستورالعمل استاد راهنما و سیاست مجلهٔ هدف را بشناسید.
برای روشنتر شدن مرزها، میتوان کاربردها را در سه دسته قرار داد. دستهٔ «معمولاً مجاز» شامل ویرایش زبانی، رفع اشکالات دستوری، توضیح مفاهیم و ایدهپردازی است. دستهٔ «خاکستری» شامل تولید پیشنویس بخشهایی از متن، خلاصهسازی منابع و پیشنهاد ساختار استدلال است که بسته به سیاست دانشگاه و مجله ممکن است نیاز به اعلام یا اجازه داشته باشد. دستهٔ «ممنوع» شامل ساختن یا دستکاری داده، جعل ارجاع، ارائهٔ متن تولیدشده بدون بازنویسی بهعنوان کار خود، و استفاده از ابزار در آزمونهایی است که صریحاً ممنوع شده است.
قرار گرفتن یک کاربرد در دستهٔ خاکستری به معنای ممنوعیت نیست؛ بلکه یعنی باید پیش از استفاده سؤال کنید و پس از استفاده شفاف باشید. هر جا تردید دارید، اعلام کنید؛ هزینهٔ شفافیت همیشه از هزینهٔ پنهانکاری کمتر است.
یک نمونه متن اعلام استفاده برای مقالهٔ انگلیسی میتواند اینگونه باشد: «The authors used [tool name and version] to improve the readability of the manuscript. All content was reviewed and edited by the authors, who take full responsibility for the final text.» توجه کنید که این جمله را باید با استفادهٔ واقعی خودتان تطبیق دهید. برای جزئیات بیشتر دربارهٔ مرزهای اخلاقی، صفحهٔ صداقت علمی و مقالهٔ اخلاق هوش مصنوعی در پژوهش را بخوانید.
حفظ «صدای علمی» فقط یک توصیهٔ سبکی نیست. داوران و استادان باتجربه، متنهای یکنواخت و قالبی را تشخیص میدهند و همین ممکن است اعتماد آنها را به کل کار شما کاهش دهد.
نقشهٔ راه شروع: برنامهٔ سیروزه برای دانشجو
اگر تا امروز استفادهٔ پراکندهای از ابزارها داشتهاید، این برنامهٔ چهارهفتهای کمک میکند به شکل نظاممند شروع کنید:
هفتهٔ اول: آشنایی و آزمایش
- یک ابزار عمومی (مثلاً ChatGPT یا Claude) و یک ابزار تخصصی مقالهیاب را انتخاب کنید.
- ده پرسش از حوزهٔ تخصصی خودتان بپرسید که پاسخش را میدانید و دقت پاسخها را بسنجید.
- یادداشتی از خطاها و نقاط قوت هر ابزار تهیه کنید.
هفتهٔ دوم: پرامپتنویسی
- ساختار پرامپت خوب را تمرین کنید: نقش، زمینه، وظیفه، قالب خروجی و محدودیتها.
- از بانک پرامپتهای پژوهشی الگو بگیرید و آنها را برای موضوع خودتان شخصیسازی کنید.
هفتهٔ سوم: یک پروژهٔ کوچک واقعی
- یک مرور ادبیات کوچک (ده تا پانزده مقاله) را با کمک ابزار سازماندهی کنید.
- همهٔ ارجاعها را دستی در Google Scholar بررسی کنید.
- پیشنویس را با صدای خودتان بازنویسی کنید.
هفتهٔ چهارم: بازبینی و مستندسازی
- فایلی از پرامپتها و خروجیهای مهم بسازید.
- با استاد راهنما دربارهٔ حدود مجاز استفاده گفتوگو کنید.
- متن اعلام استفادهٔ استاندارد خودتان را آماده کنید.
در پایان این ماه، باید بتوانید به چند پرسش پاسخ روشن بدهید: کدام کارها را با ابزار سریعتر و بهتر انجام میدهید؟ کدام خروجیها بیشترین خطا را داشتند؟ چقدر زمان صرف راستیآزمایی کردید؟ و آیا متن نهایی هنوز صدای شما را دارد؟ پاسخ صادقانه به این پرسشها، برنامهٔ ماه بعد شما را مشخص میکند. ممکن است متوجه شوید که برای خلاصهسازی ابزار عالی است، اما برای نوشتن بحث و نتیجهگیری ترجیح میدهید خودتان کار کنید. چنین شناختی، دقیقاً همان سوادی است که کتاب از آن سخن میگوید.
برای آموزشهای جامعتر دربارهٔ ساختن این مهارتها، مقالهٔ آموزش هوش مصنوعی برای دانشجویان را در همین مجموعه ببینید. مهارتهایی که در این چهار هفته میسازید، پایهٔ همهٔ کاربردهای پیشرفتهتری است که در قسمتهای بعدی مجموعه معرفی میکنیم.
یک «دفترچهٔ هوش مصنوعی» داشته باشید: تاریخ، ابزار، پرامپت، خلاصهٔ خروجی و تصمیمی که گرفتید. این دفترچه هم یادگیری شما را سریعتر میکند و هم در صورت پرسش استاد یا داور، شفافیت کارتان را ثابت میکند.
سؤالات متداول
آیا استفاده از هوش مصنوعی در پایاننامه یا مقاله تقلب محسوب میشود؟
نه لزوماً. استفاده برای ایدهپردازی، ویرایش زبانی، خلاصهسازی منابعی که خودتان خواندهاید یا توضیح مفاهیم معمولاً پذیرفته است؛ به شرط آنکه با قوانین دانشگاه و مجله همخوان باشد و در صورت لزوم اعلام شود. اما ارائهٔ متن تولیدشده توسط ابزار بهعنوان کار فکری خودتان، ساختن داده یا ارجاع، و پنهان کردن استفاده، نقض صداقت علمی است.
کدام ابزار برای شروع مناسبتر است؟
برای شروع، یک دستیار عمومی برای کارهای زبانی و یک ابزار مقالهمحور برای یافتن منابع واقعی کافی است. مهمتر از نام ابزار، یادگیری اصول پرامپتنویسی و راستیآزمایی است، چون این مهارتها با تغییر ابزارها کهنه نمیشوند.
آیا میتوانم به ارجاعهایی که چتبات میدهد اعتماد کنم؟
خیر، مگر اینکه خودتان آنها را در منبع اصلی پیدا کنید. حتی ابزارهایی که به اینترنت متصلاند هم گاهی مقاله را اشتباه خلاصه میکنند یا جزئیات کتابشناختی را نادرست مینویسند. همیشه DOI، نام نویسندگان، سال و مجله را تطبیق دهید.
آیا پاسخدادن به فارسی کیفیت کمتری دارد؟
معمولاً بله، بهویژه برای مفاهیم تخصصی. پیشنهاد ما این است که اصطلاحات کلیدی را به انگلیسی هم بنویسید و برای کارهای فنی از پرامپت انگلیسی استفاده کنید؛ سپس متن نهایی را خودتان به فارسی روان و دقیق بازنویسی کنید.
چطور استفاده از هوش مصنوعی را در مقاله اعلام کنم؟
نام ابزار، نسخه و هدف استفاده (مثلاً بهبود خوانایی یا ترجمه) را در بخش روش یا تقدیر بنویسید و تأکید کنید که نویسندگان محتوا را بررسی کردهاند و مسئولیت آن را میپذیرند. شکل دقیق این بخش را از راهنمای نویسندگان مجلهٔ هدف بگیرید.
جمعبندی
هوش مصنوعی در پژوهش دانشگاهی یک ابزار ساده نیست؛ دگرگونیای است که شیوهٔ ایدهپردازی، نوشتن، تحلیل، آموزش و داوری را تغییر میدهد. فصل نخست کتاب Using AI in Academic Writing and Research به ما یادآوری میکند که برای استفادهٔ درست، به دو چیز نیاز داریم: فهم فنی از اینکه این مدلها چگونه کار میکنند، و چارچوب اخلاقی برای اینکه بدانیم کجا باید متوقف شویم.
نویسندگان کتاب در پایان فصل نخست، مسیر بقیهٔ کتاب را ترسیم میکنند: از تاریخچه و تکامل فناوری تا کاربرد در پژوهش، نگارش، داده، ارائه، روندهای آینده، نکات عملی و چارچوبهای اخلاقی و حقوقی. ما هم در این مجموعه همین مسیر را دنبال میکنیم، اما با تمرکز بر نیازهای واقعی دانشجویان و پژوهشگران ایرانی؛ از محدودیتهای دسترسی و زبان گرفته تا آییننامههای دانشگاهی و الزامات مجلات بینالمللی. هدف این است که در پایان مجموعه، یک جعبهابزار کامل، اخلاقی و قابلدفاع در اختیار داشته باشید.
اگر قرار است فقط یک نکته از این مقاله با خود ببرید، این باشد: ابزار پیشنویس میدهد، اما مسئولیت علمی همیشه با شماست. از سرعت ابزار بهره ببرید، اما هر ادعا را بررسی کنید، استفاده را شفاف اعلام کنید و صدای علمی خودتان را حفظ کنید. برای همراهی تخصصی در هر مرحله از پژوهش، میتوانید از خدمات مشاوره پژوهشی ریسرچ اینتل کمک بگیرید و برای آمادهسازی نهایی مقاله، صفحهٔ انتشار مقاله را ببینید. در قسمت بعدی این مجموعه، به تاریخچه هوش مصنوعی از زمستان تا رنسانس میپردازیم و در قسمت پایانی، نگاهی به همکاری انسان و هوش مصنوعی خواهیم داشت.
برای آموزشها و مشاورههای بیشتر پژوهشی به هوش پژوهشی سر بزنید.
منابع
- Haber, E., Jemielniak, D., Kurasiński, A., & Przegalińska, A. (2025). *Using AI in Academic Writing and Research: A Complete Guide to Effective and Ethical Academic AI*. Springer Nature. فصل ۱: Introduction: Generative AI in Academia. https://doi.org/10.1007/978-3-031-91705-9
- Vaswani, A., et al. (2017). Attention Is All You Need. arXiv:1706.03762
- COPE. Authorship and AI tools – Position Statement
- UNESCO. Guidance for generative AI in education and research
- Nature Portfolio. Editorial policies: Artificial Intelligence (AI)